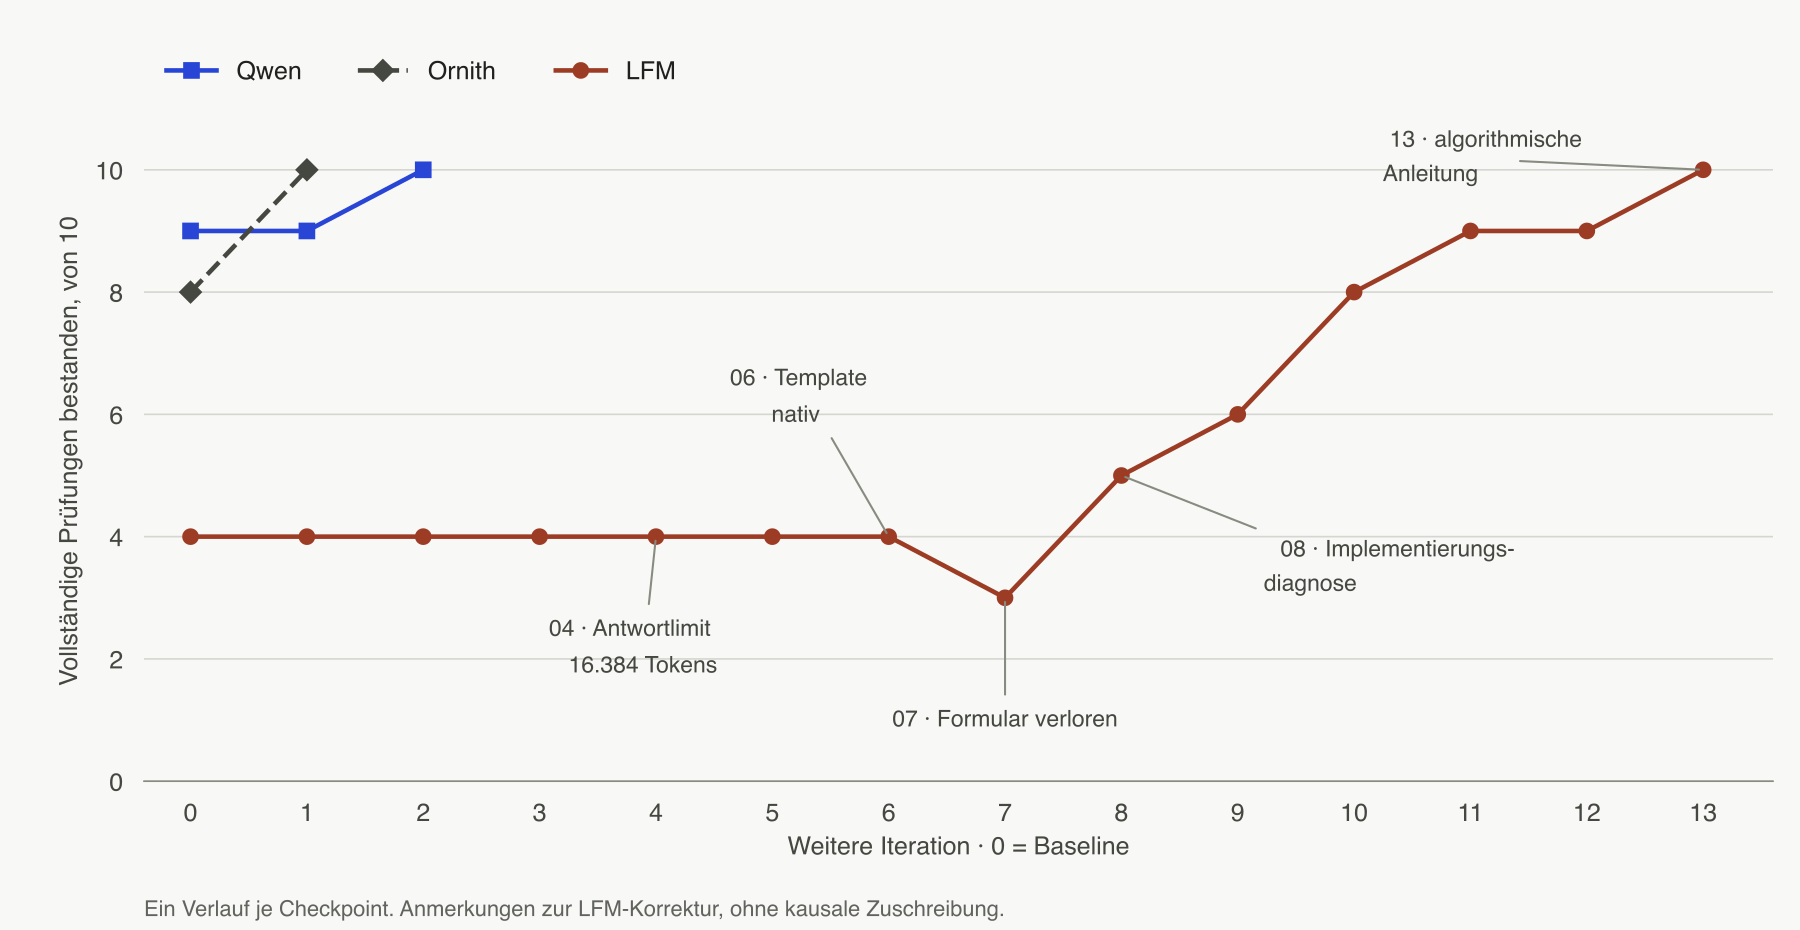
Ich habe drei lokale Modelle gebeten, dasselbe Portfolio zu erstellen. Am Ende bestanden alle zehn Funktionsprüfungen. Mein Urteil über die Websites blieb sehr unterschiedlich: Qwen ästhetisch am besten, Ornith sehr gut, LFM durchgefallen. Nach dem Versuch habe ich LFM deinstalliert.
Der Abstand zwischen diesen beiden Bewertungen ist der Grund, genauer hinzusehen. Ein Filter kann auf einer wenig überzeugenden Seite funktionieren. Eine gelungene Komposition kann vier nicht zu öffnende Projektkarten verbergen. Die Zeit bis zum Ergebnis hängt auch davon ab, wie viel Hilfe wir geben wollen.
Es folgt der Bericht eines Versuchs auf meinem Mac am 23. und 24. Oktober 2026: eine Aufgabe, ein dokumentierter Verlauf je getesteter Konfiguration. Dateien, fehlgeschlagene Schritte und Korrekturen wurden aufbewahrt. Bilder zeigen Veränderungen; Logs belegen, was ein Screenshot nicht nachweisen kann.
Ein erfundenes Portfolio, konkrete Anforderungen
Nora Valli ist eine erfundene Designerin. Auch die Arbeiten sind erfunden: Trame und Luce lenta für Editorial, Soglia und Orto urbano für Branding, Atlante und Marea für Digitales. Namen, Kategorien und Jahre waren vorgegeben. Die Modelle durften die Beschreibungen schreiben.
Gefordert waren drei funktionsfähige Dateien, HTML, CSS und JavaScript, ohne Frameworks, CDN oder externe Schriften. Suche und Filter mussten zusammenwirken, der Zähler den Ergebnissen folgen und der Leerzustand passend erscheinen. Jedes Projekt sollte stimmige Details mit Schließen, Escape und Fokusführung öffnen. Hinzu kamen ein dauerhaft gespeichertes Farbschema, Vorstellung, Demoformular und Layouts ohne Überlauf bei 390 und 1440 Pixeln.
Für die erste Fassung durfte jedes Modell ein Bild beim selben externen Generator anfordern. Es wählte Prompt und Platzierung der zurückgegebenen Datei. Die Pixel stammten von diesem Dienst; sie dem lokalen Modell zuzuschreiben würde zwei Arbeiten vermischen. Die drei Bilddateien blieben während der Korrekturen unverändert, wie der Vergleich ihrer Hashes bestätigt.
Ein KI-Assistent koordinierte den Versuch: Er richtete Werkzeuge und Prüfungen ein, schrieb Rückmeldungen und lieferte in späteren LFM-Phasen Diagnosen und algorithmische Hinweise. Die lokalen Modelle schrieben und änderten Dateien über kontrollierte Werkzeuge; sie hatten weder Browser noch Shell und sahen die Konkurrenz nicht. Die Portfolios wurden nicht von Hand korrigiert.
Den Dateizugriff ermöglichte Pi, ein Programmieragent, der Modellantworten mit Lese- und Schreibwerkzeugen verbindet. Die Modelle liefen mit MLX, einem Framework für Berechnungen auf Apple Silicon, über die beiden Backends der technischen Übersicht. Diese Software organisiert den Versuch; die Seiten wurden getrennt im Browser geprüft.
Der Mac und die Testumgebung
| Komponente | Konfiguration des verwendeten Rechners |
|---|---|
| Computer | MacBook Pro 16 Zoll, 2026; Modellkennung Mac17,8 |
| Prozessor | Apple M5 Pro |
| CPU | 18 Kerne: 6 Super-Kerne und 12 Performance-Kerne |
| GPU | 20 Kerne |
| RAM | 48 GB gemeinsamer Speicher; das System meldet 51.539.607.552 Byte, entsprechend 48 GiB |
| Speicherbandbreite | Laut Apple nominell 307 GB/s; in diesem Versuch nicht gemessen |
| Neural Engine | Laut Apple 16 Kerne; ihre Nutzung wird im Benchmark nicht gemessen |
| Betriebssystem | macOS 27.0.1, build 26A434 |
| Stromversorgung | Bei der ersten Erfassung am Stromnetz angeschlossen |
| Agent | Pi 1.2.0 |
| Runtime | Node 26.11.1; Python 3.15.0 für die Versuchsskripte |
| Prüfbrowser | Chrome 155.0.8059.85 |
| Qwen-Backend | mlx-vlm 0.6.15, MLX 0.32.1 |
| Backend für Ornith und LFM | mlx-lm 0.32.2, MLX 0.32.4 |
Chip, Speicher, Stromversorgung, System und GPU sind in den Versuchslogs dokumentiert. Das genaue Mac-Modell und die CPU-Kernaufteilung wurden durch eine spätere lokale Bestandsaufnahme ebenfalls am 24. Oktober ergänzt; Seriennummern und UUIDs fehlen bewusst. Die Kennung entspricht dem MacBook Pro 16 Zoll von 2026; Kernbezeichnungen und Nennwerte stammen aus den Apple-Spezifikationen.
Die Modelle liefen nacheinander. Der Mac erledigte auch andere Aufgaben; seine Last war nicht isoliert. Physische SSD-Kapazität, Energieverbrauch und thermische Leistung wurden nicht gemessen. Die nominelle Speicherbandbreite ist keine beobachtete Generierungsgeschwindigkeit.
| Bezeichnung im Bericht | Verwendeter Checkpoint | Revision |
|---|---|---|
| Qwen | orcarouter/Qwen3.8-27B-Uncensored-MLX, 4-Bit-Variante | 34c32b5b1b2c24181e121a5cba3df8924fa66bce |
| Ornith | ornith-ai/Ornith-1.5-35B-A3B-MLX-4bit | 19504d912fa8fc7622bf6b1de3db5d5d890b1f02 |
| LFM | LiquidAI/LFM2.5-24B-A2B-MLX-4bit | 667408d494bde191c2cb9dd4f4549827816b9275 |
Diese genauen Modellversionen, Checkpoints genannt, kennzeichnen die getesteten Konfigurationen. Sie sind keine austauschbaren Vertreter ganzer Modellfamilien. Die Kennungen wurden anhand der Repository-Karten der genannten Revisionen geprüft. Qwens Community-Name bleibt vollständig erhalten; Fähigkeiten, die das Wort „uncensored“ nahelegt, wurden hier nicht untersucht.
Drei visuelle Richtungen vor den Punktzahlen
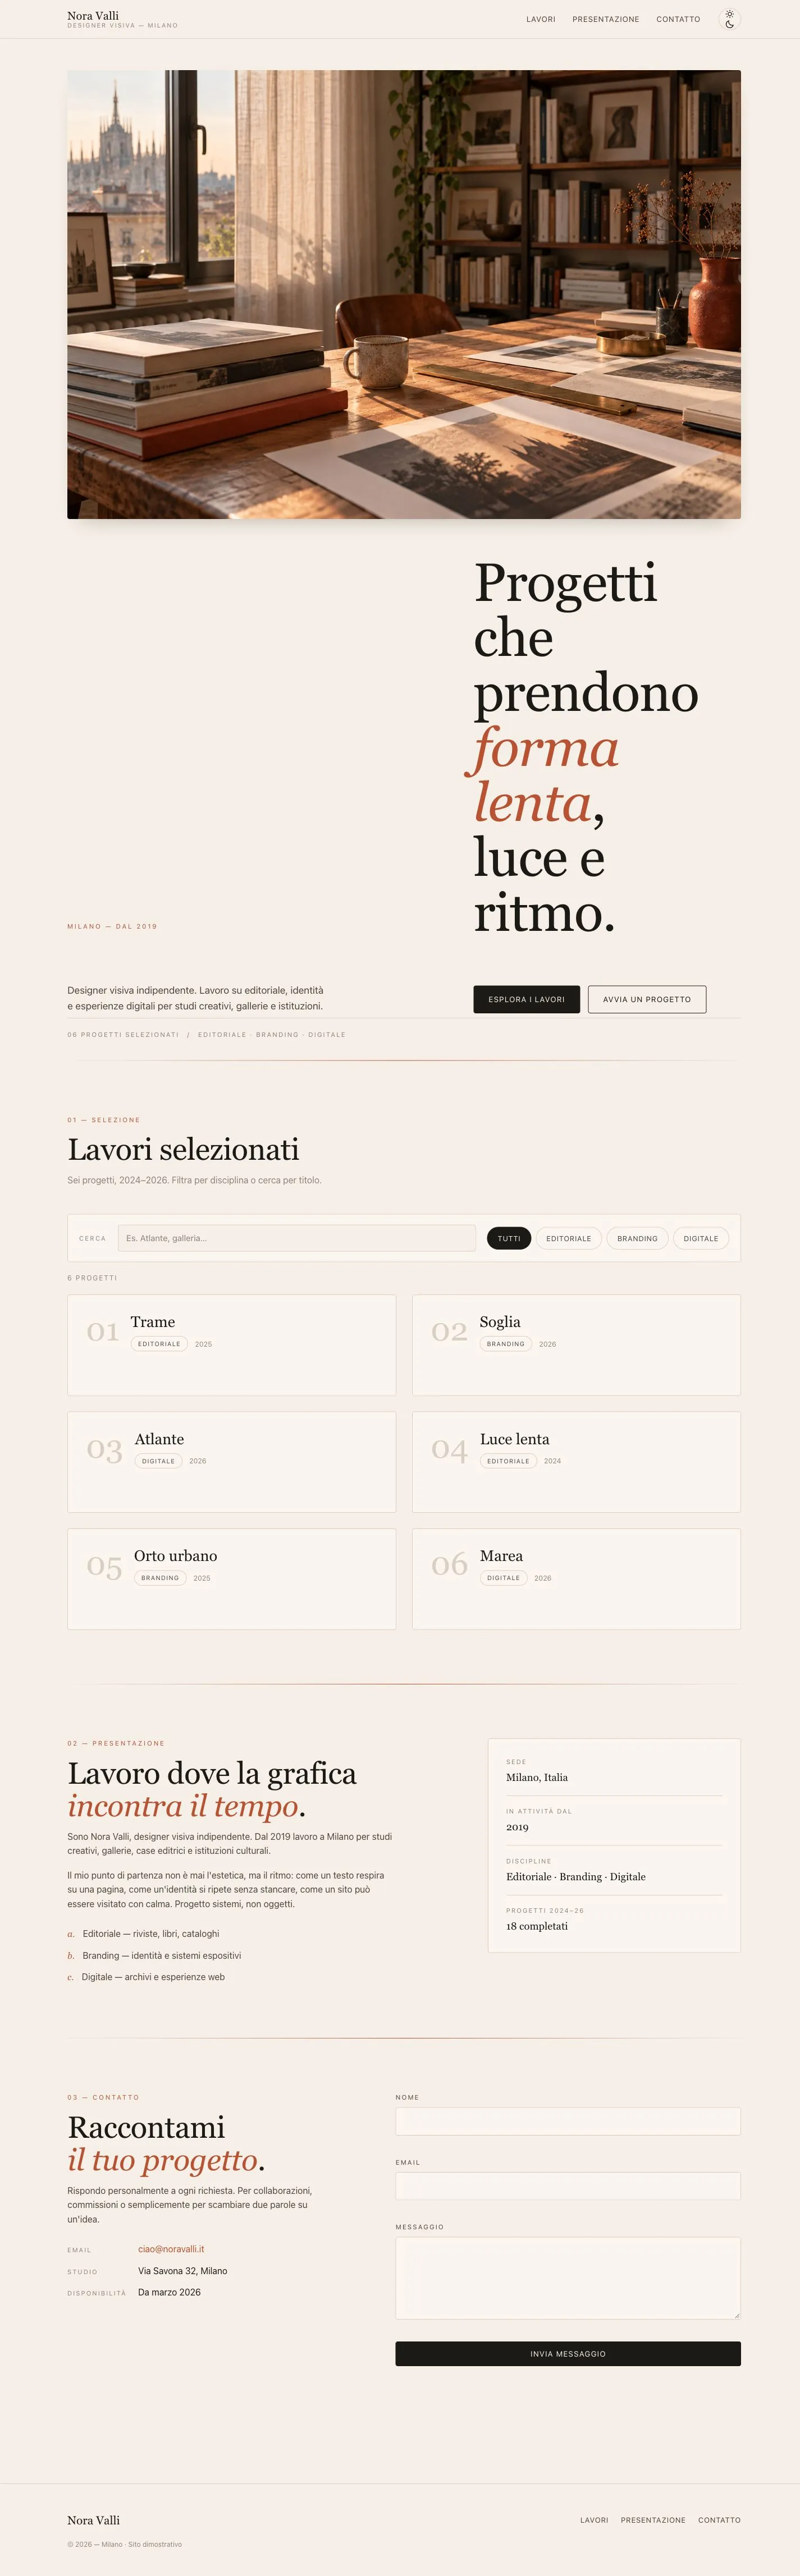
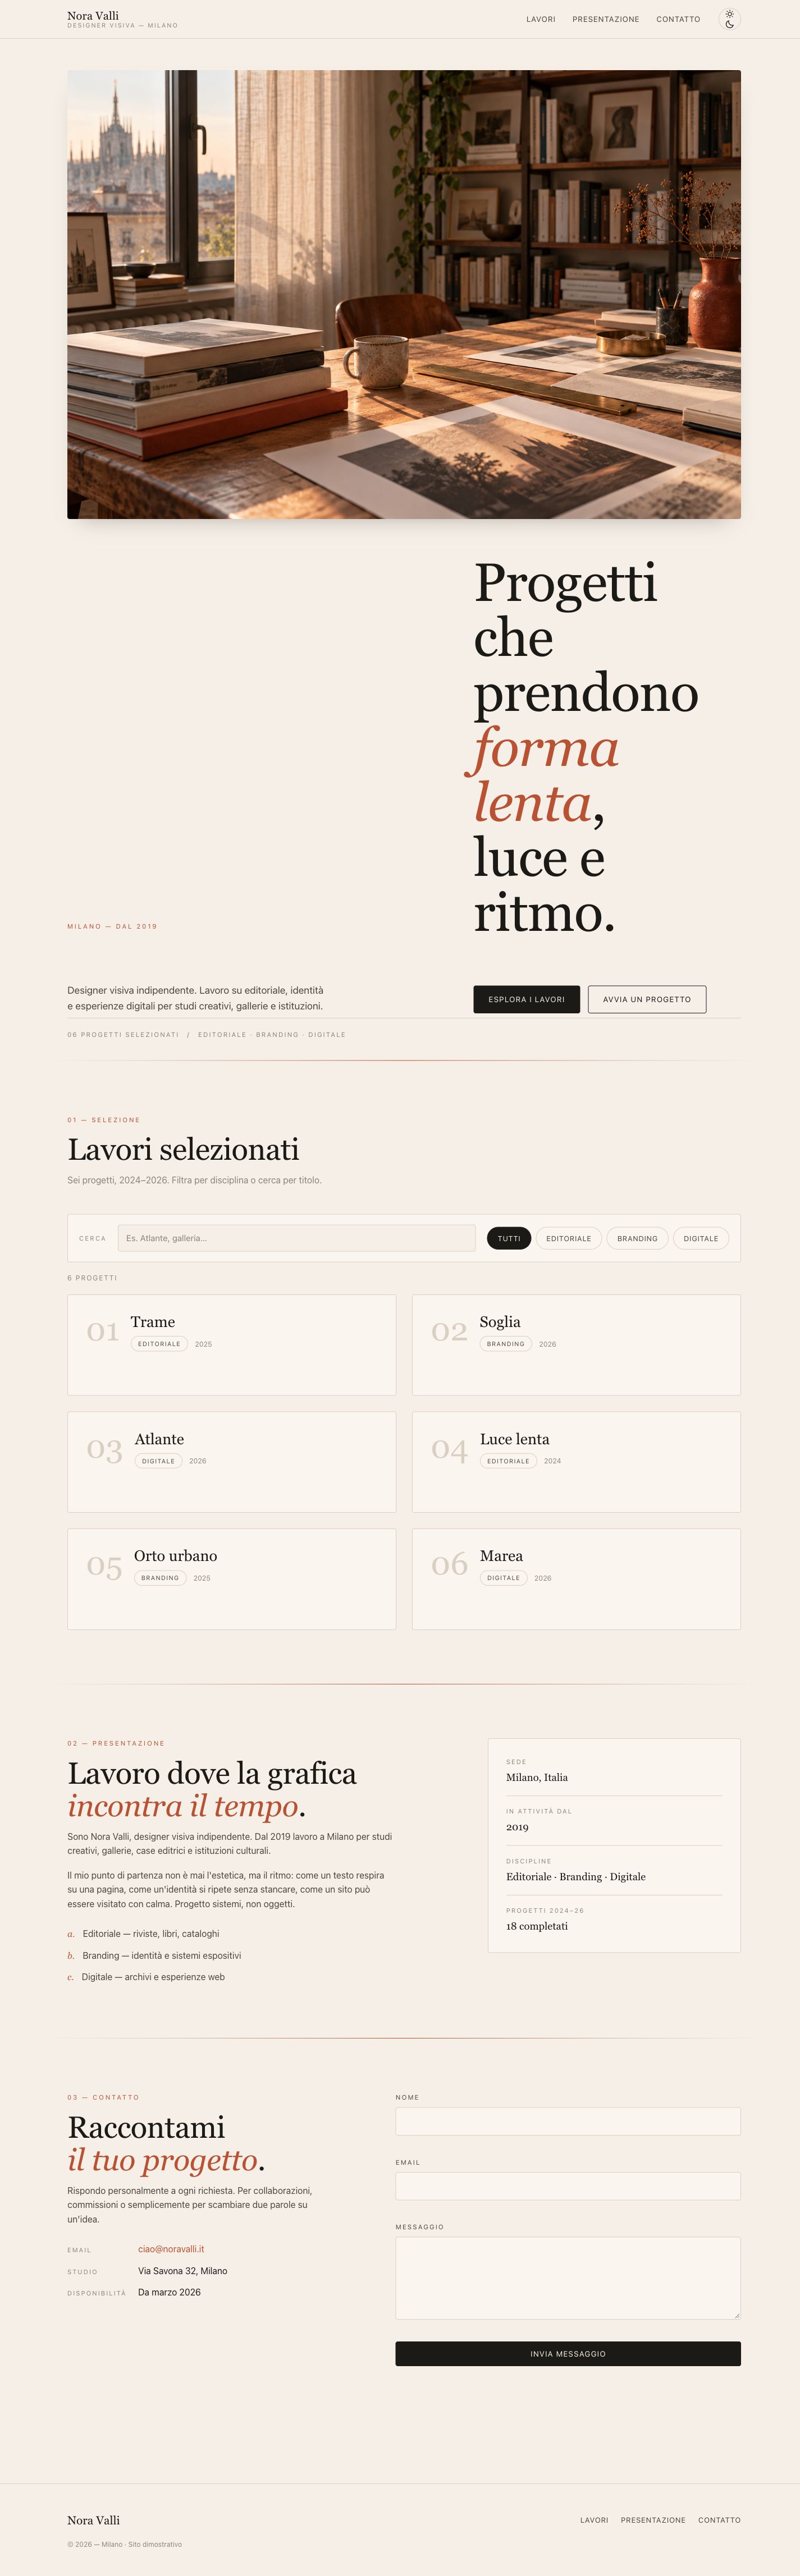
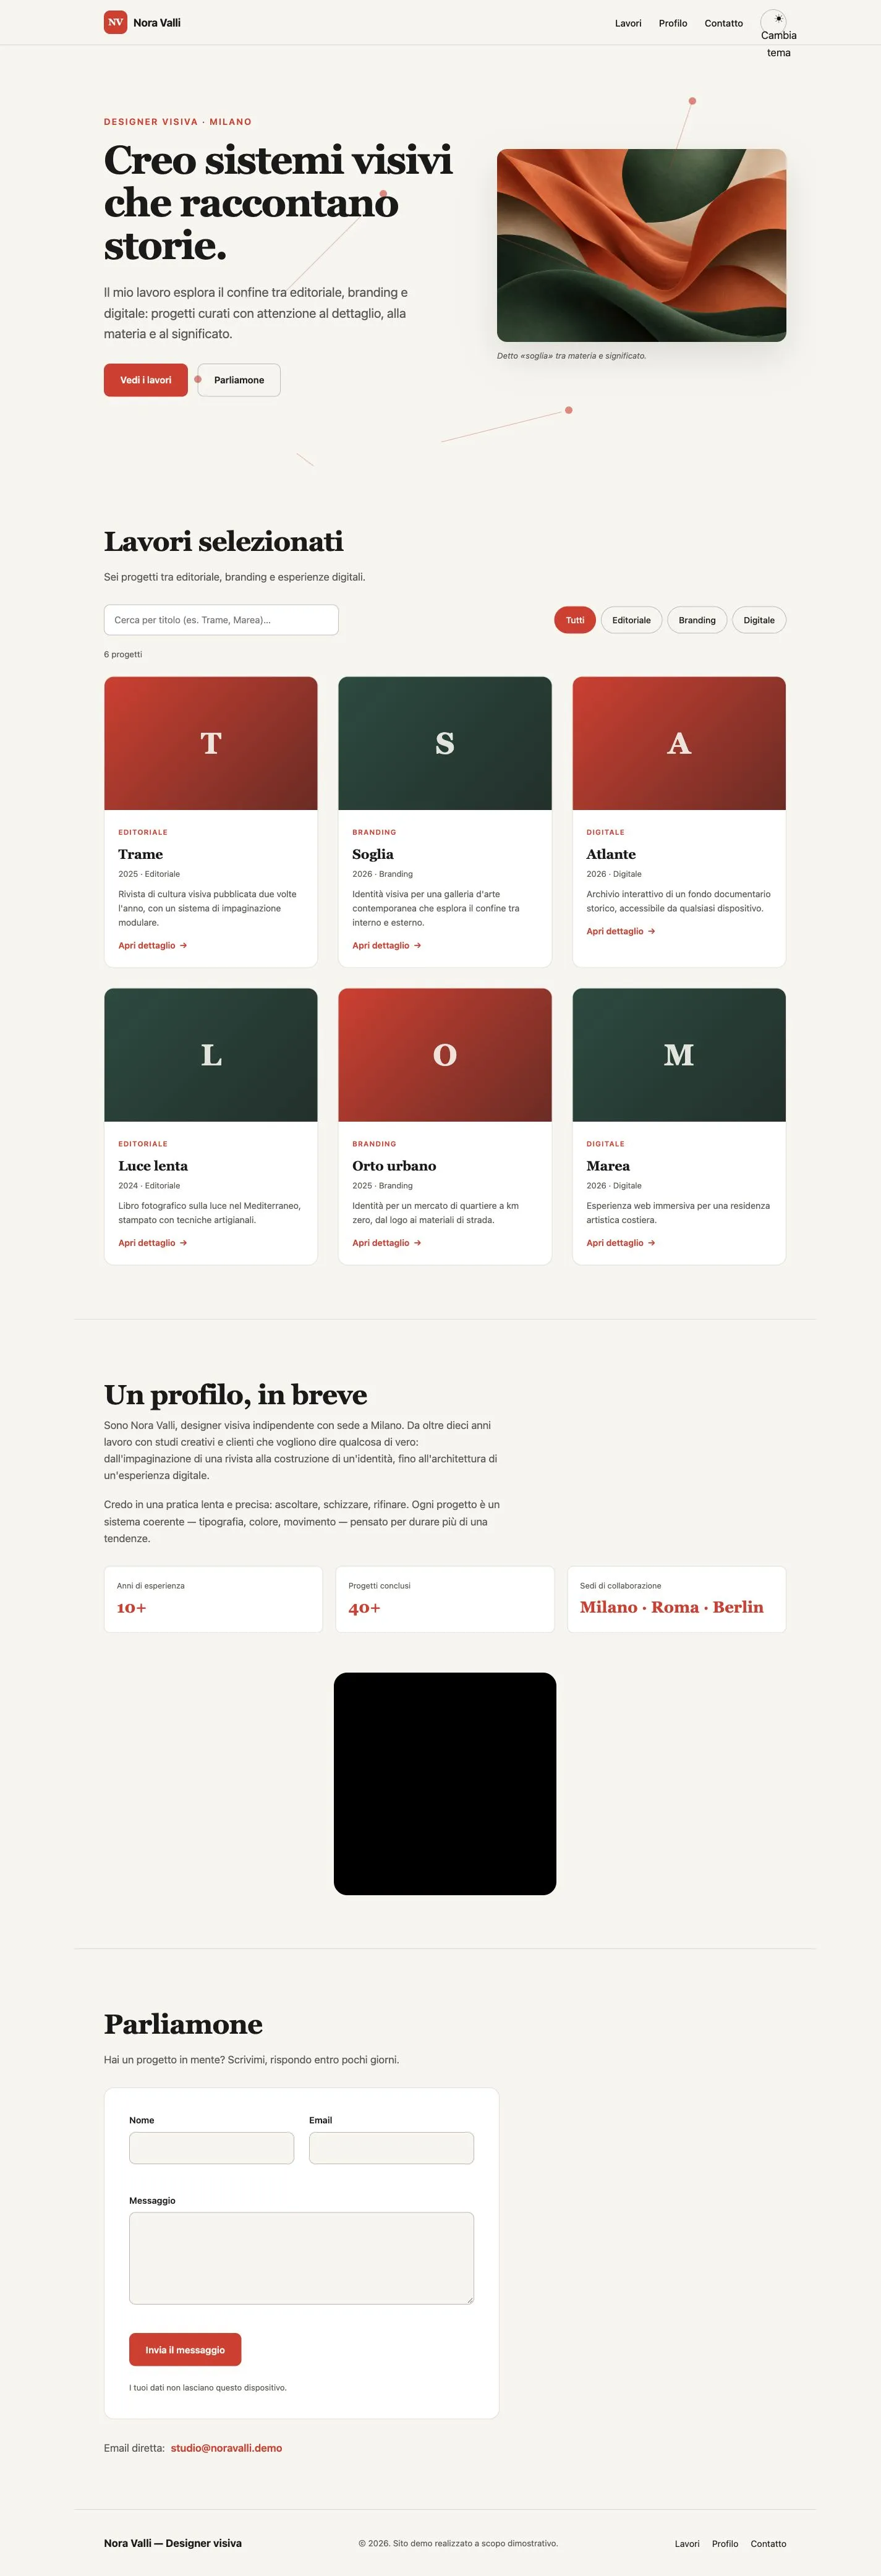
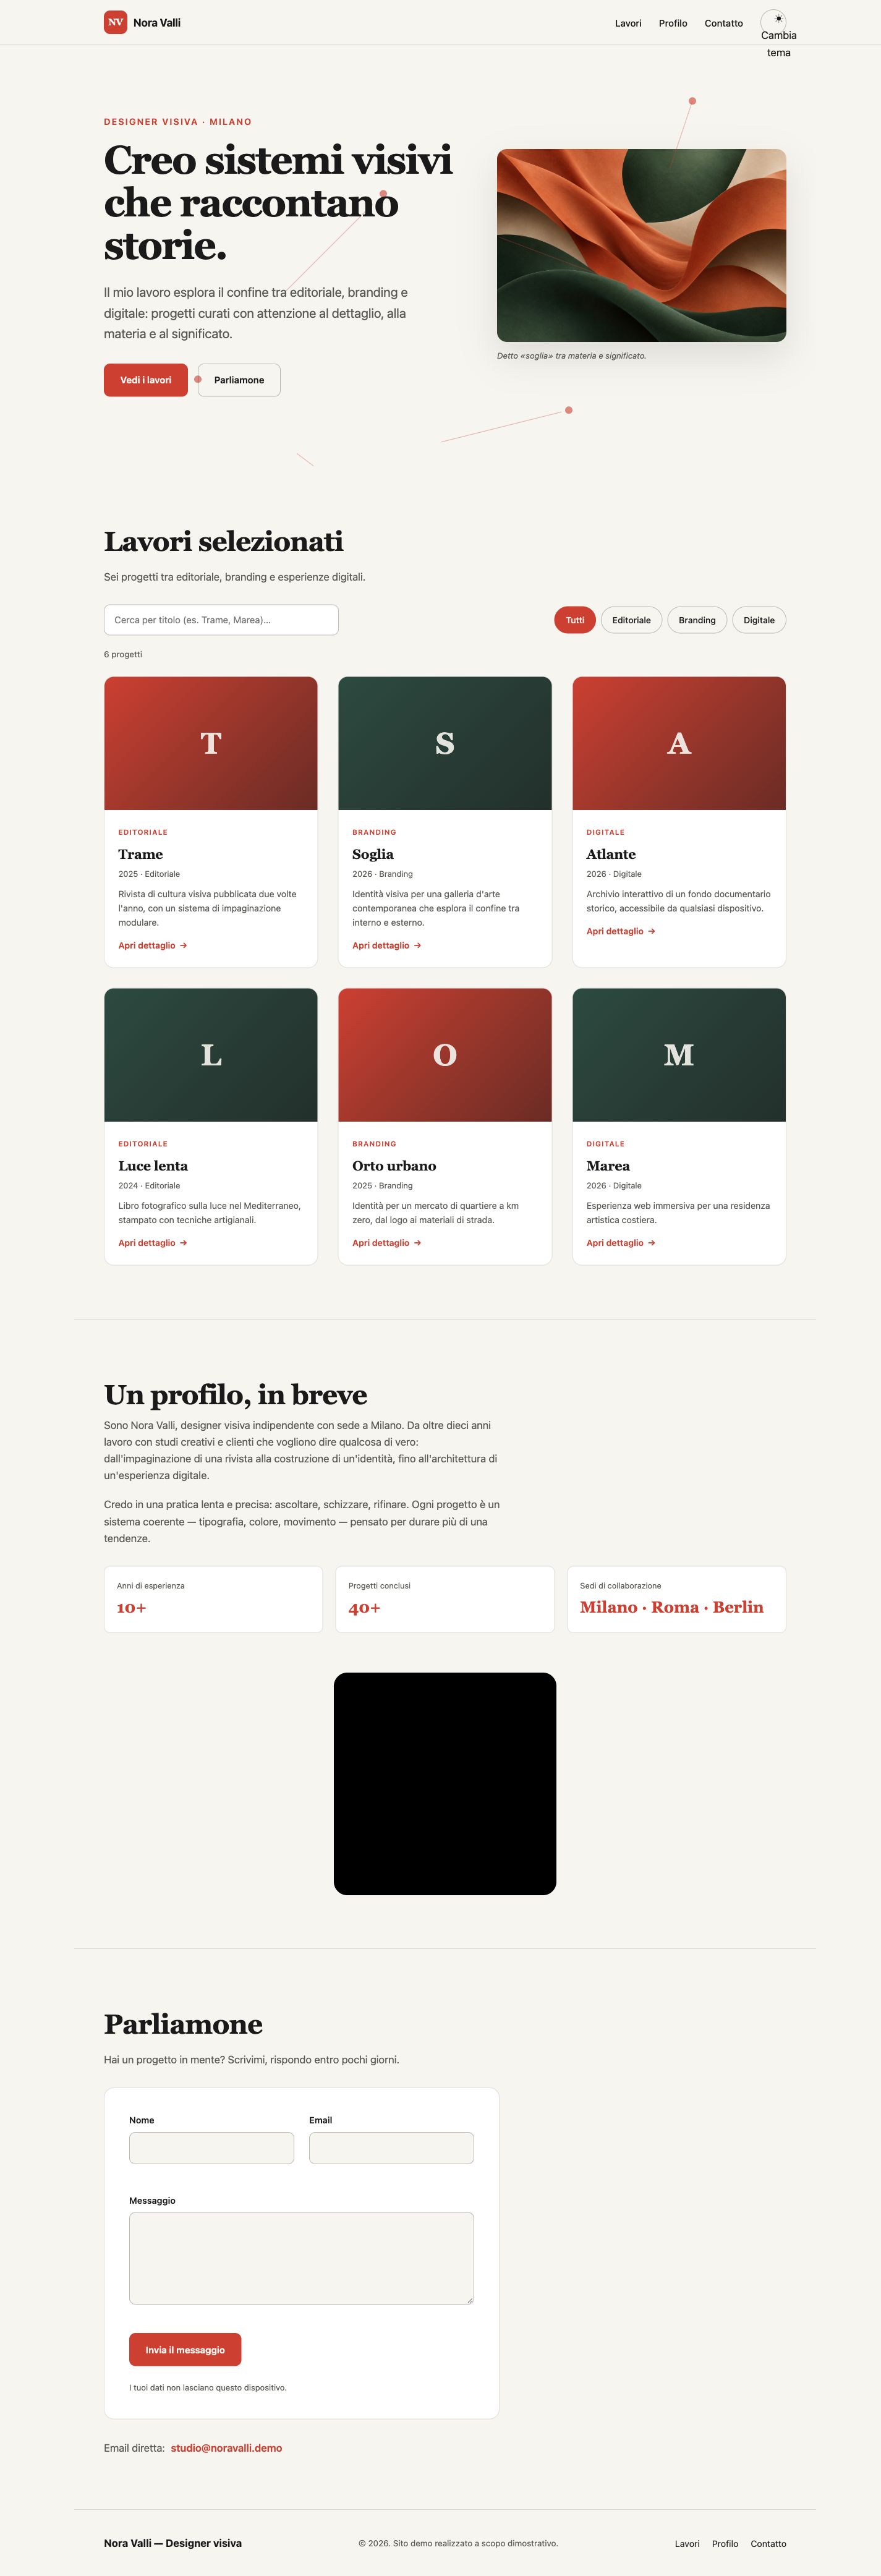
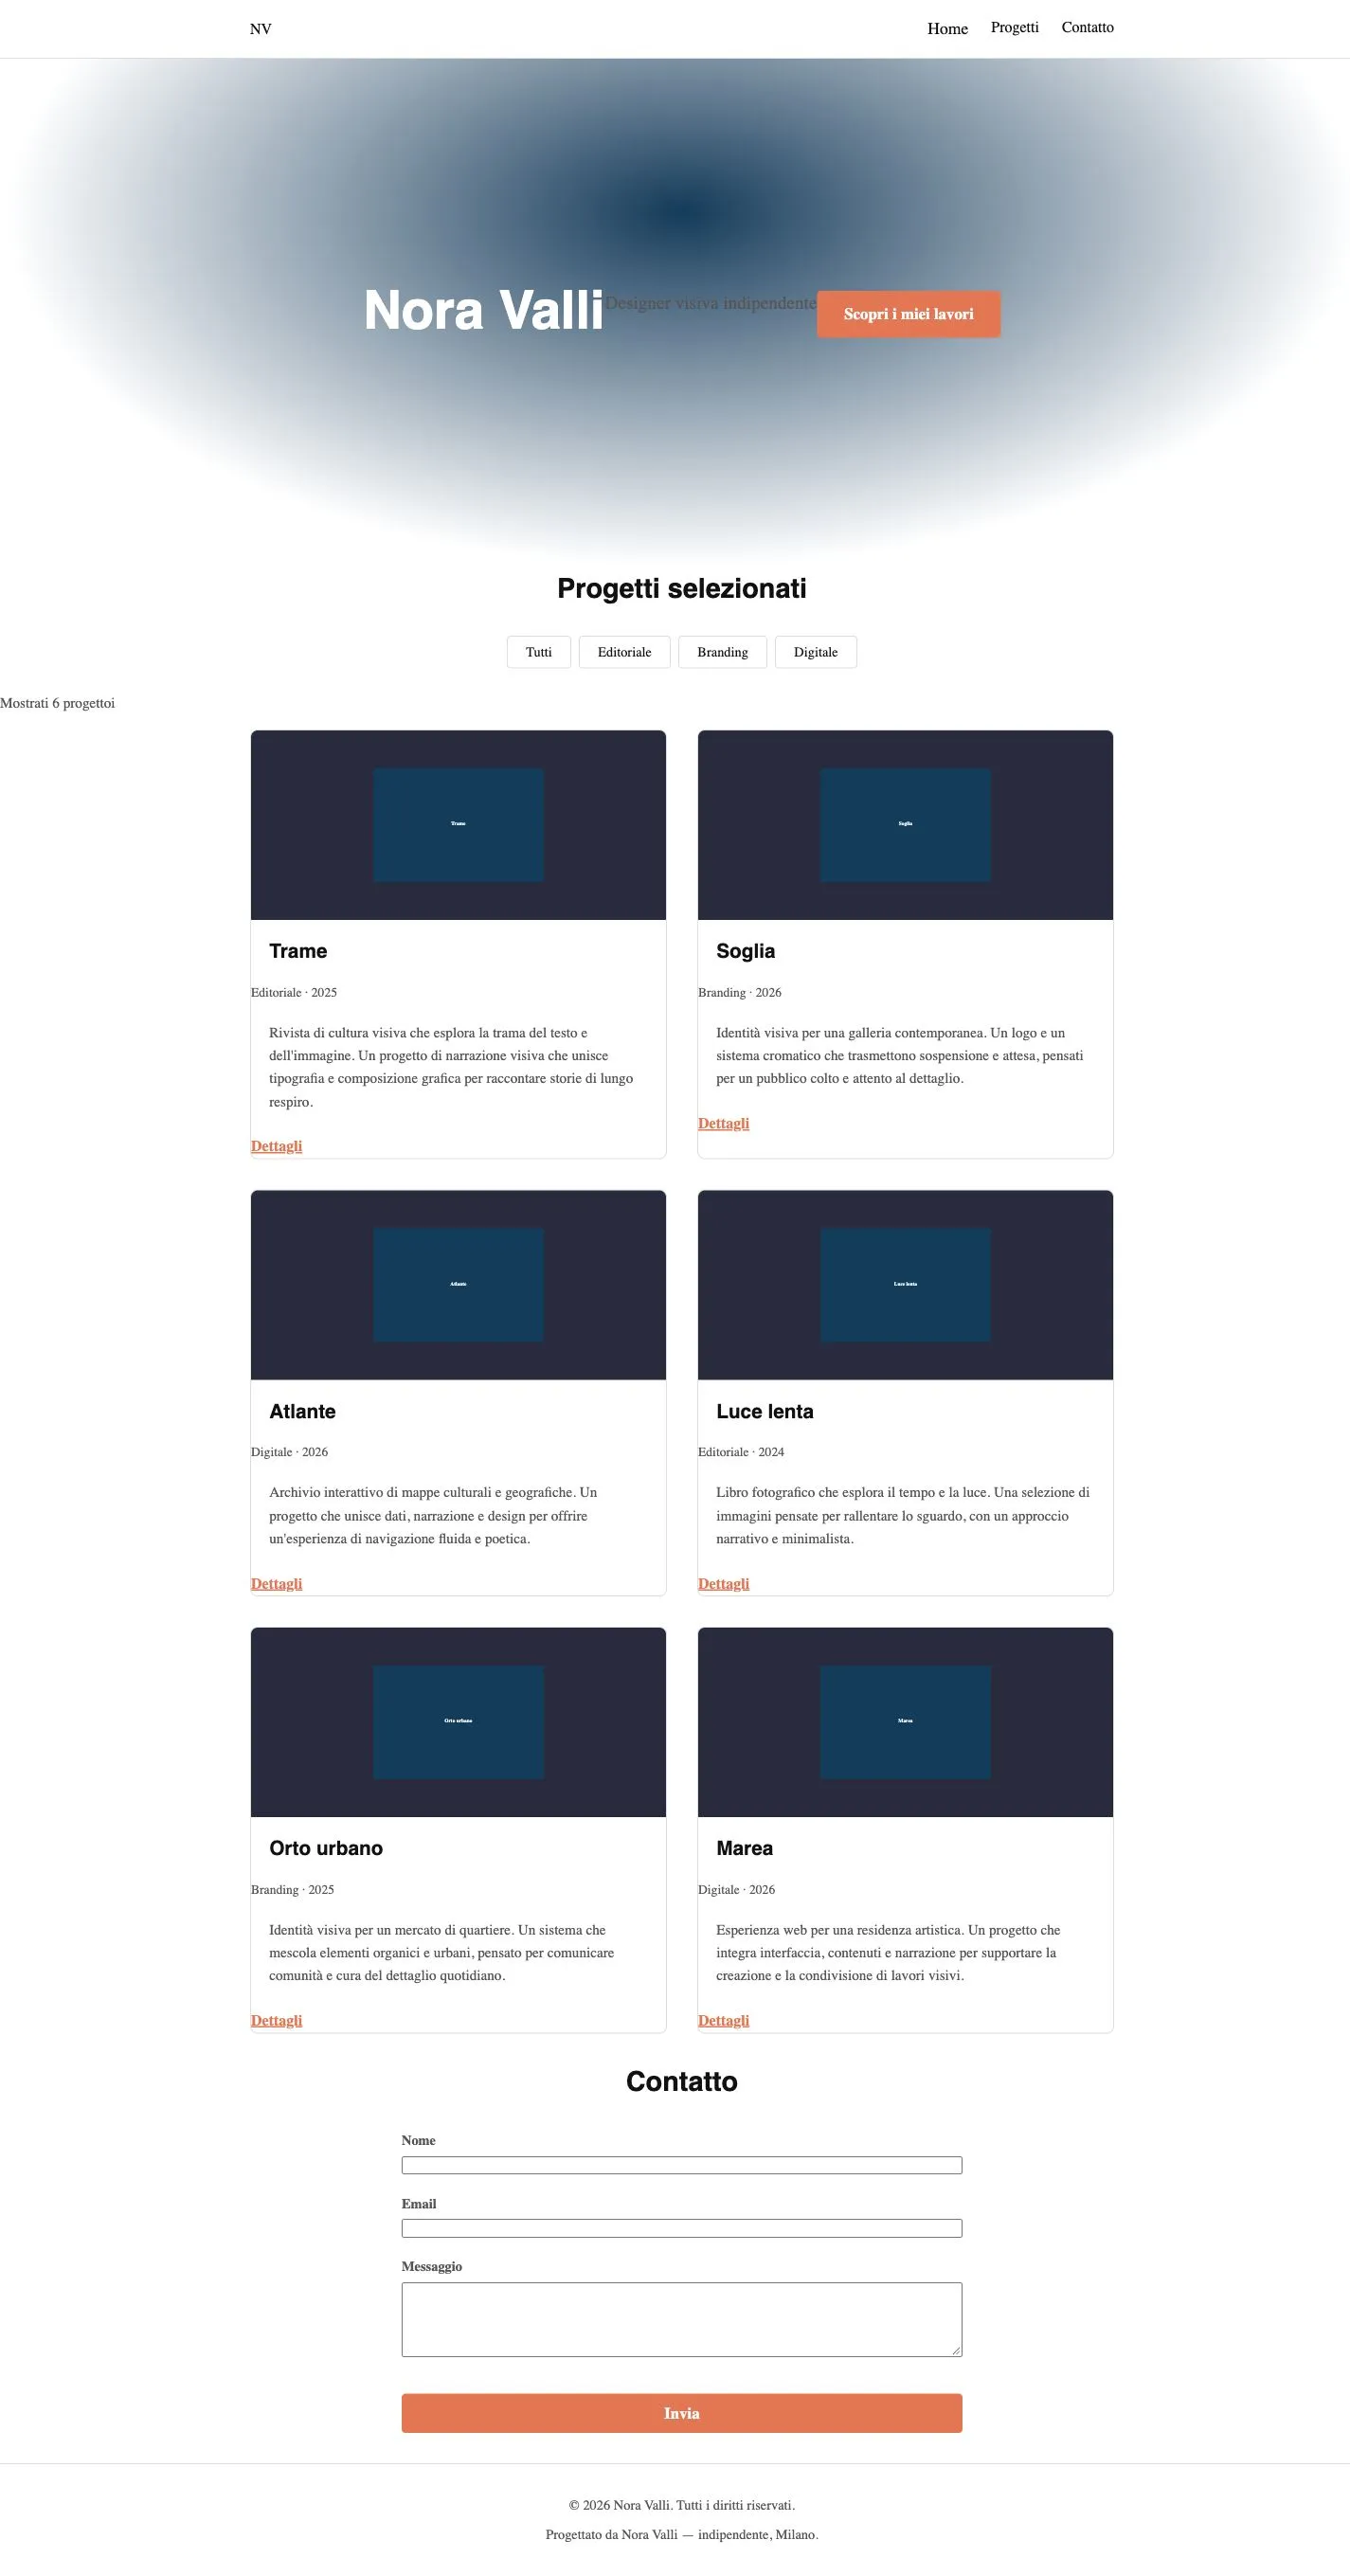
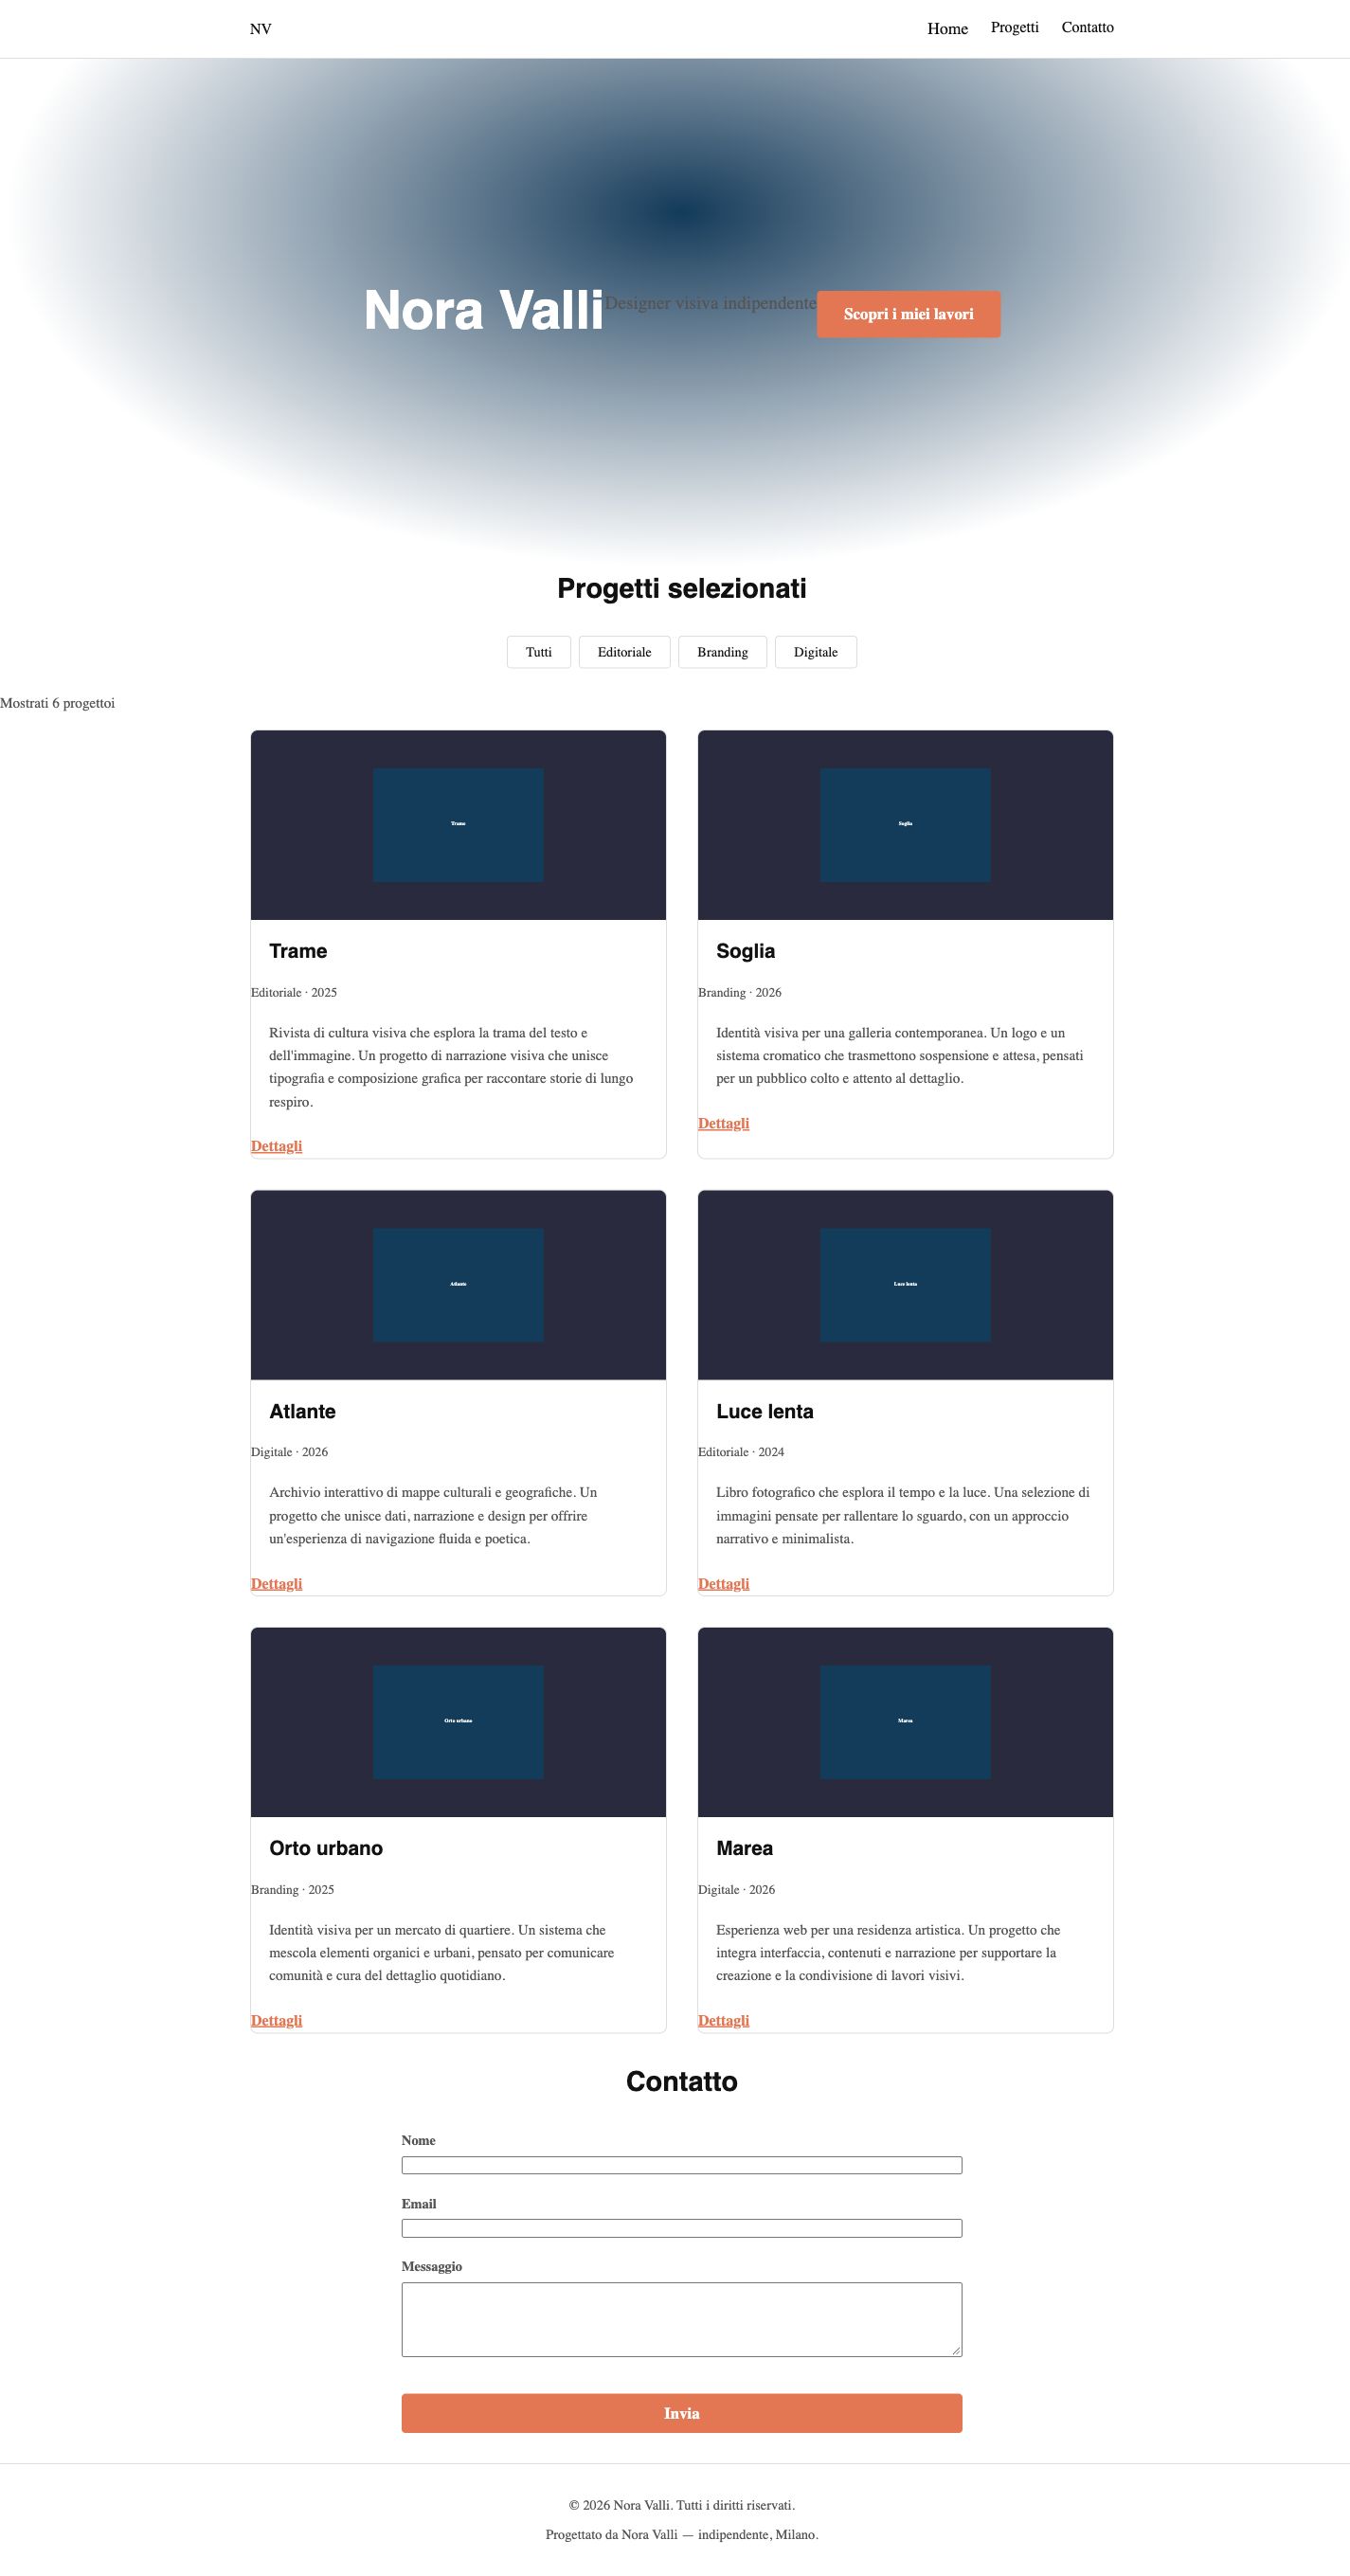
Qwen gestaltet eine helle Seite mit großem Studiobild, Serifentiteln, erdfarbener Kursivschrift und viel Raum. Ornith stellt Titel und Bild nebeneinander, nutzt rote und grüne Akzente und ordnet Arbeiten in Karten mit großen Initialen. LFM zeigt ein breites blaues Verlaufsband mit wenig geklärter Beziehung zwischen Titel, Text und Hauptbedienelement. Die erzeugte Bilddatei existiert, ist aber anfangs nicht eingebunden; sie erscheint während der Korrekturen.
Meine Reihenfolge lautet Qwen, dann Ornith, dann LFM. Das ist ein ausdrücklich persönliches Urteil nach dem Versuch. Mögliche Gründe zeigen sich im Vergleich von Proportionen, Hierarchien und Bildeinbindung; die Zahl bestandener Prüfungen beantwortet eine andere Frage.
Alle folgenden Aufnahmen sind spätere redaktionelle Wiedergaben der aufbewahrten Artefakte, ohne Änderungen und ohne neue Inferenzläufe. Die Baseline ist die erste Fassung, auch Iteration 0 genannt. Desktop-Viewports messen 1440×900; ein Ganzseitenbild kann höher als 900 Pixel sein. Jedes Bild verlinkt seine vergrößerbare Originaldatei.
Hinter einem guten ersten Eindruck
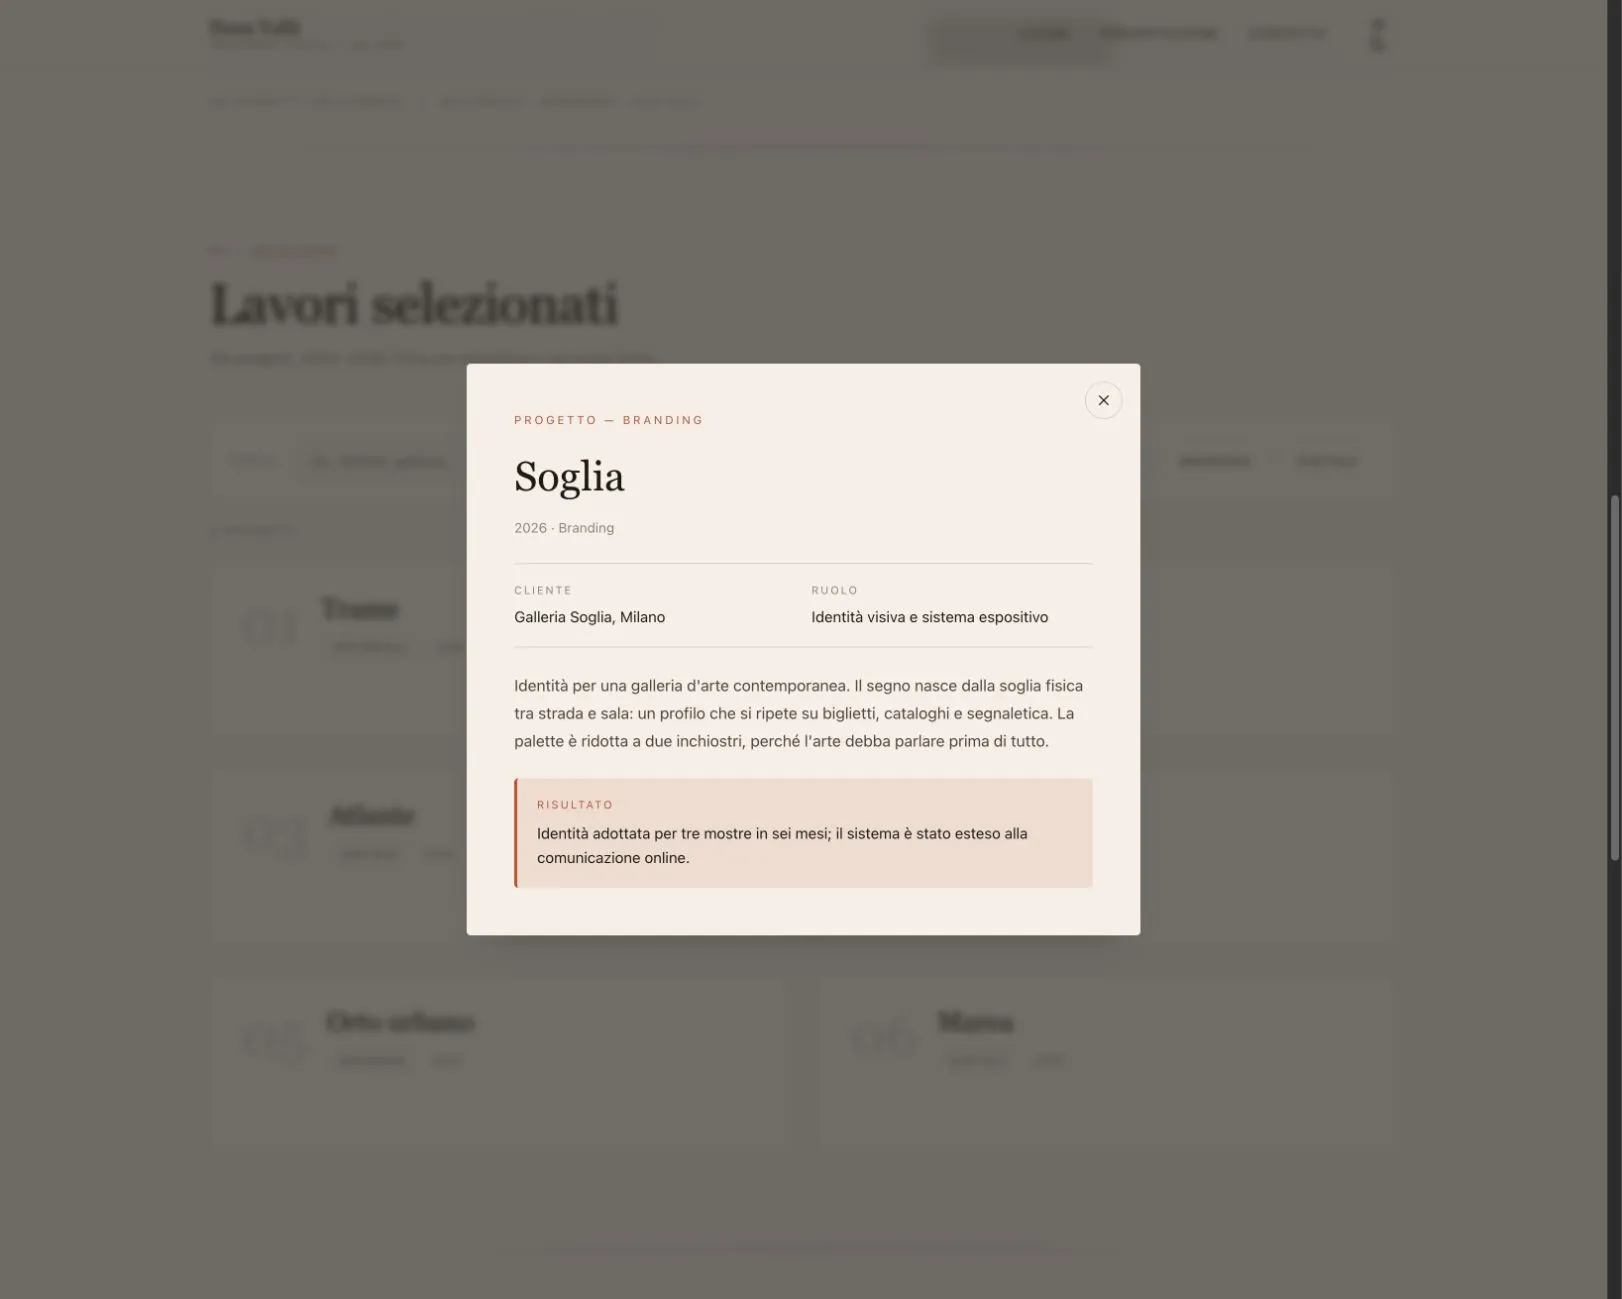
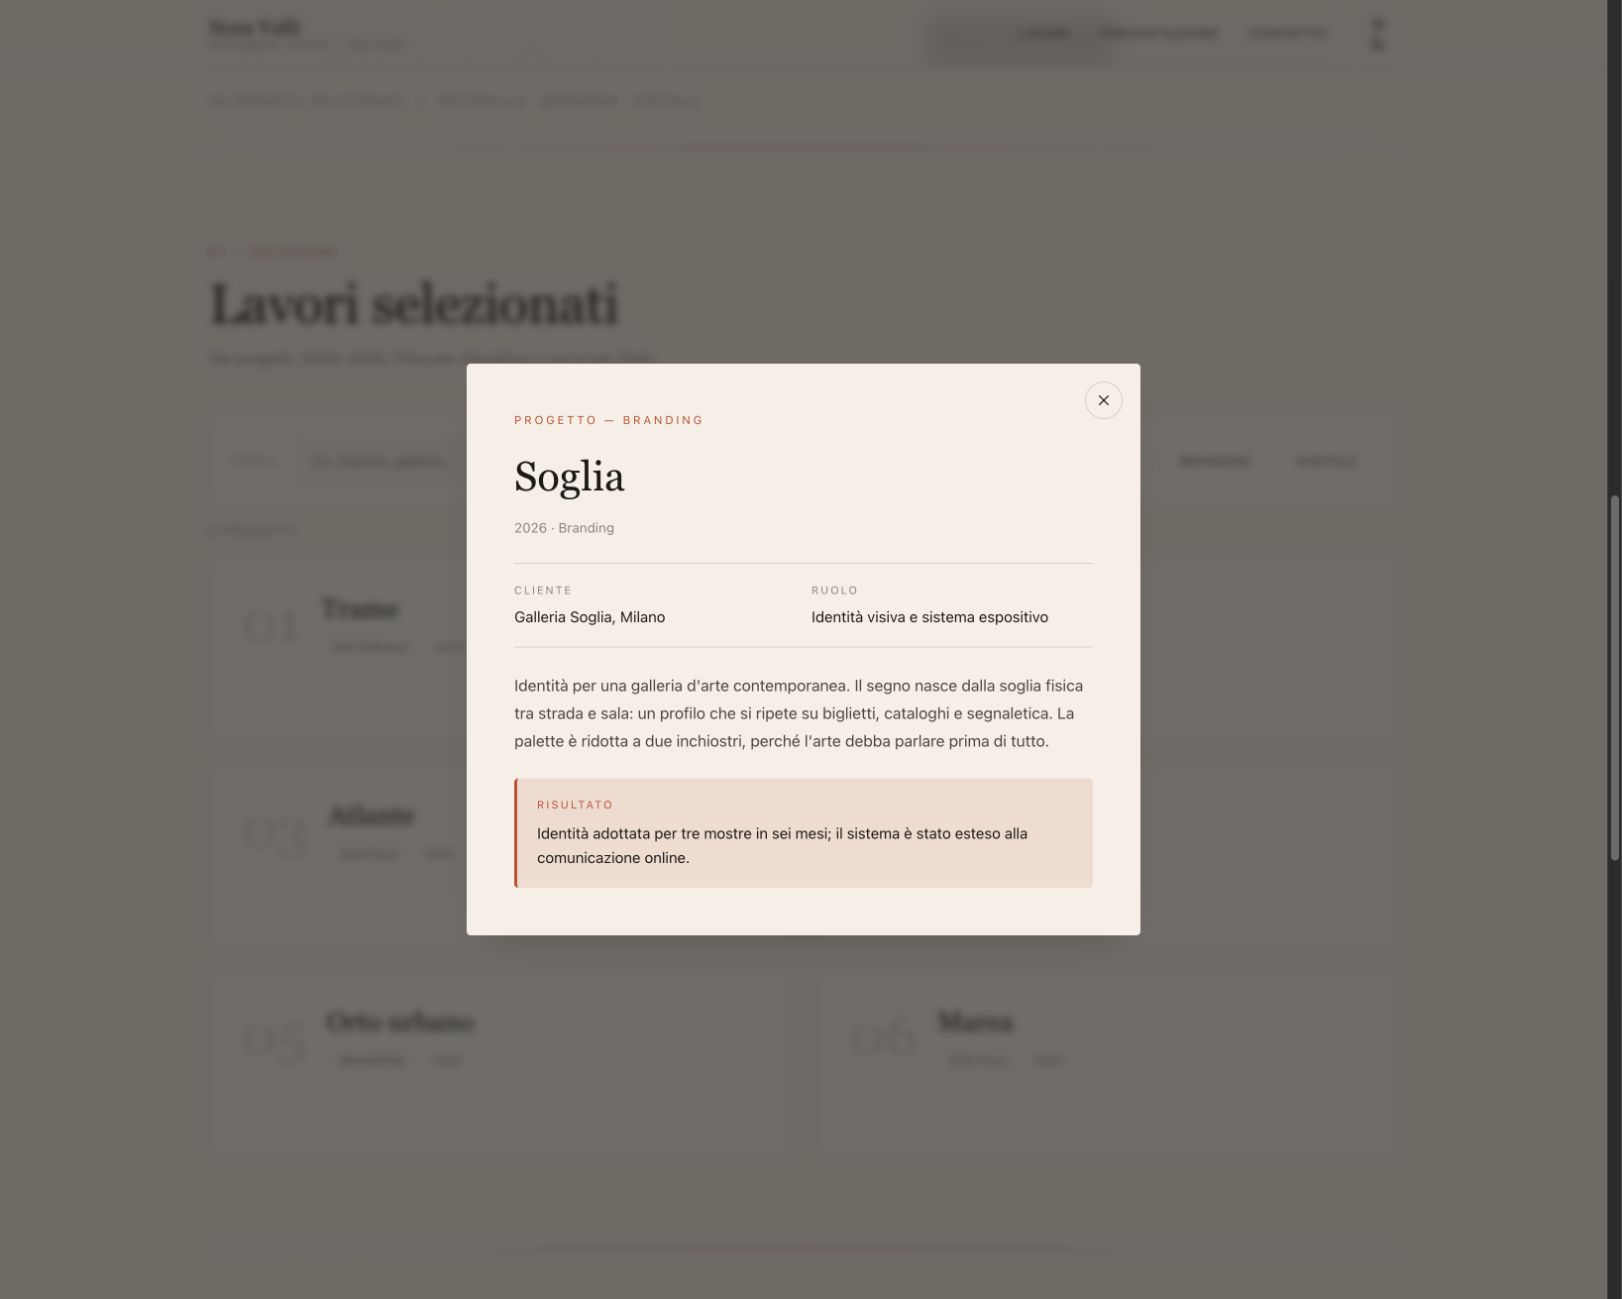
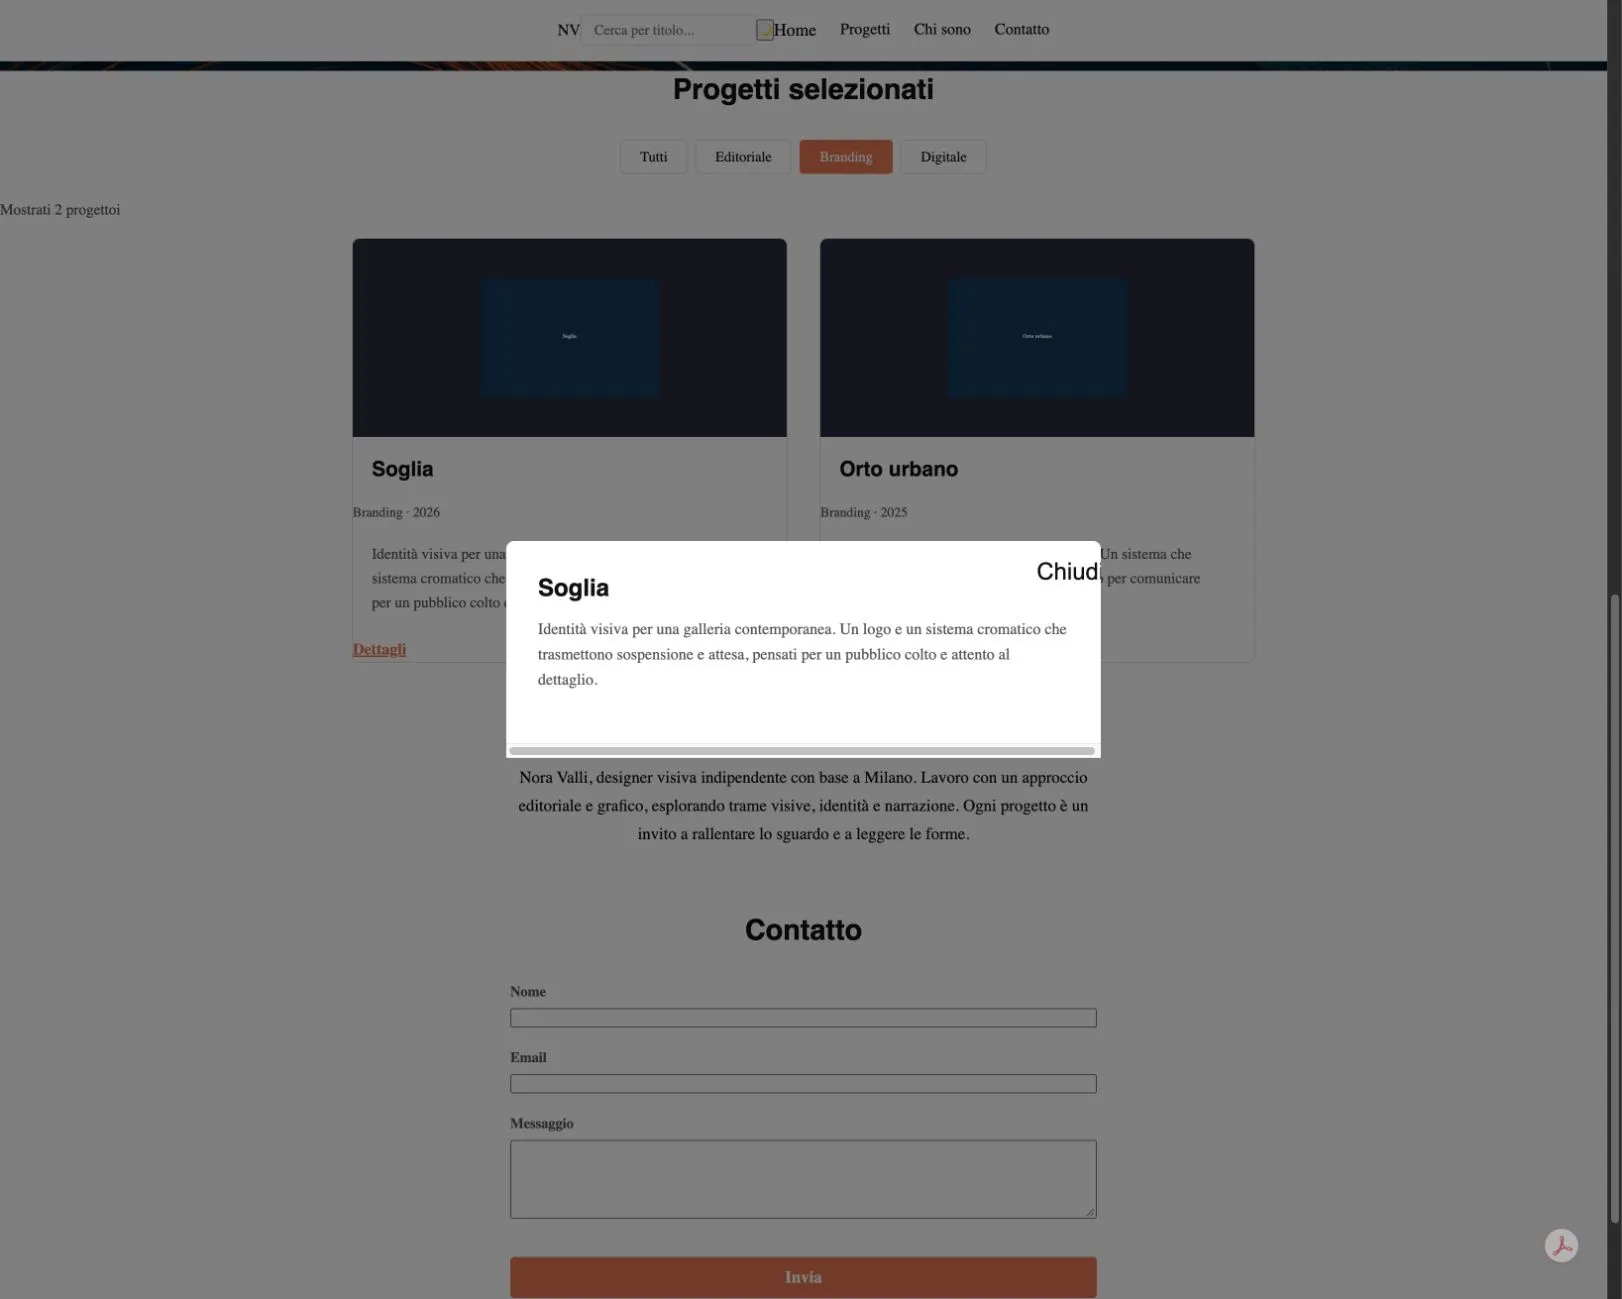
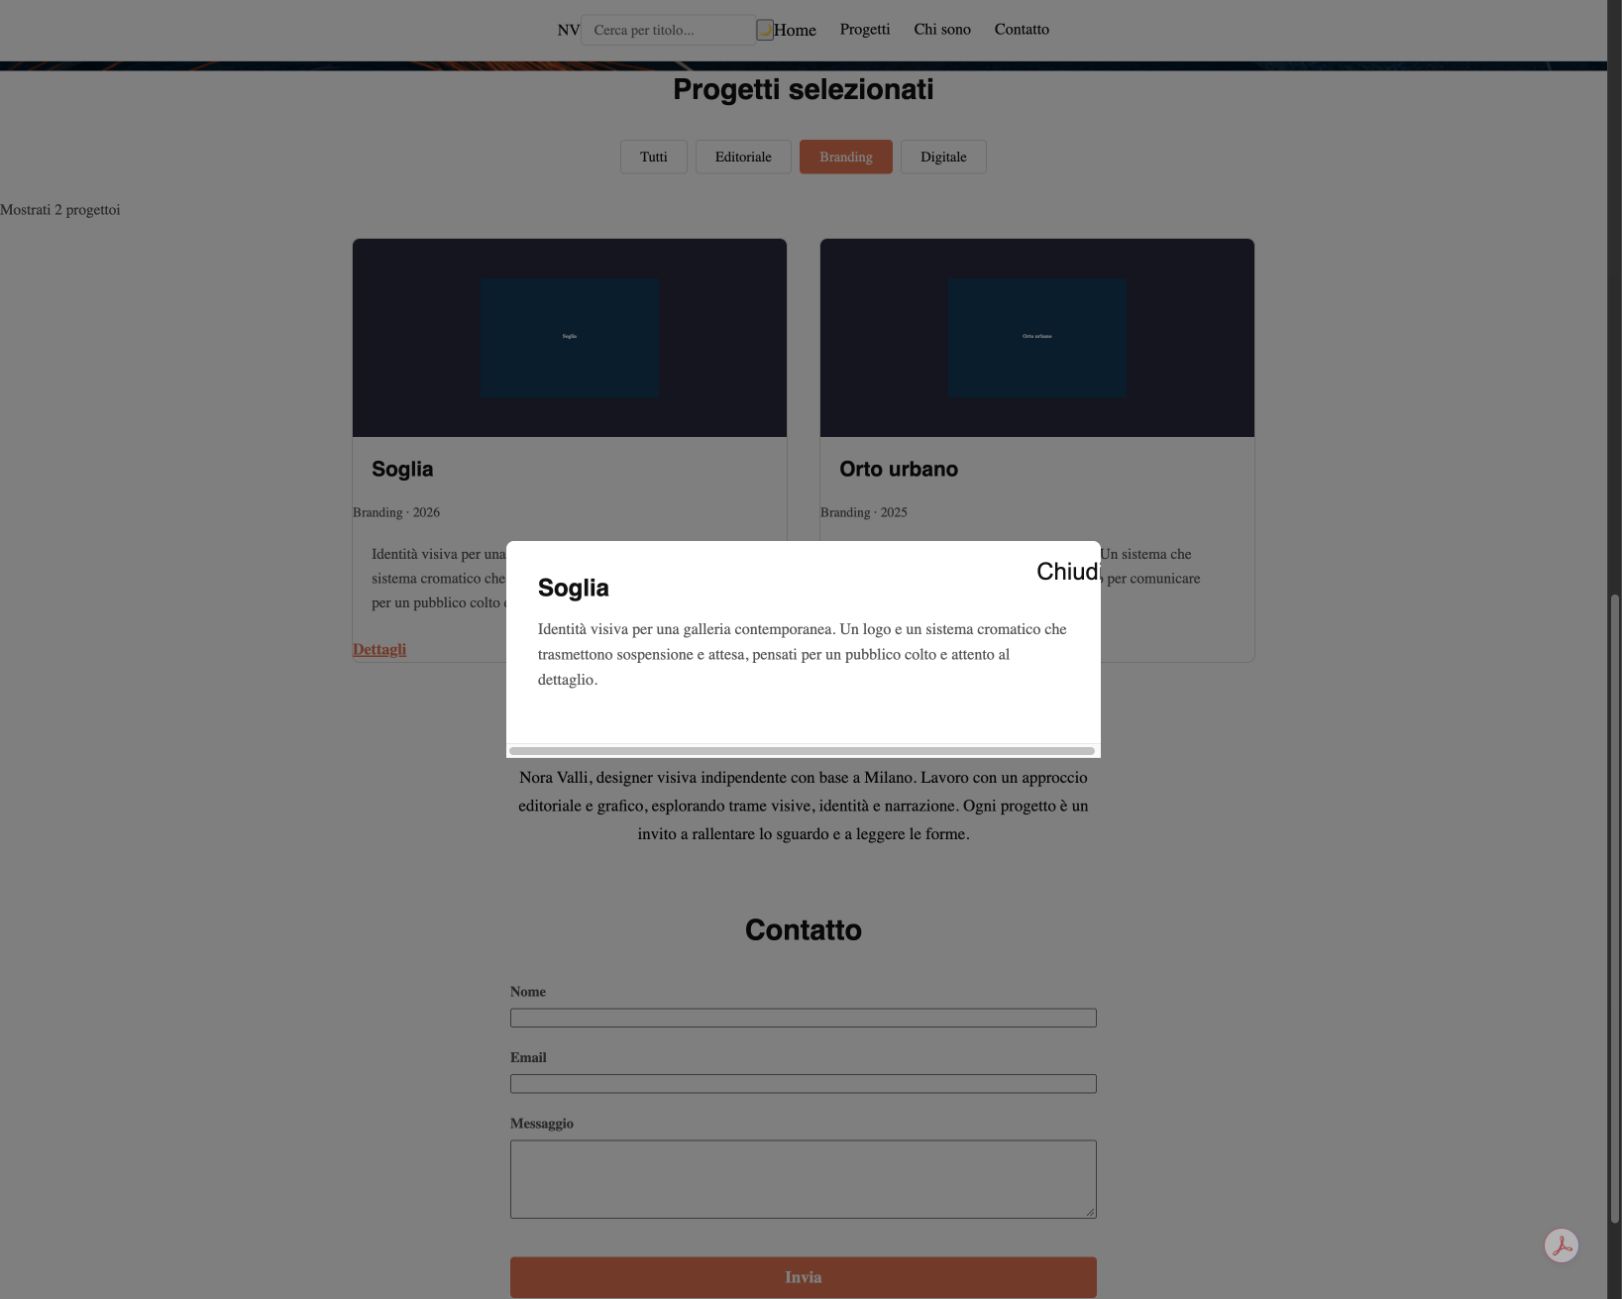
Qwen begann mit neun vollständig und einer teilweise bestandenen Prüfung. Das Problem lag bei den Projektdetails: Vier von sechs Dialogen funktionierten nicht. Ein Klick auf Soglia ließ die Seite stehen, ohne die angeforderten Inhalte zu öffnen.
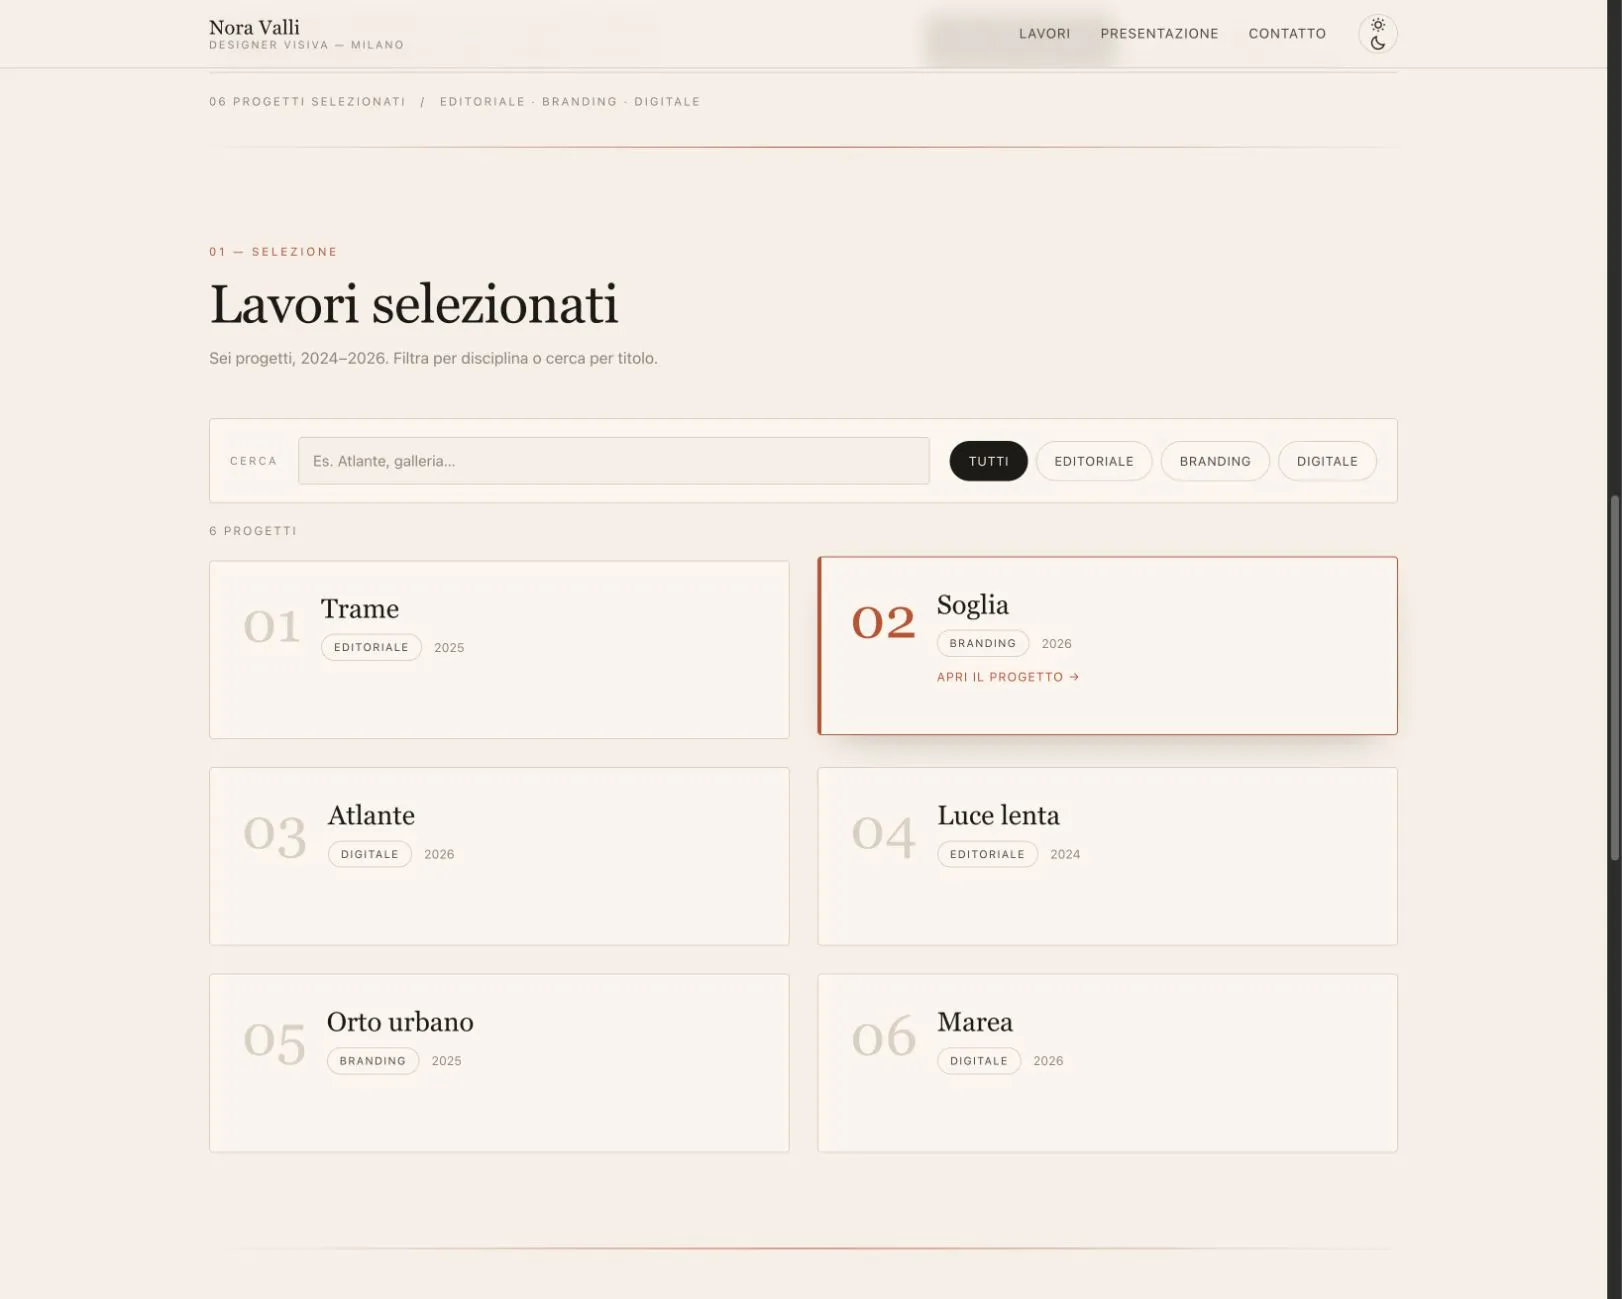
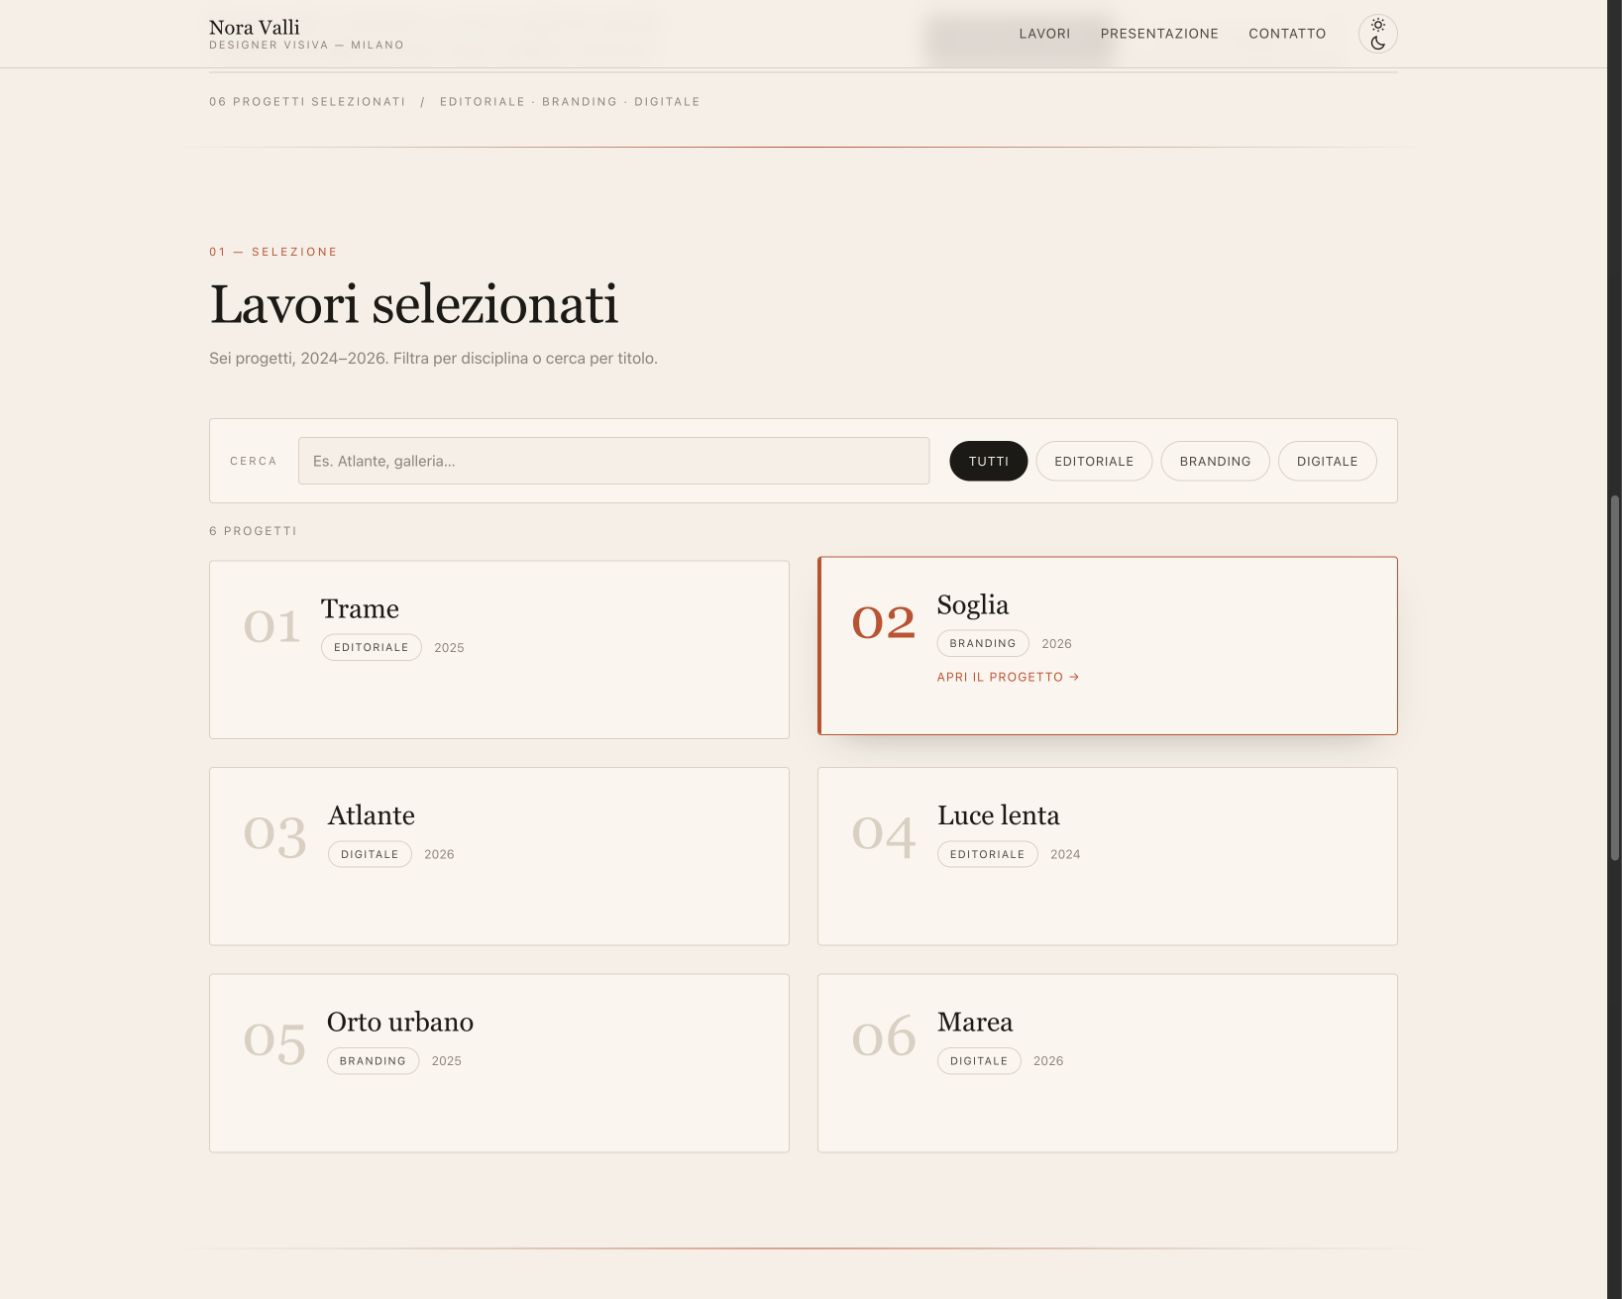
Nach zwei weiteren Iterationen öffnet dieselbe Handlung Details mit Titel, Jahr, Rolle und Beschreibung. Die Lösung ergänzt einen JavaScript-Fallback: Daten werden auch bei abgeschnittenen JSON-Attributen im ursprünglichen HTML abgerufen. Das geforderte Verhalten besteht; fehlerhaftes Markup bleibt vor einer echten Nutzung zu beheben.
Ornith begann mit acht bestandenen Prüfungen. Der Branding-Filter änderte sein Aussehen, ließ aber alle sechs Arbeiten sichtbar. Das Bedienelement zeigte eine Auswahl an, der die Sammlung nicht folgte.
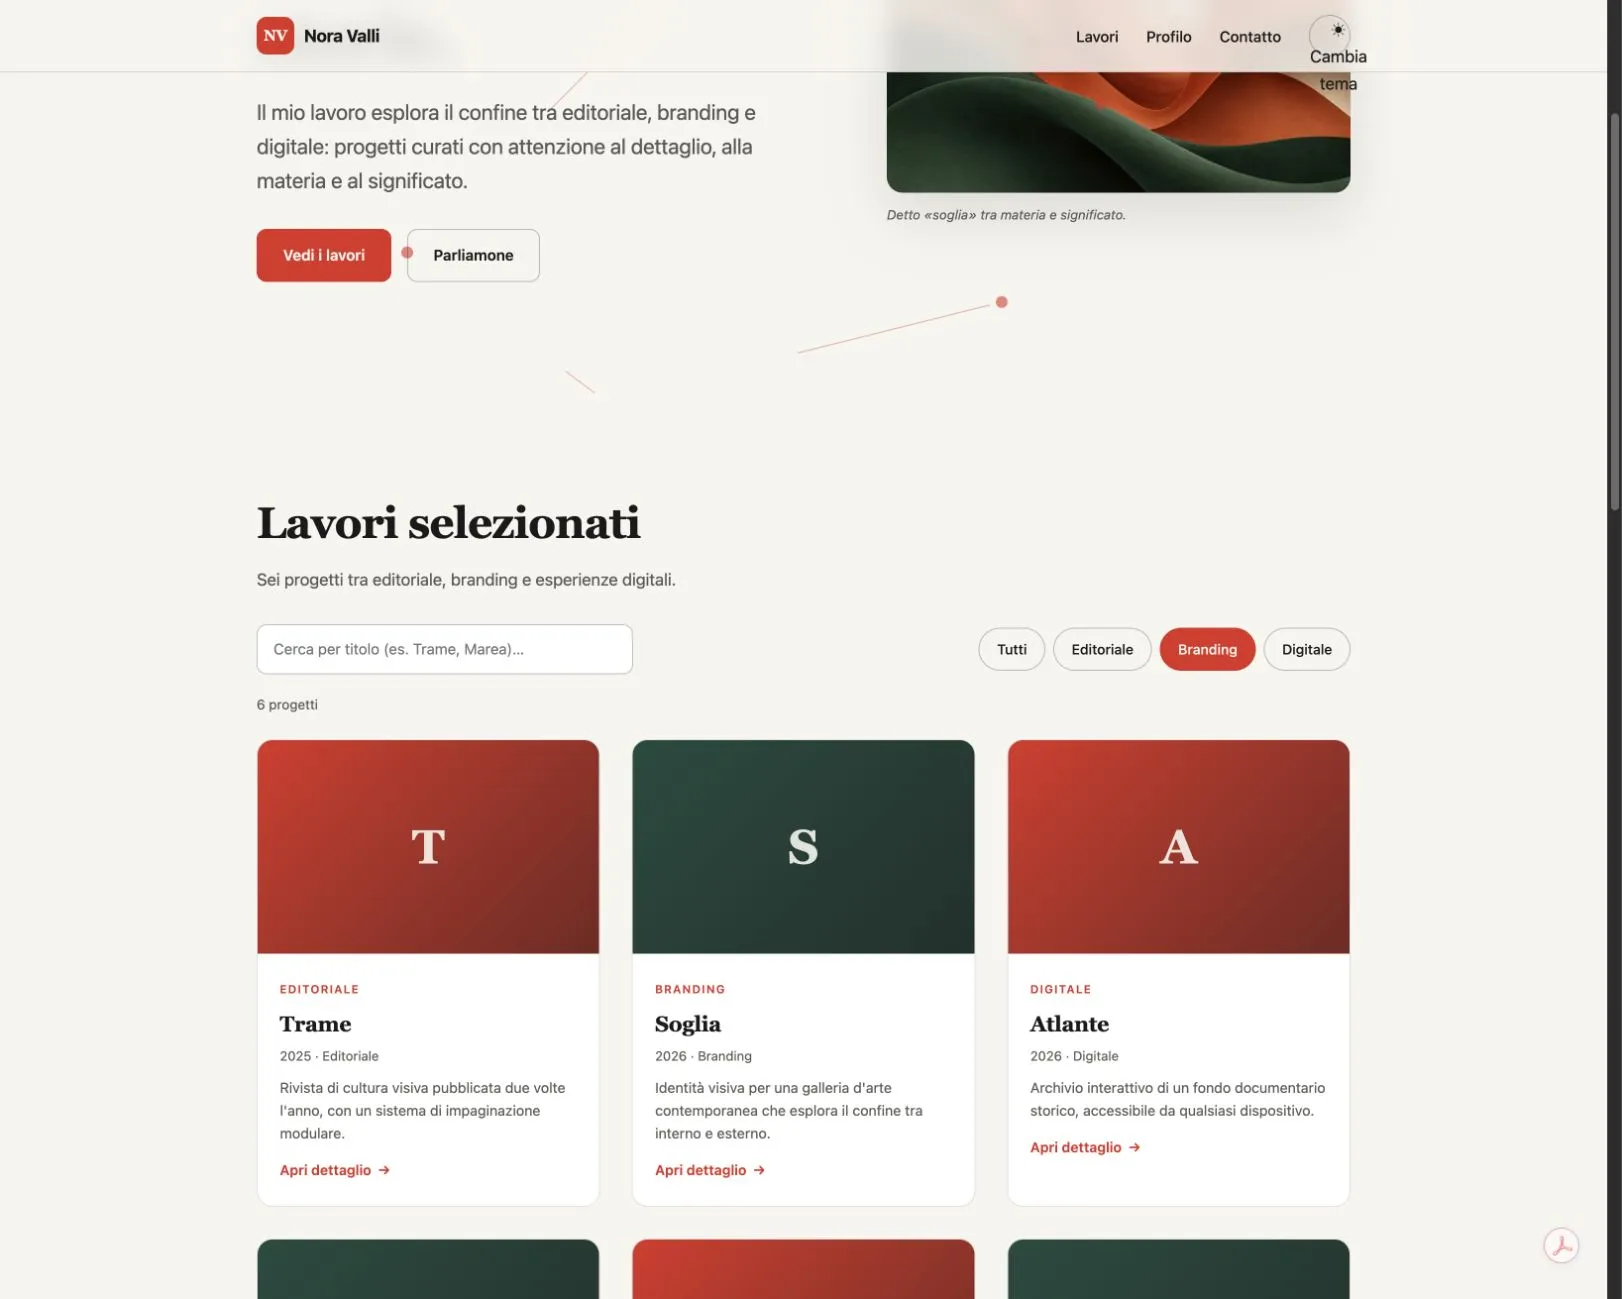
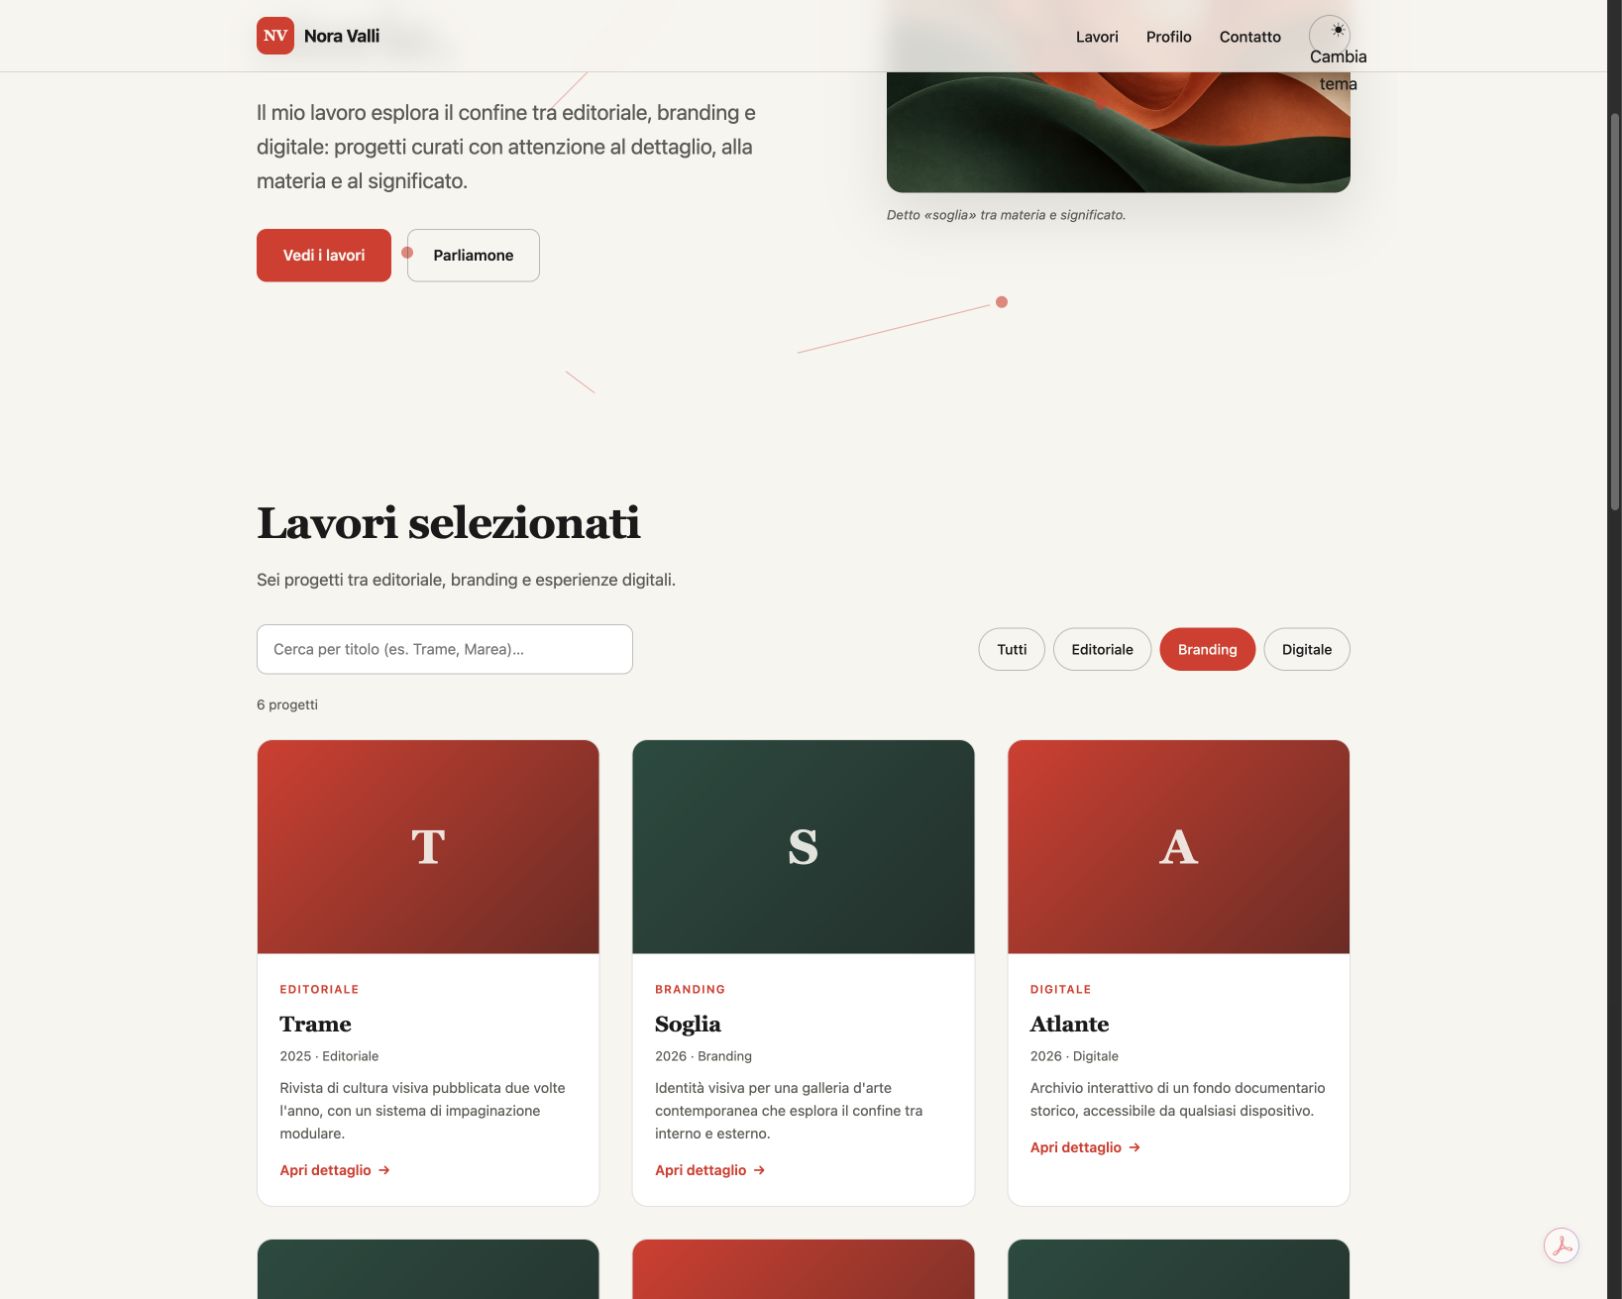
In seiner einzigen Korrekturrunde berichtigt Ornith Verweise auf Filtervariablen. Wie gefordert bleiben Soglia und Orto urbano übrig. Der Tippfehler „2 progettoi trovatoi“ bleibt: Geprüft werden Anzahl und Zustand, nicht jedes Wort der Oberfläche.
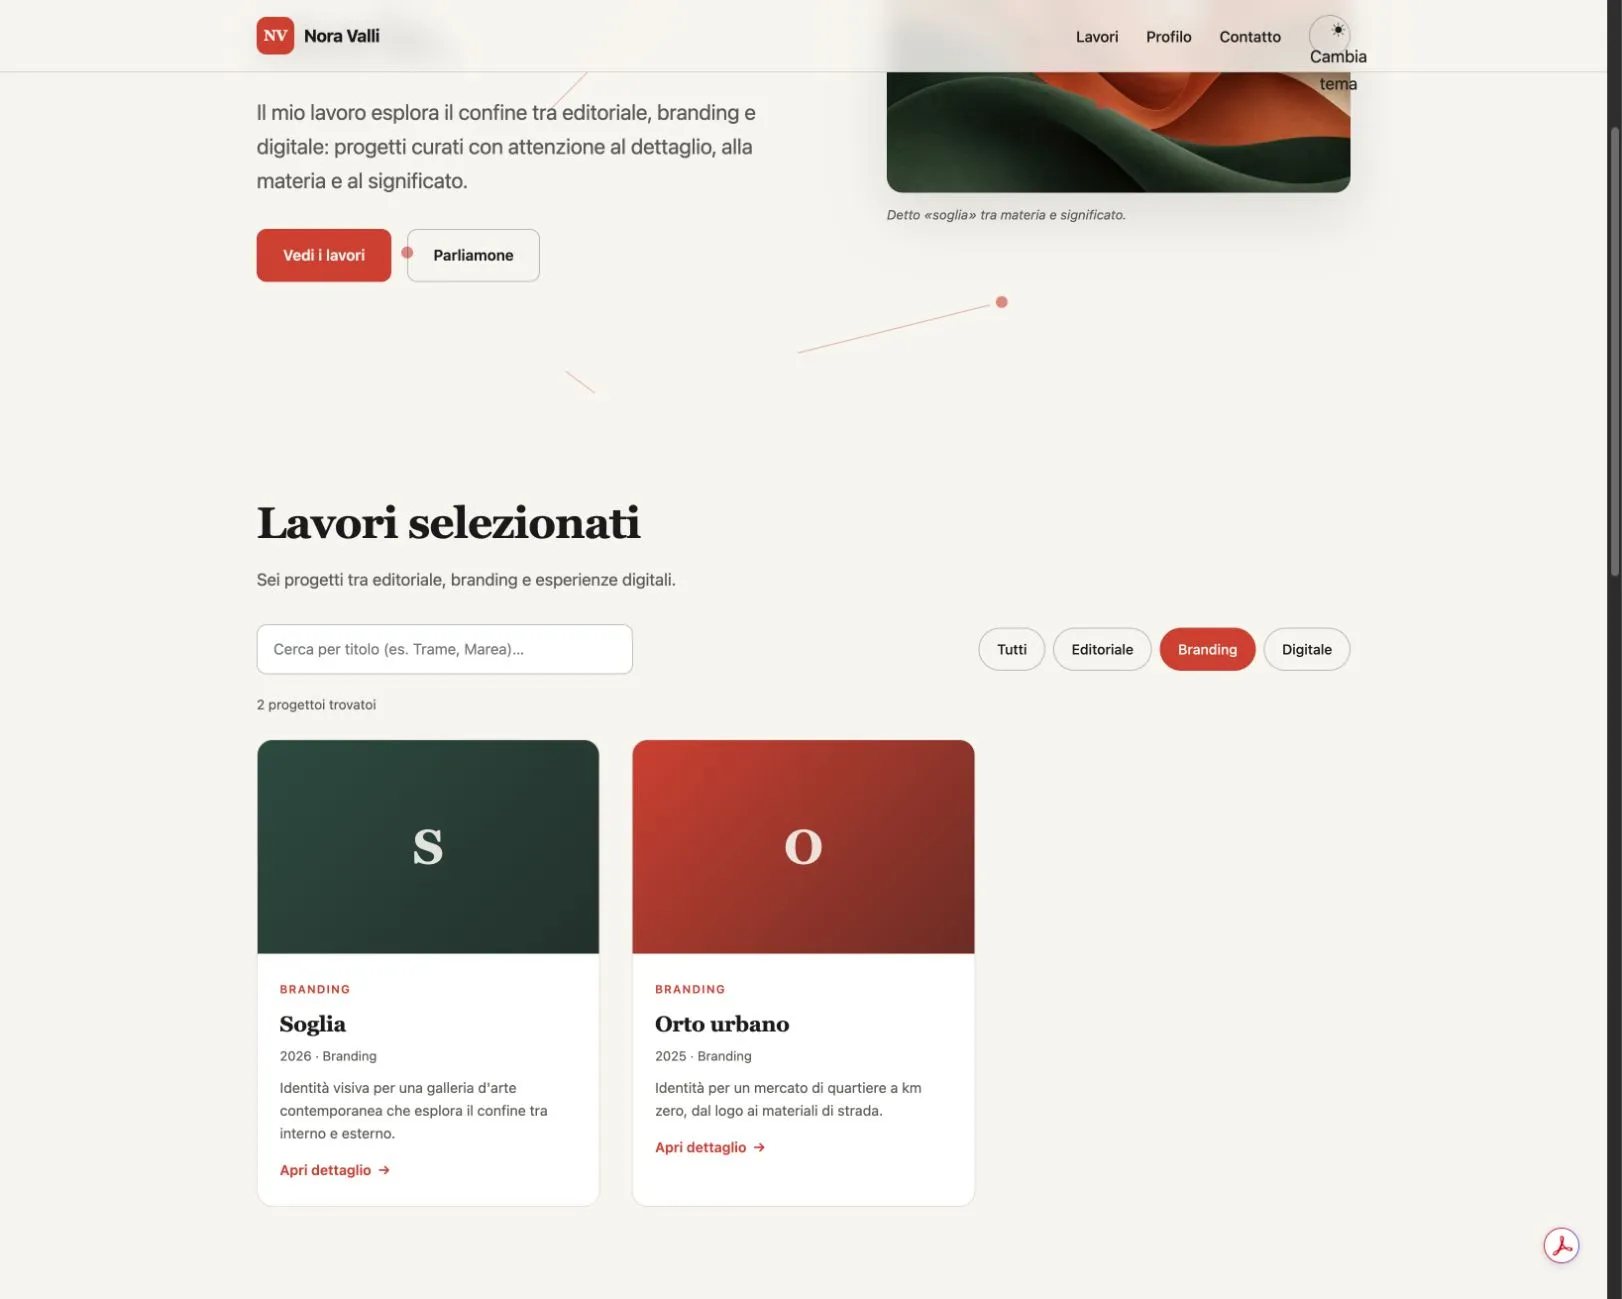
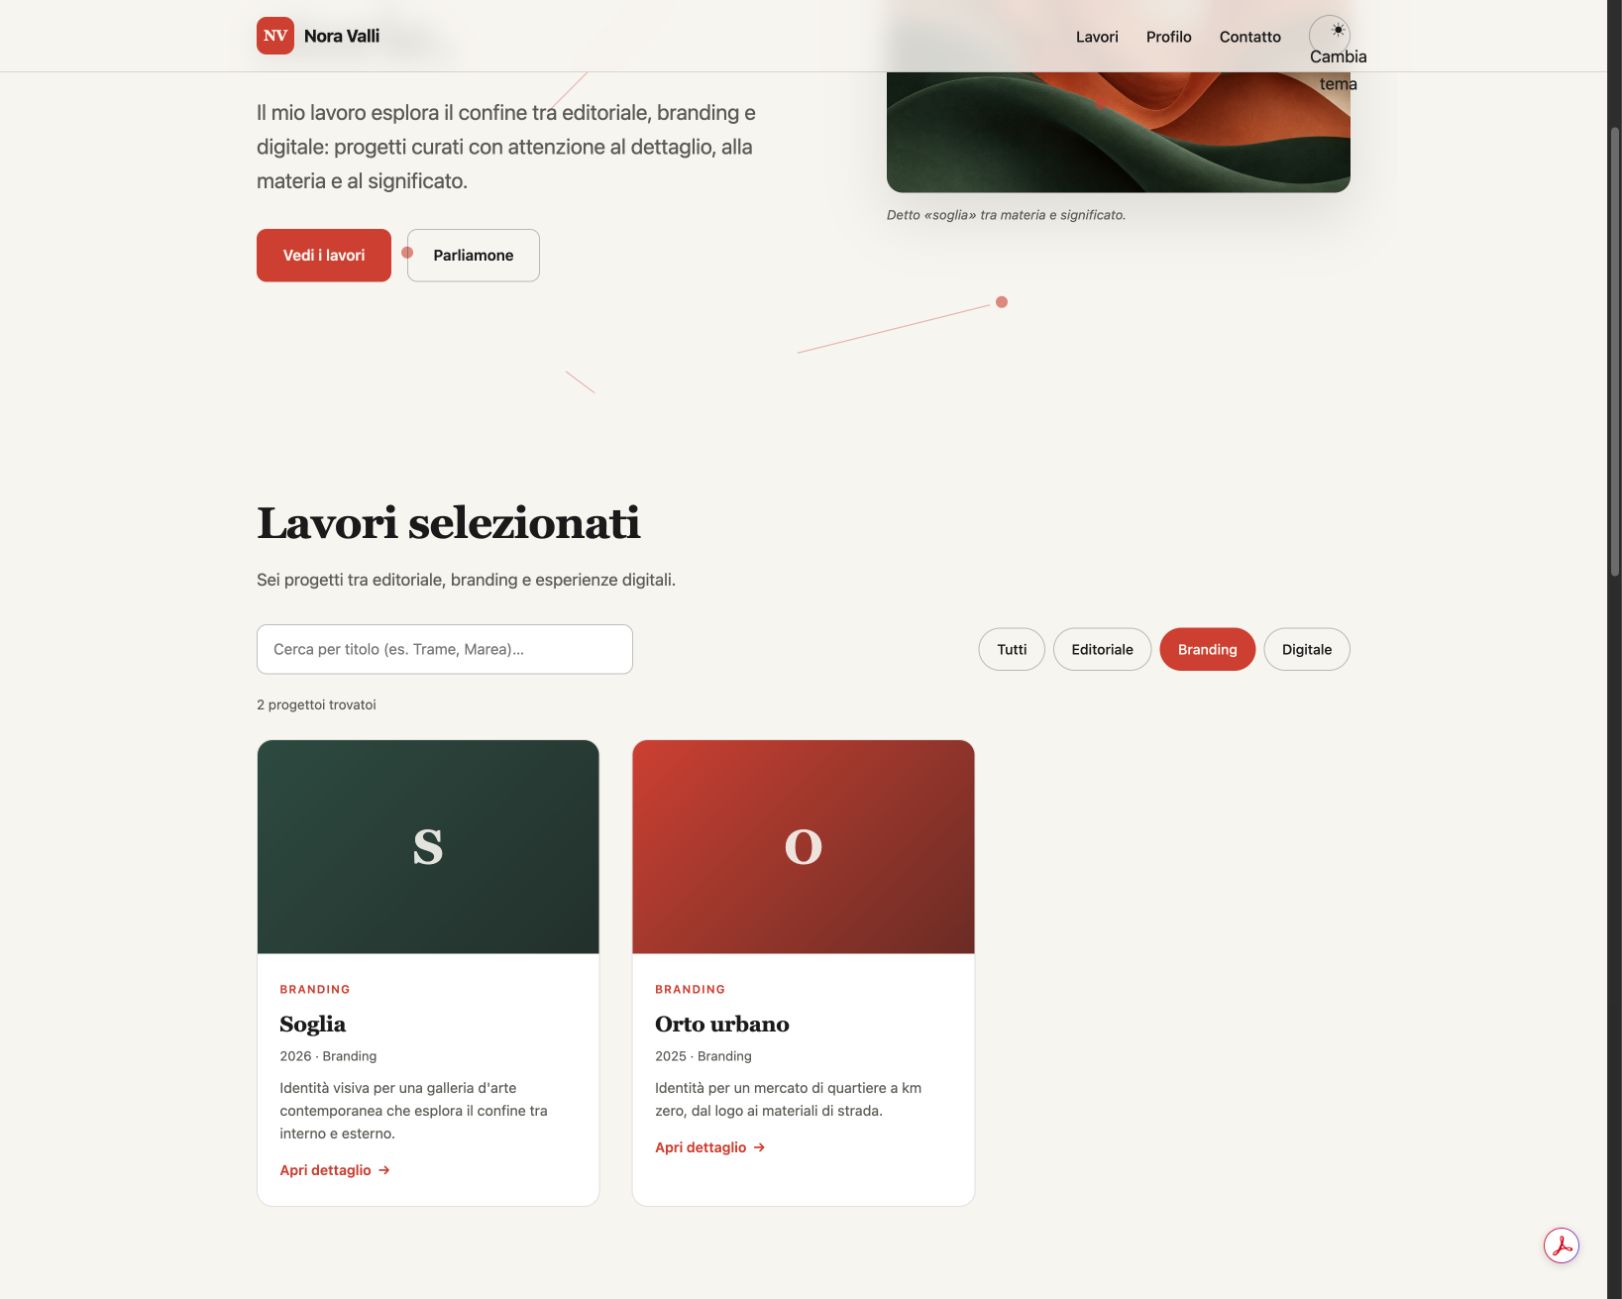
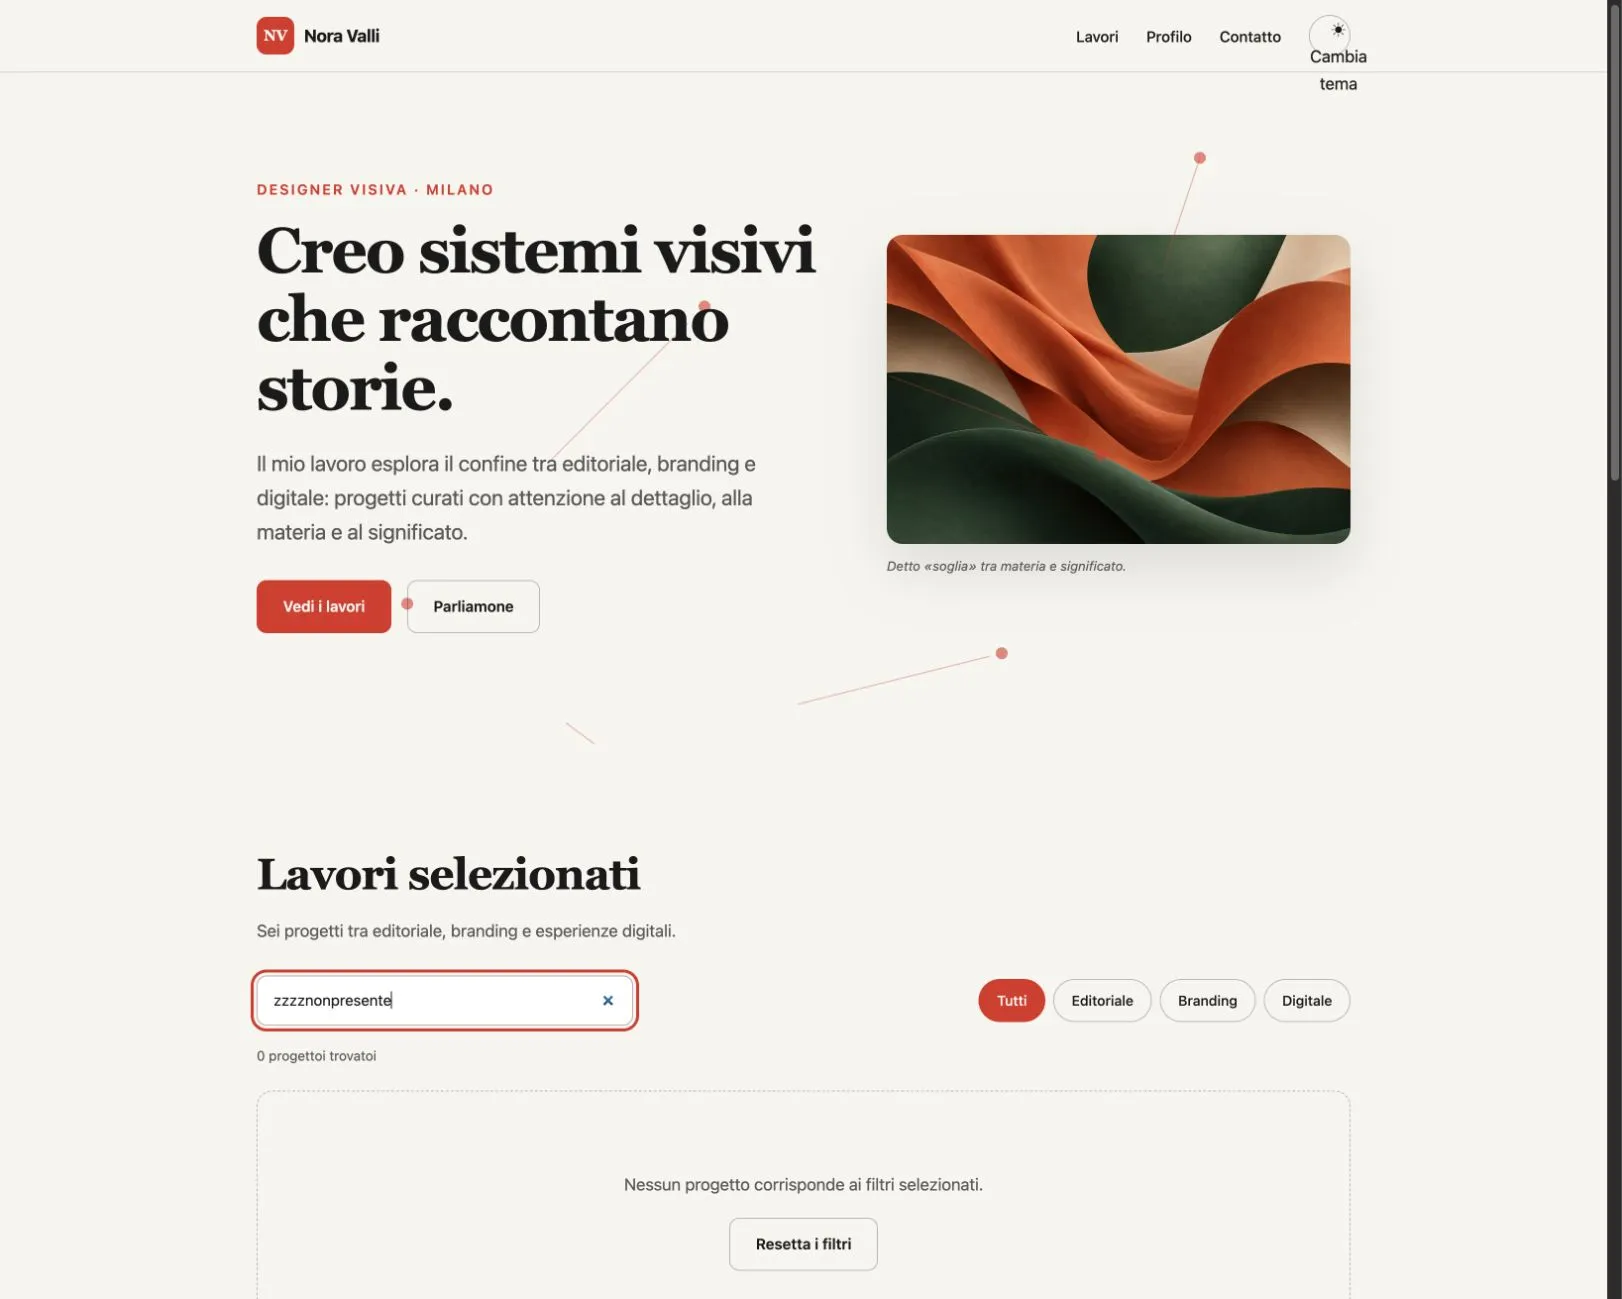
Die vollständigen Prüfungen kombinieren Filter und Suche. Erwartet wird eine Folge von sechs zu zwei, dann einem und null Ergebnissen, nach Zurücksetzen wieder sechs. Zeigt eine Suche nach „Soglia“ das Projekt weiterhin unter Editoriale, arbeiten Filter und Anfrage getrennt: Ein Screenshot eines erfolgreichen Filters belegt nicht ihr Zusammenspiel.
Eine Iteration kann verbessern, wiederholen oder verschlechtern
Eine weitere Iteration bedeutet hier einen neuen Pi-Lauf mit neuer Sitzung und neuem Prompt, ausgehend von den vorherigen Dateien und gefolgt von sämtlichen externen Prüfungen. Ein Werkzeugaufruf oder eine einzelne Modellantwort ist keine neue Iteration.
| Konfiguration | Ausgangspunkt | Verlauf vollständig bestandener Prüfungen | Weitere Iterationen |
|---|---|---|---|
| Qwen | 9, dazu eine teilweise bestandene Prüfung | 9 → 9 → 10 | 2 |
| Ornith | 8 | 8 → 10 | 1 |
| LFM | 4 | 4 → 4 → 4 → 4 → 4 → 4 → 4 → 3 → 5 → 6 → 8 → 9 → 9 → 10 | 13 |
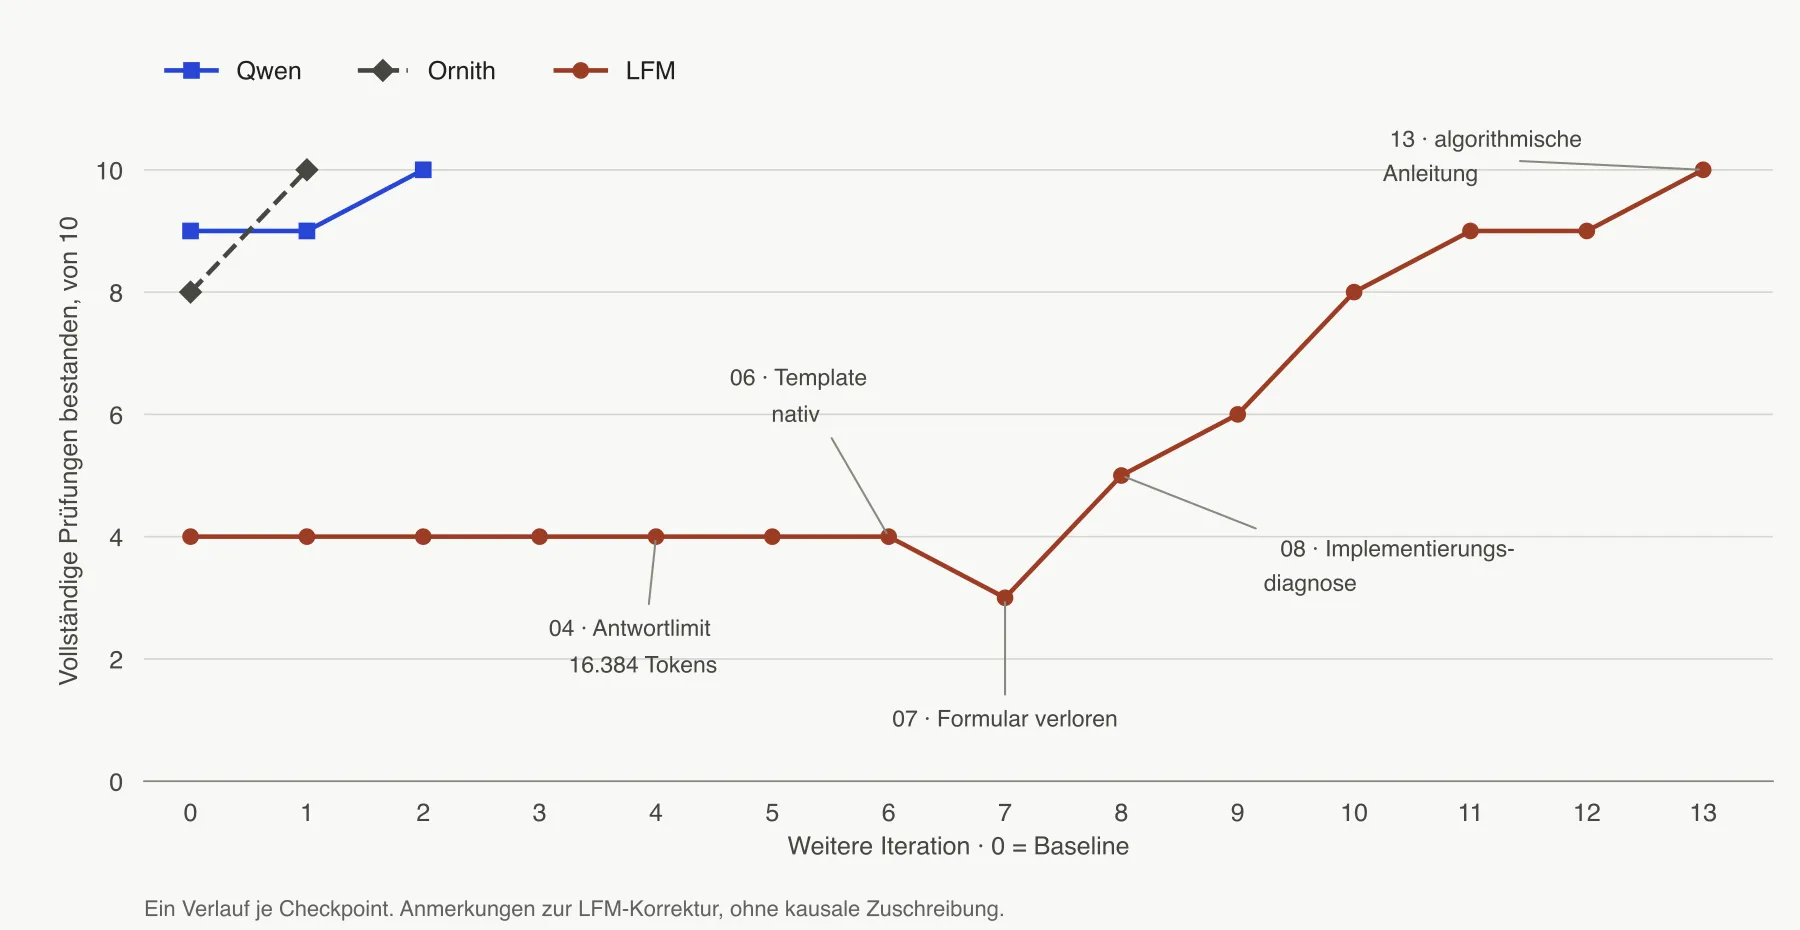
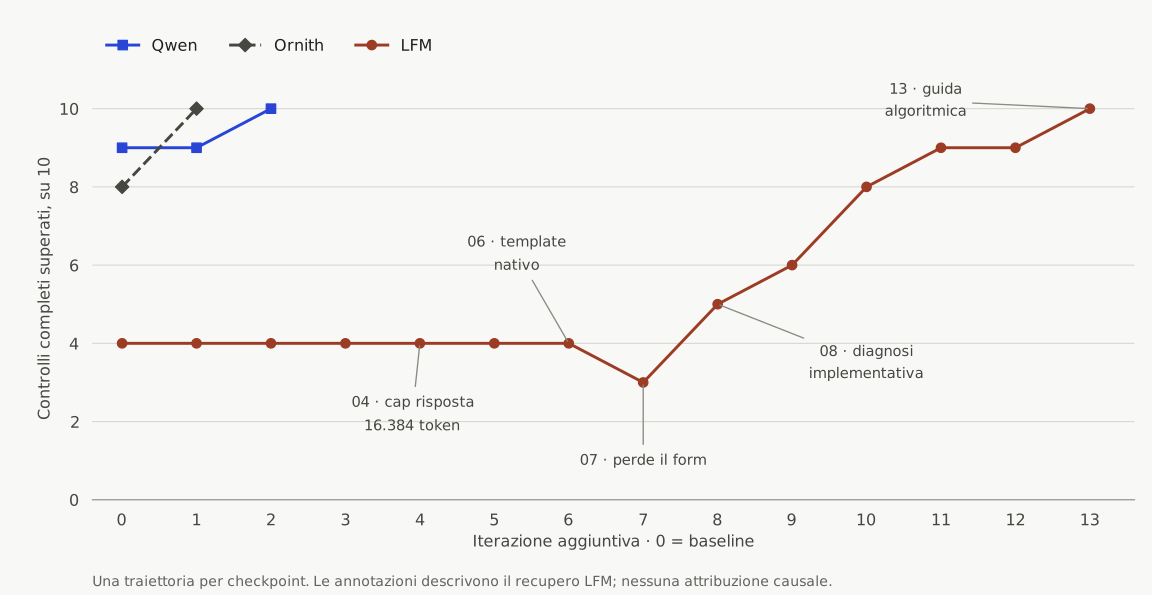
Jeder Pfeil in LFMs Zeile entspricht einem aufbewahrten Lauf, auch ohne Verbesserung. Der Rückgang von vier auf drei stammt aus Runde 07: Beim Neuschreiben geht die Formularbehandlung verloren. Der mobile Überlauf ist ein anderes, bereits bestehendes Problem und erklärt diesen Punktverlust nicht.
In der ersten Korrektur nutzt Qwen alle 24 verfügbaren Werkzeugaufrufe. Die Folge umfasst das Lesen von script.js, Ersetzungen und wiederholte check_files, dann weitere Ersetzungen und Prüfungen. Auch die zweite Runde erreicht 24 Aufrufe, diesmal bei zehn bestandenen externen Prüfungen.
Das ist eine in den Logs beobachtbare operative Wiederholung. Qwen und Ornith verwendeten bereits enable_thinking=false in nativen Anfragen. Daraus lässt sich weder ein innerer Denkprozess rekonstruieren noch ein allgemeiner Fehler der Qwen-Familie beweisen. check_files prüfte Dateien und Syntax; das Modell konnte es wiederholen, ohne den weiterhin geschlossenen Browserdialog zu sehen.
Ornith führt in seiner einzigen Korrektur acht Werkzeugaufrufe und drei Ersetzungen aus. Der Runner erfasst etwa 48 Sekunden. In diesem Verlauf wird der Fehler schnell behoben; Zahl und Schwierigkeit der Ausgangsprobleme unterschieden sich jedoch von denen der Konkurrenz.
Wie viel Hilfe LFM erhielt
LFMs Behandlung änderte sich im Verlauf. Nach zwei erfolglosen Versuchen wurde der Prompt gezielter. Ab Runde 04 stieg das Antwortlimit von 8192 auf 16384 Tokens bei insgesamt weiterhin 24.000. Ab Runde 06 änderte sich auch das Nachrichtenformat, das Template: Ein experimenteller Präfix zum Schließen des think-Blocks wurde durch das native Format mit angefordertem Thinking ersetzt.
Nach dem Rückschritt in Runde 07 beschränkt der Koordinator die Werkzeuge auf kleine Ersetzungen, gibt kurze englische Anweisungen und liefert Implementierungsdiagnosen. In Runde 10 liefert er auch den italienischen Bestätigungstext des Formulars. In Runde 13 erklärt er die Verknüpfung beim Erstellen der Karten, die Verwendung des aktuellen Projekts, das Aktivieren der Dialogklasse und den Fokus auf der Schließen-Schaltfläche.
Diese Anleitung steht im Original-Prompt aus Runde 13 neben dem erzeugten Diff. Das Modell schreibt die Patches, erhält aber einen wesentlichen Teil der Lösung. Das abschließende 10/10 ist als stark unterstützte Korrektur zu lesen.
Prüfungen, die eine Abfolge brauchen
Ein geöffneter Dialog ist nur ein Teil der Prüfung. Alle sechs Arbeiten müssen passende Inhalte öffnen, sich per Schaltfläche und Escape schließen lassen und den Fokus zum Ausgangslink zurückführen. Tab und Umschalt+Tab wurden an einem repräsentativen Dialog geprüft. Prüfkennungen und Ergebnisse stehen im Audit-JSON; ein Dialogbild allein beweist keine Fokusbegrenzung.
Der Leerzustand muss verständlich und umkehrbar sein. Bei Ornith zeigt eine erfolglose Suche null, eine Meldung und das Zurücksetzen. Auch hier bleiben sprachliche Fehler sichtbar.
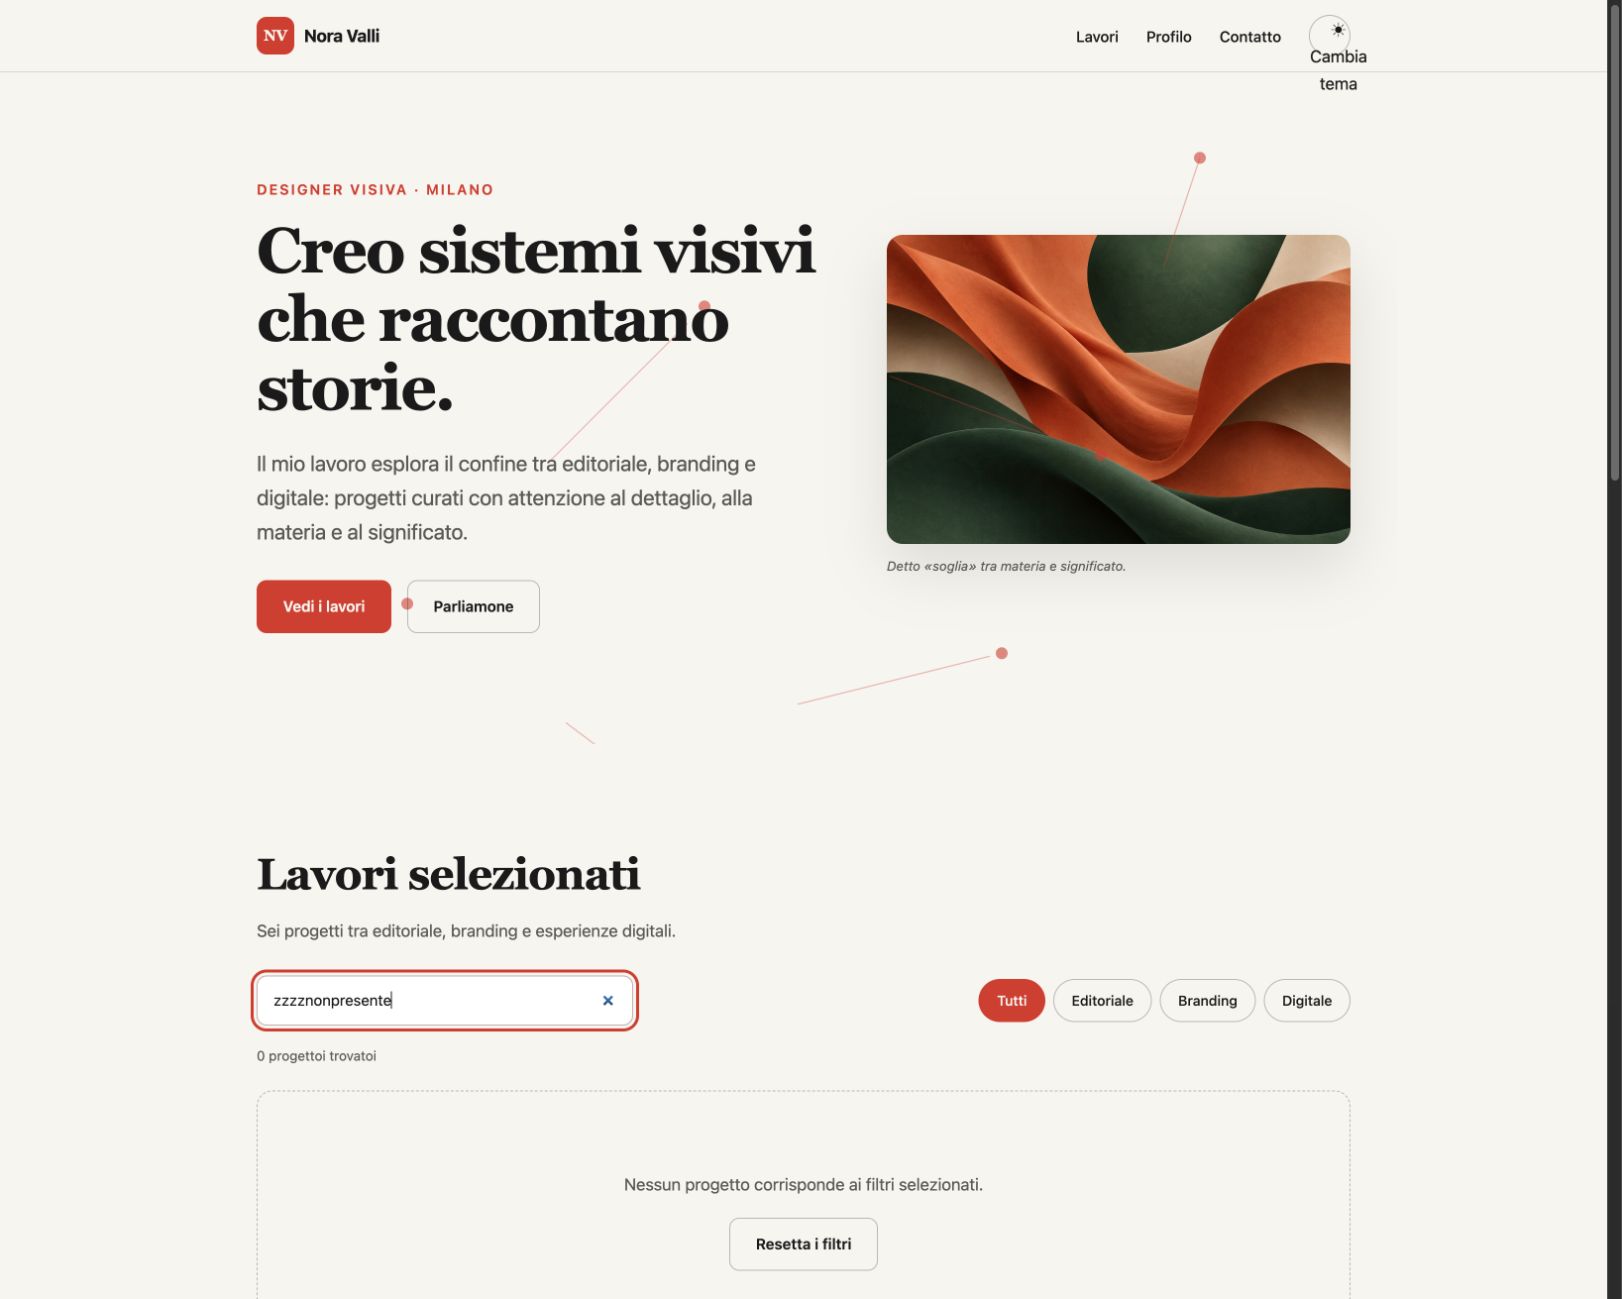
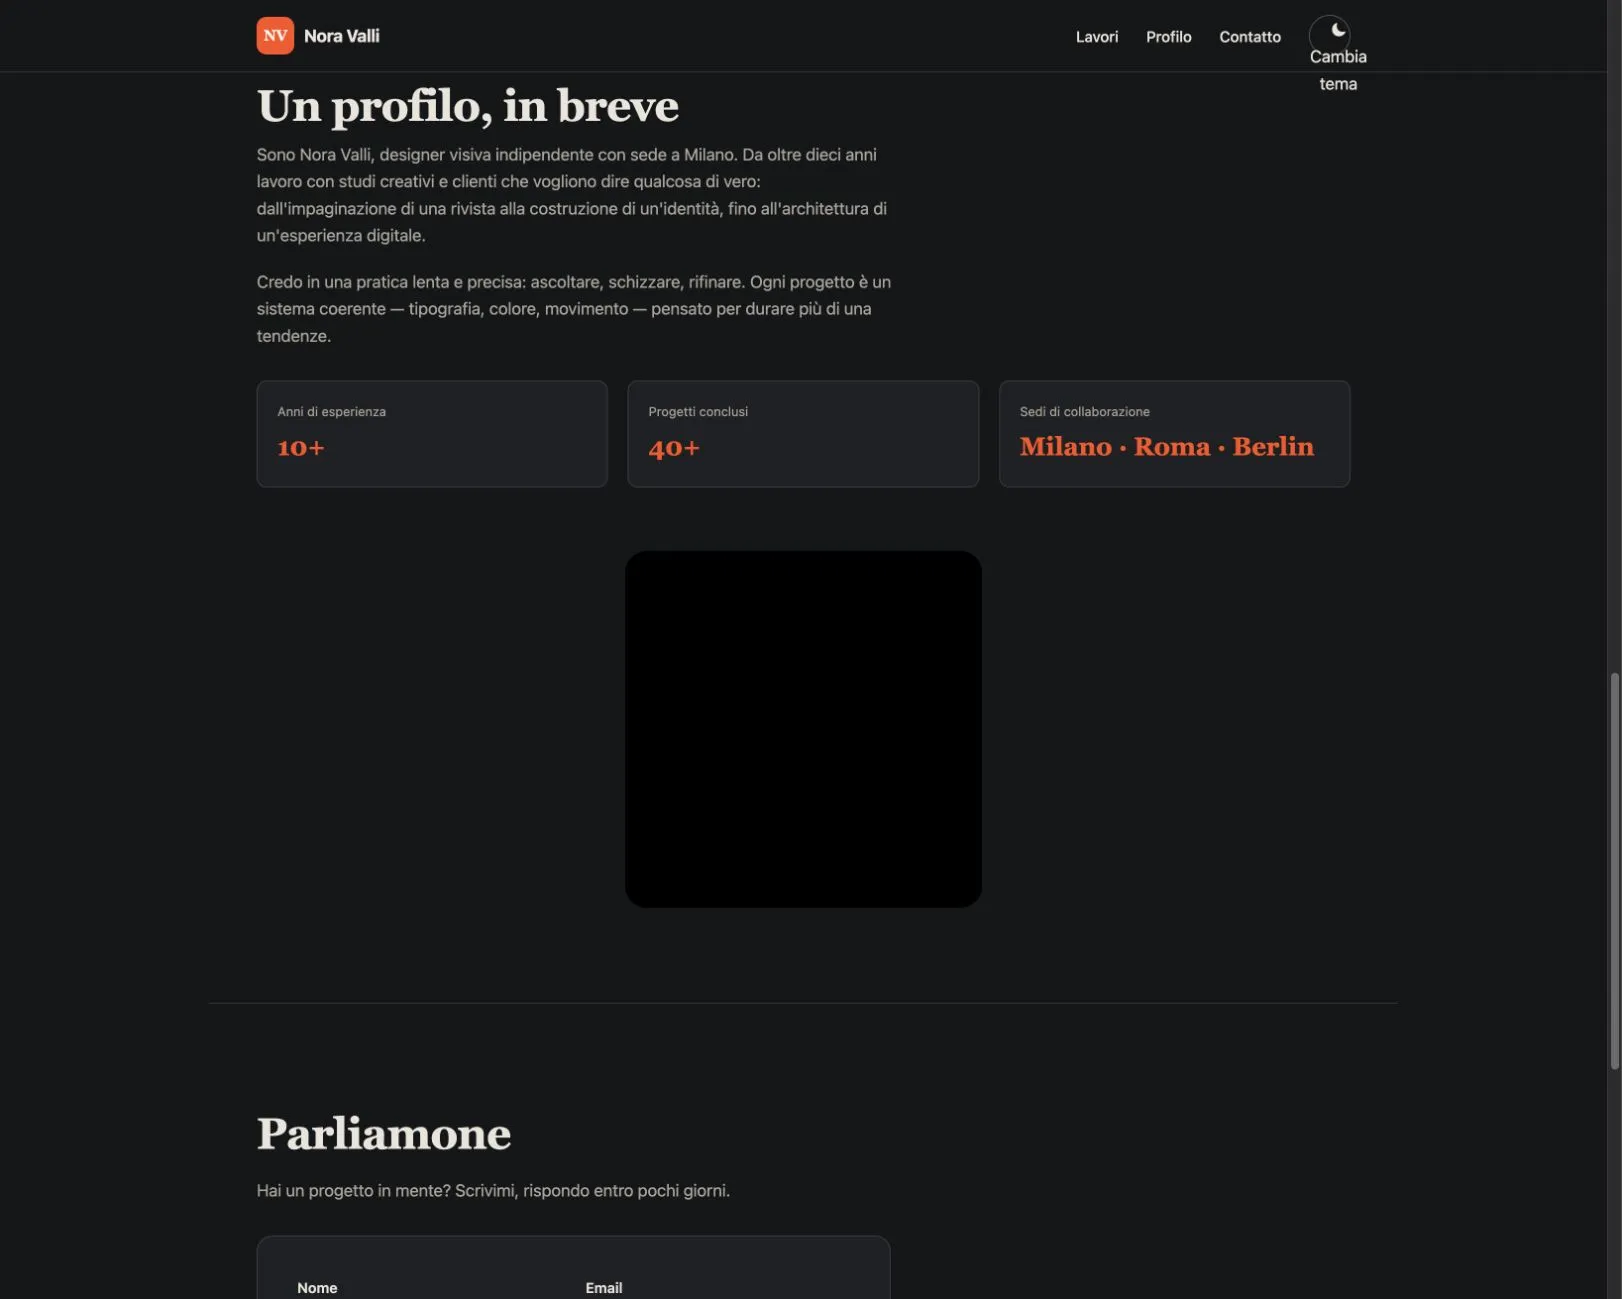
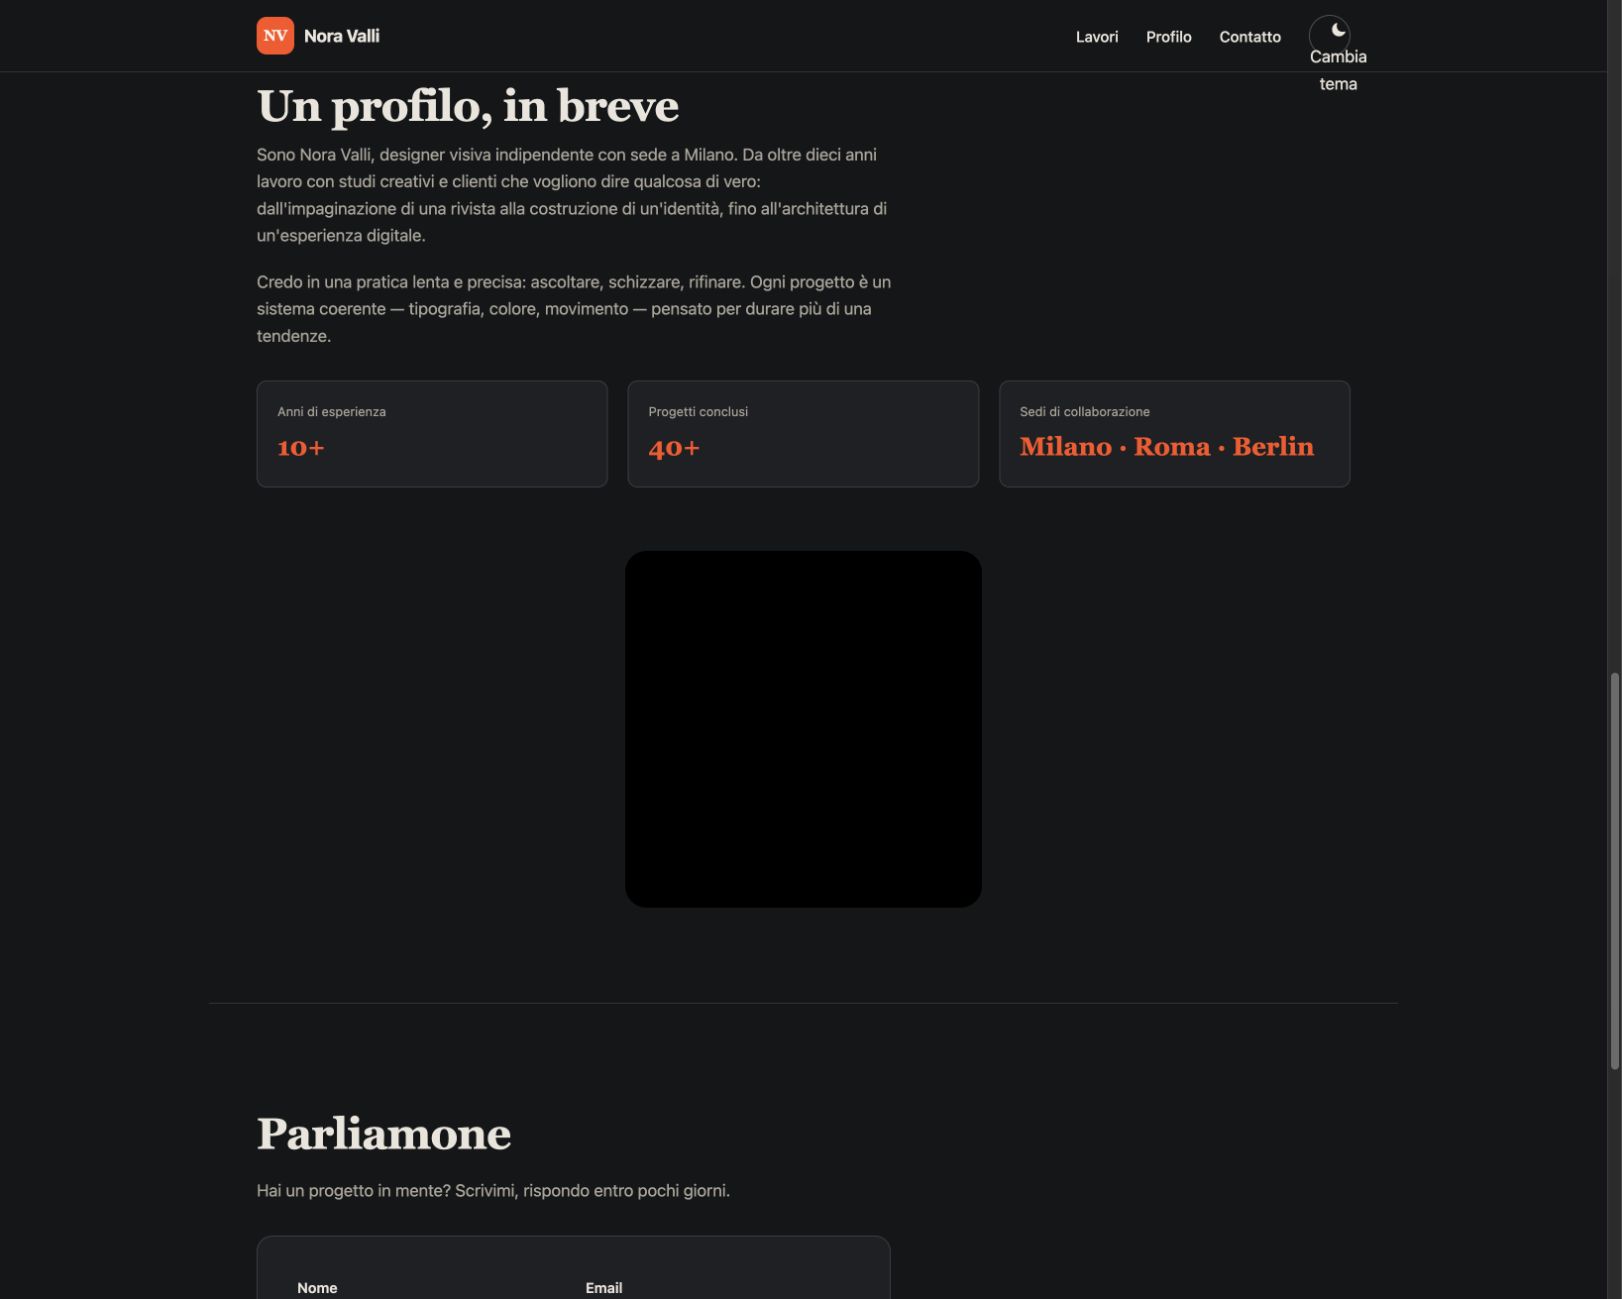
Eine dunkle Seite belegt keine dauerhafte Themespeicherung. Dafür müssen Wechsel, Neuladen und erhaltener Zustand verglichen werden. Anfangs las der Prüfer die Farbe zu früh, zu Beginn von Orniths Übergang: ein dokumentierter und korrigierter Fehlbefund, ohne dem Modell einen neuen Versuch zuzuschreiben.
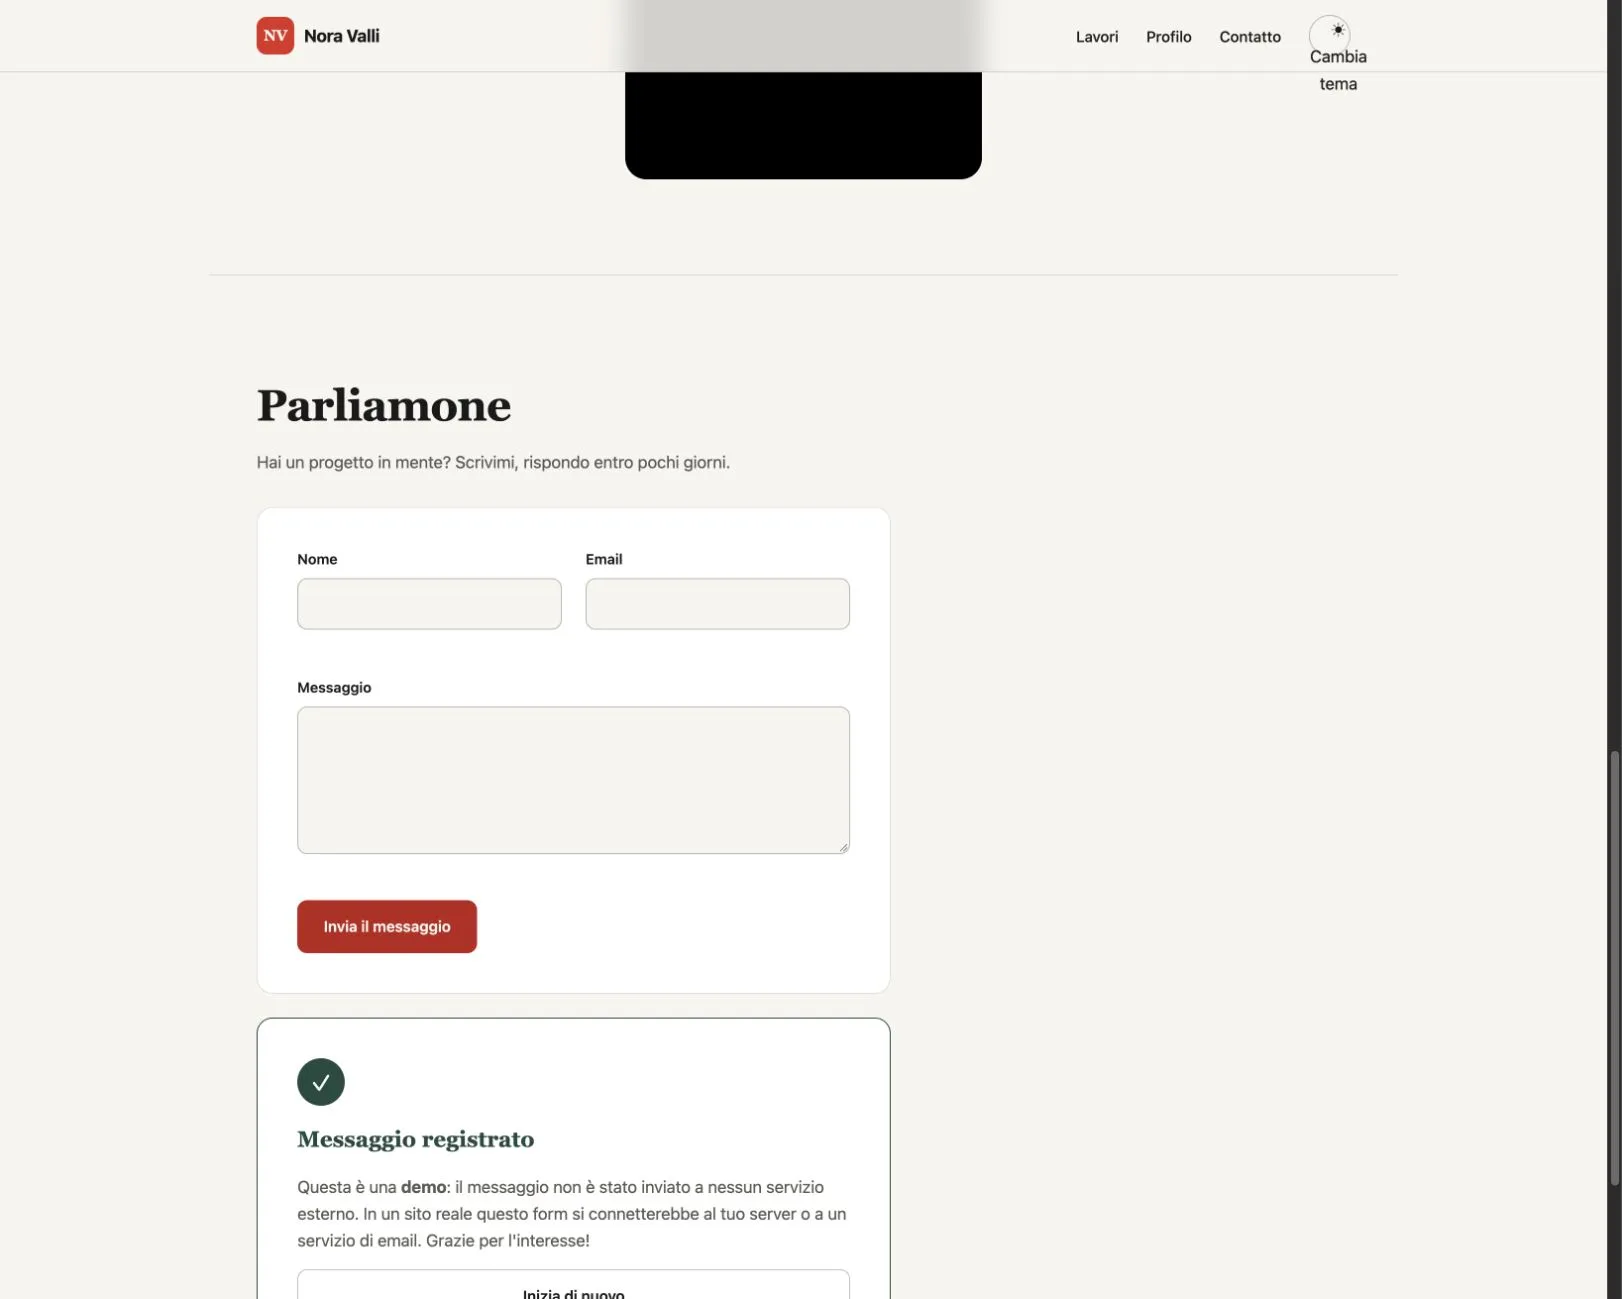
Das Formular musste fehlende Angaben und ungültige E-Mail-Adressen ablehnen und danach eine Demo-Eingabe lokal bestätigen. Verwendet wurden synthetische Daten. Der Hinweis „nichts gesendet“ ist für Leser nötig; das Fehlen externer Übertragungen wurde aber auch am Formularcode geprüft und nicht allein aus dem Versprechen der Seite abgeleitet.
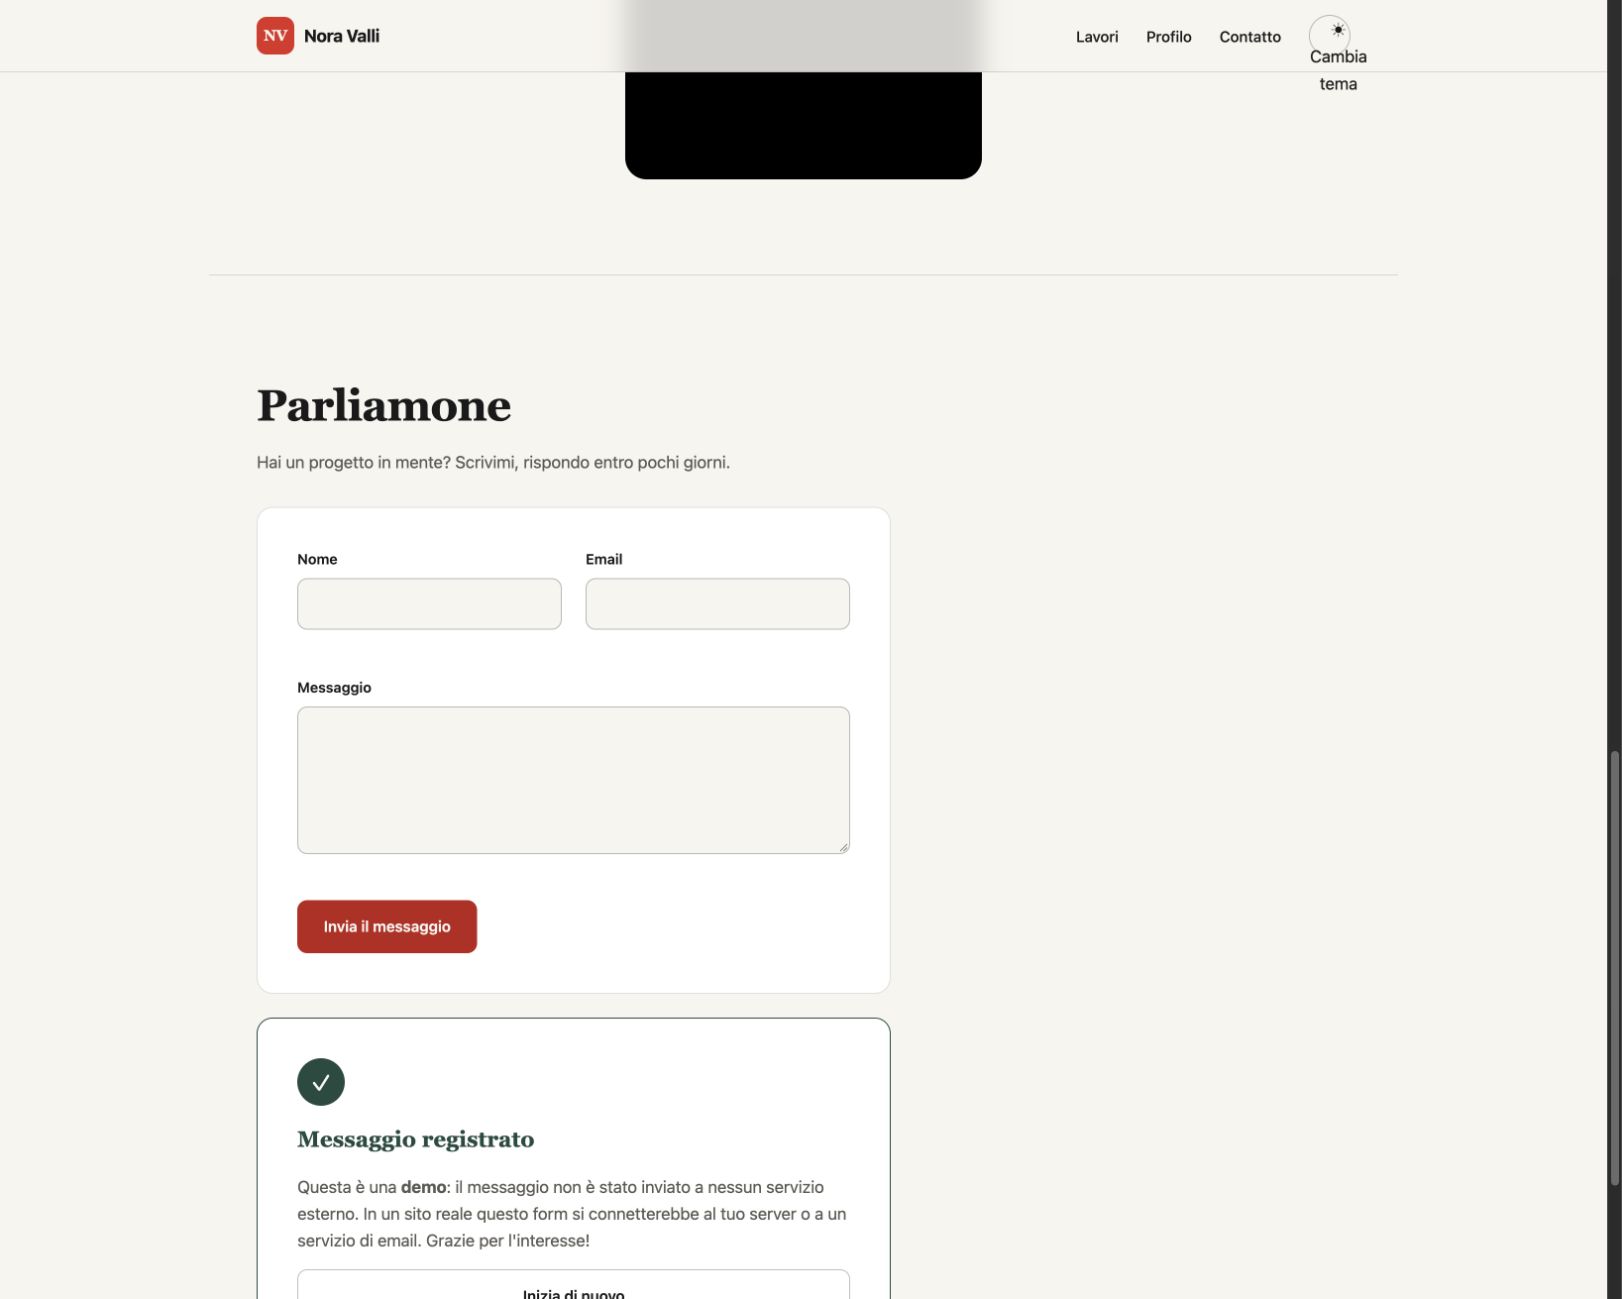
Das Smartphone zeigt weitere Probleme
Die folgenden vier Bilder stammen aus einem Viewport von 390×844. Der Browser reserviert 15 Pixel für die Scrollleiste; der Inhalt ist 375 Pixel breit. In allen drei Endfassungen betragen scrollWidth und clientWidth jeweils 375.
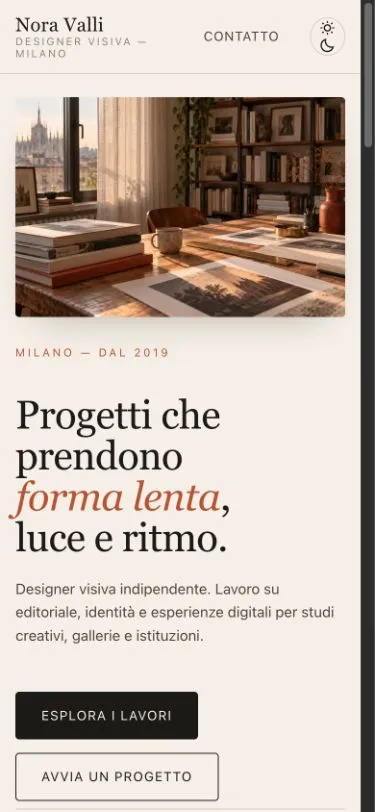
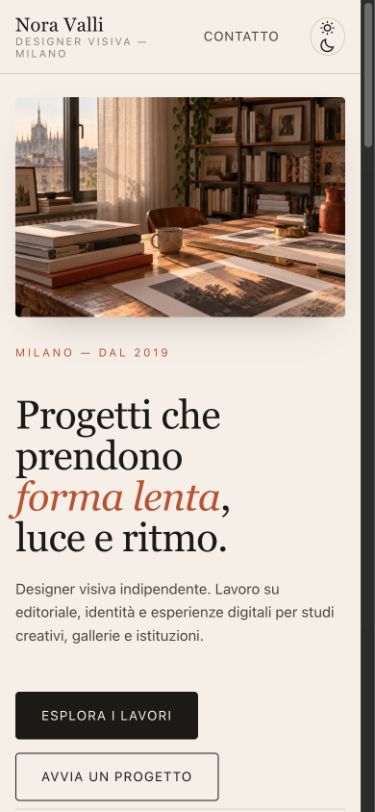
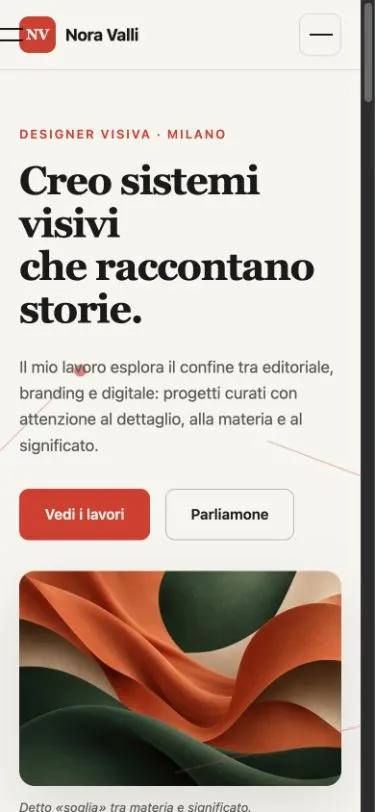
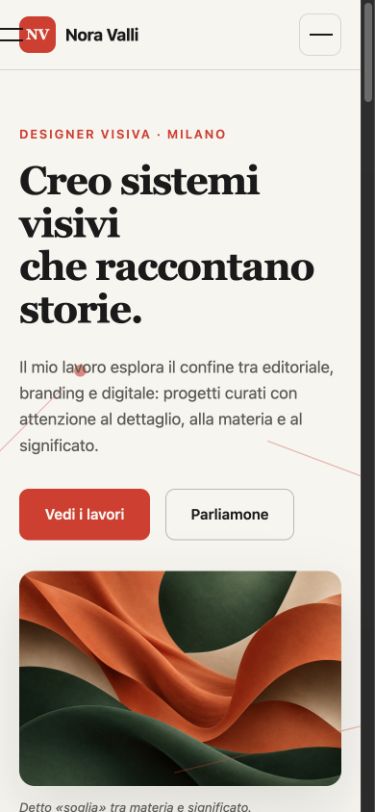
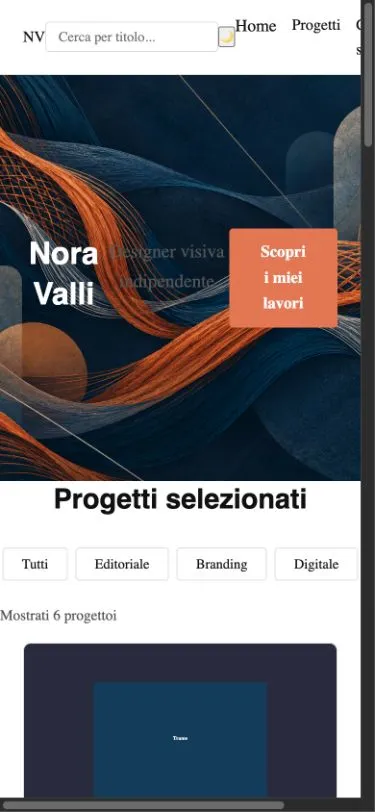
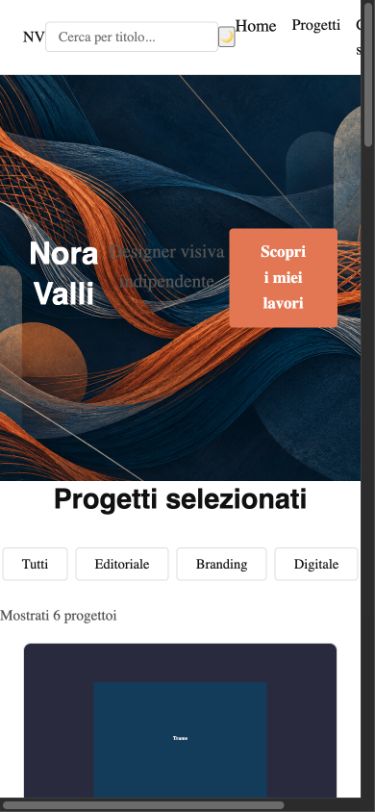
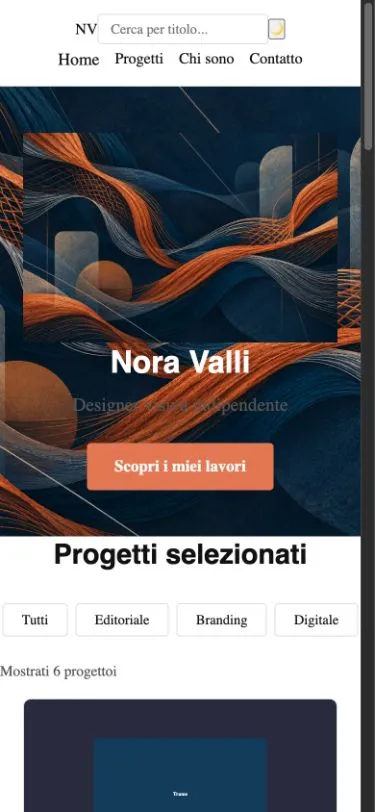
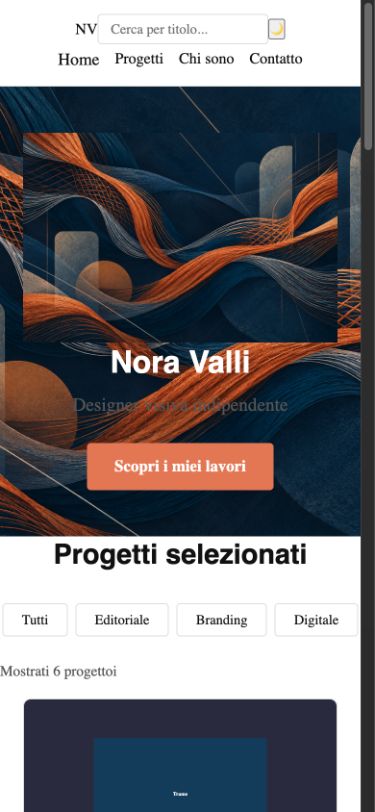
Fehlender Überlauf ist eine genaue, begrenzte Prüfung. Sie misst weder die Bequemlichkeit jeder Handlung noch sämtliche Textlesbarkeit oder kompositorische Balance. Dafür muss die Seite weiter genutzt und beobachtet werden.
Alle bei zehn, drei verschiedene Websites
Das sind die endgültigen Seiten, erneut aus Desktop-Viewports von 1440×900. Die ursprünglichen Portfoliobilder blieben bei den Korrekturen identisch. Der Code änderte Verhaltensweisen; der visuelle Aufbau lässt weiterhin drei Ergebnisse erkennen.
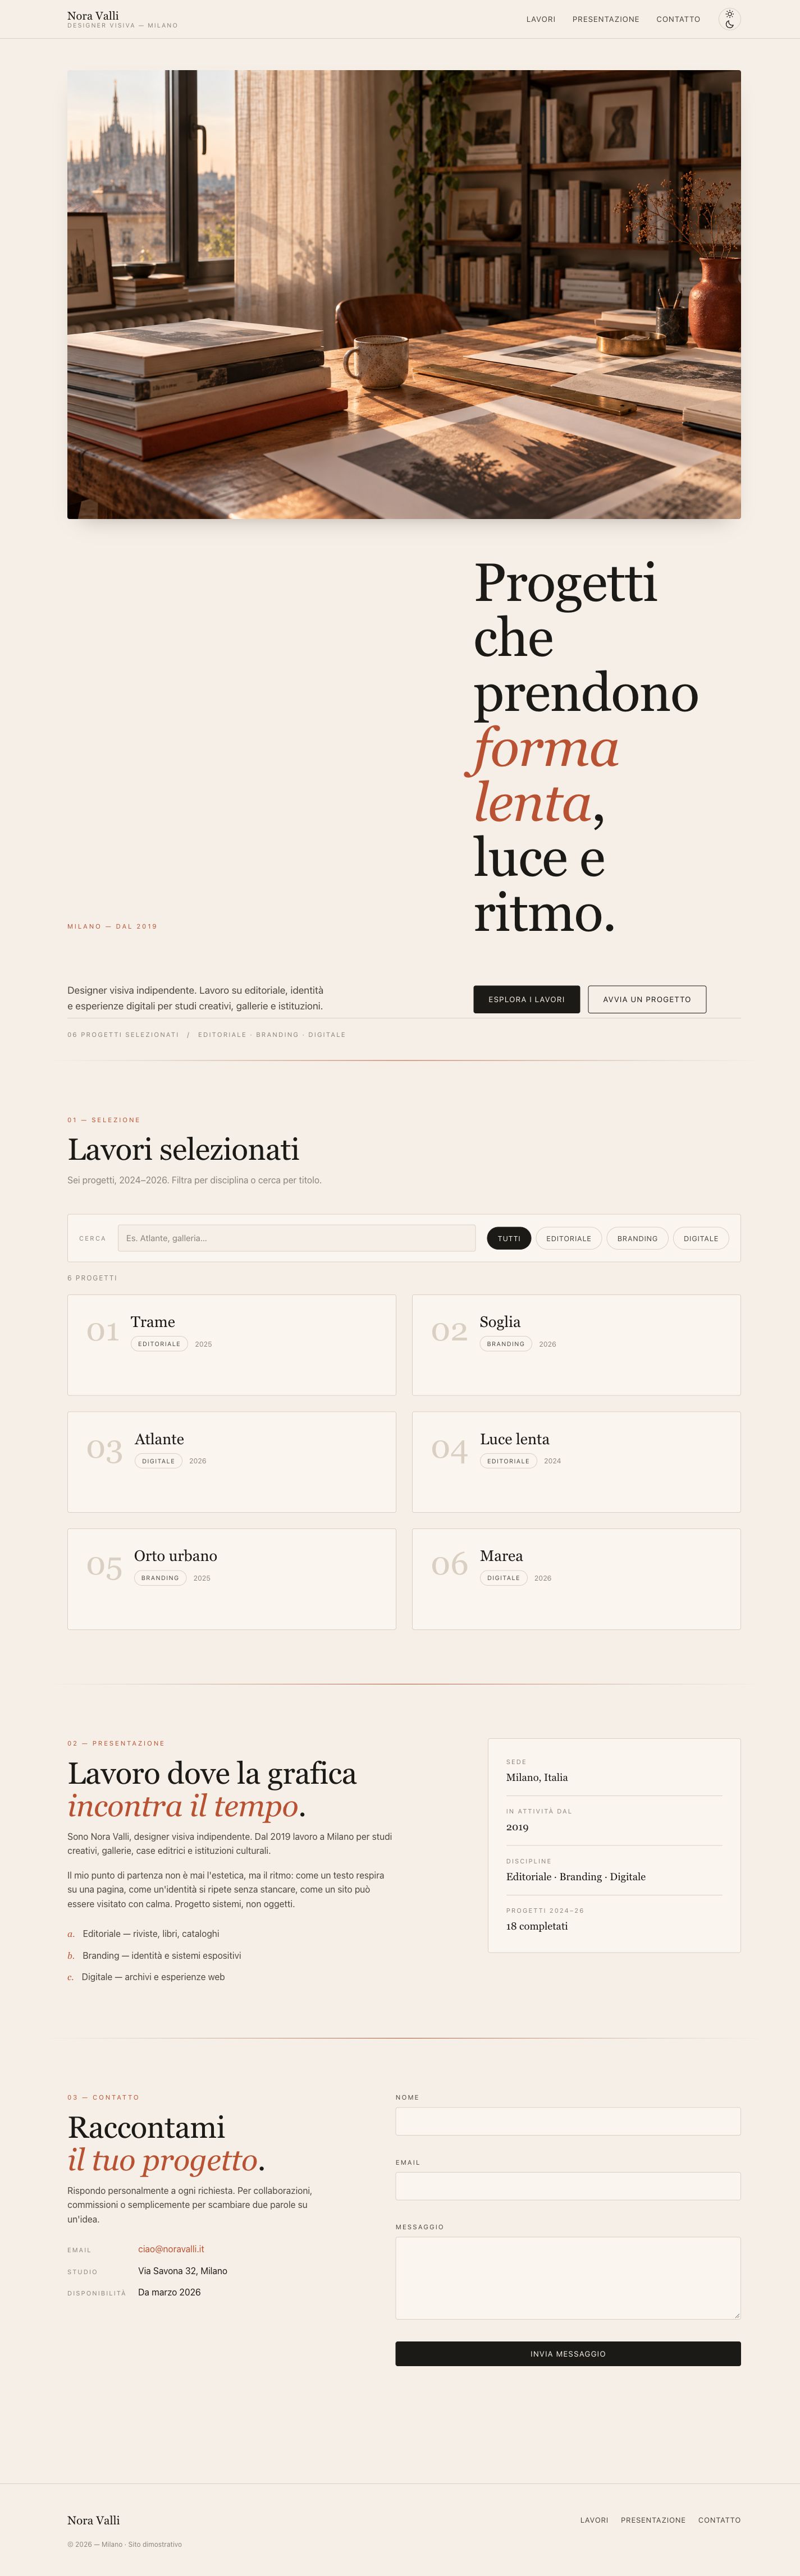
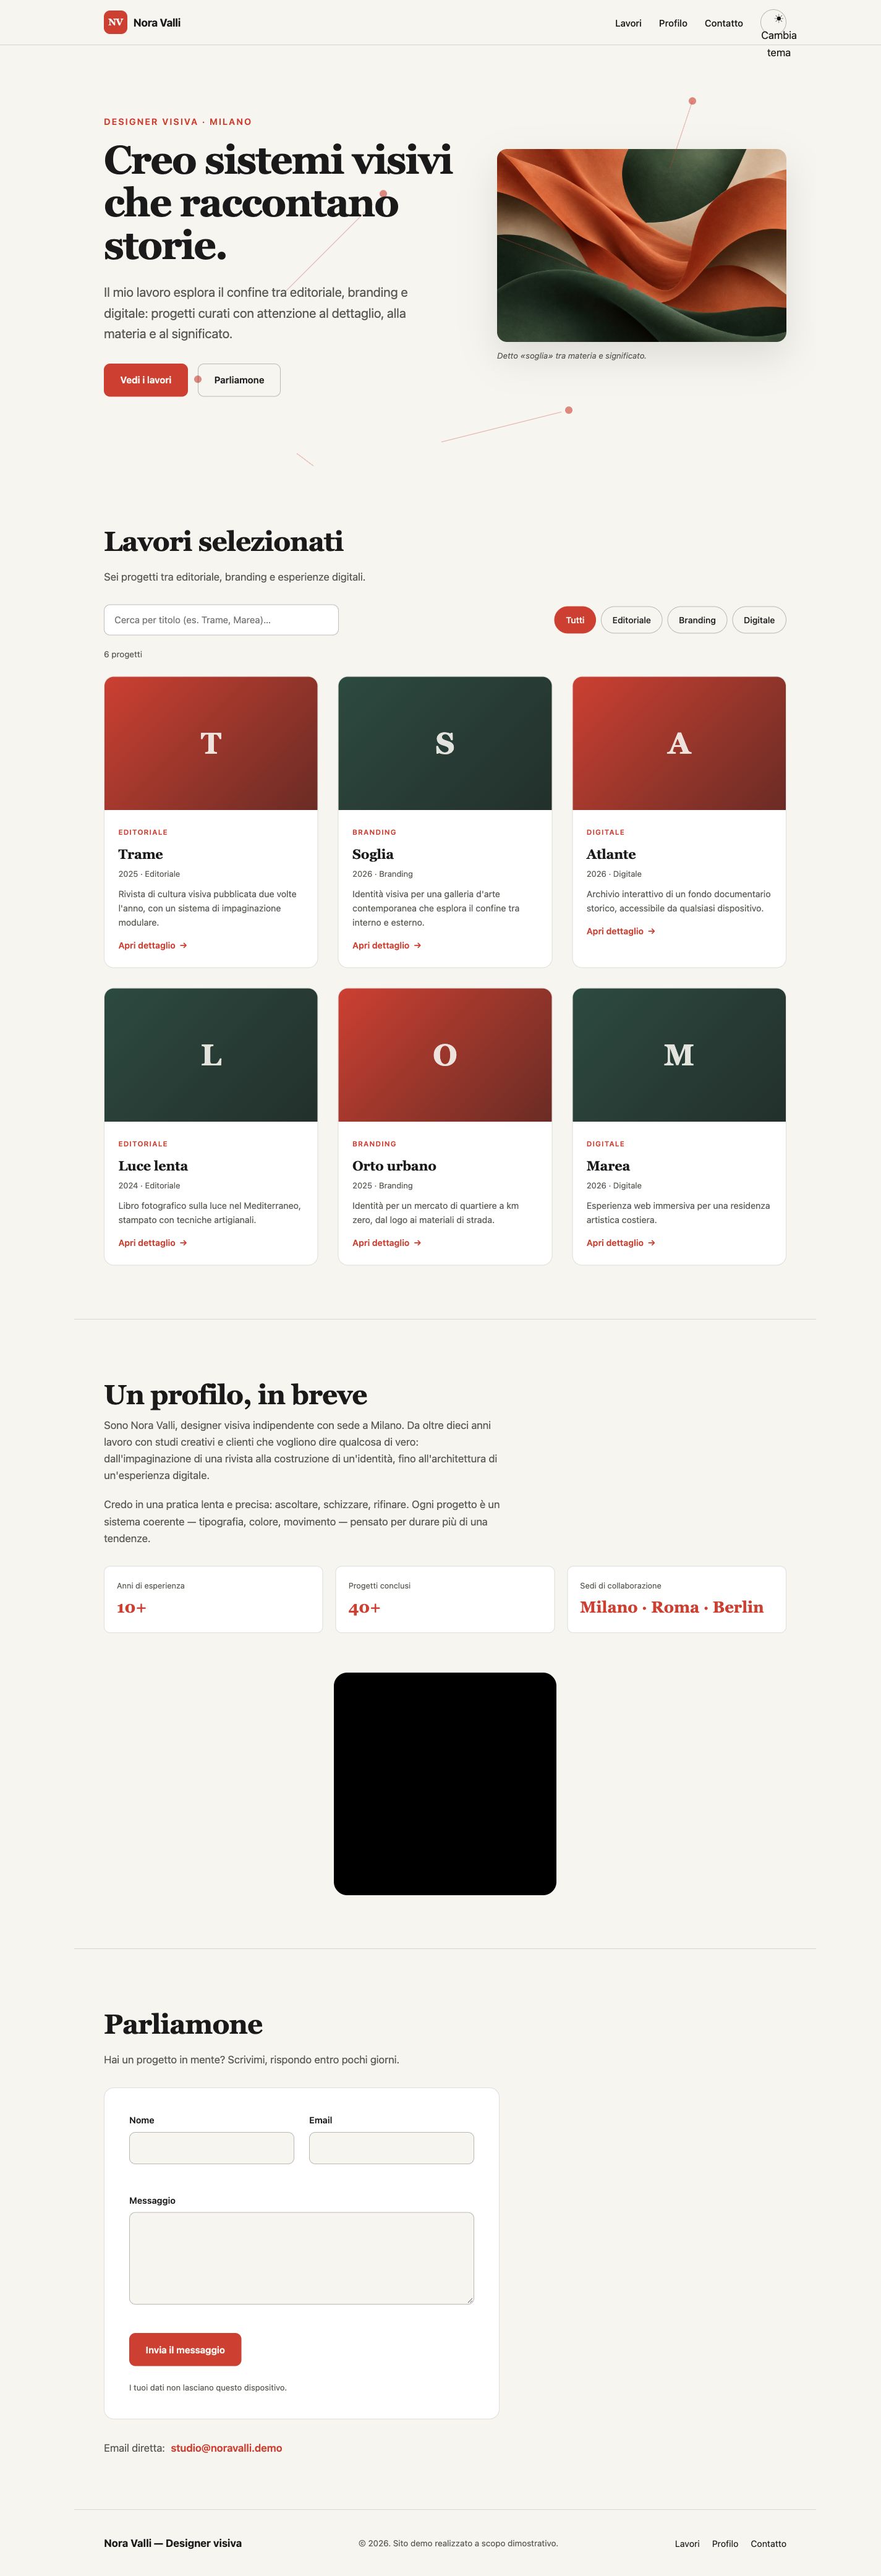
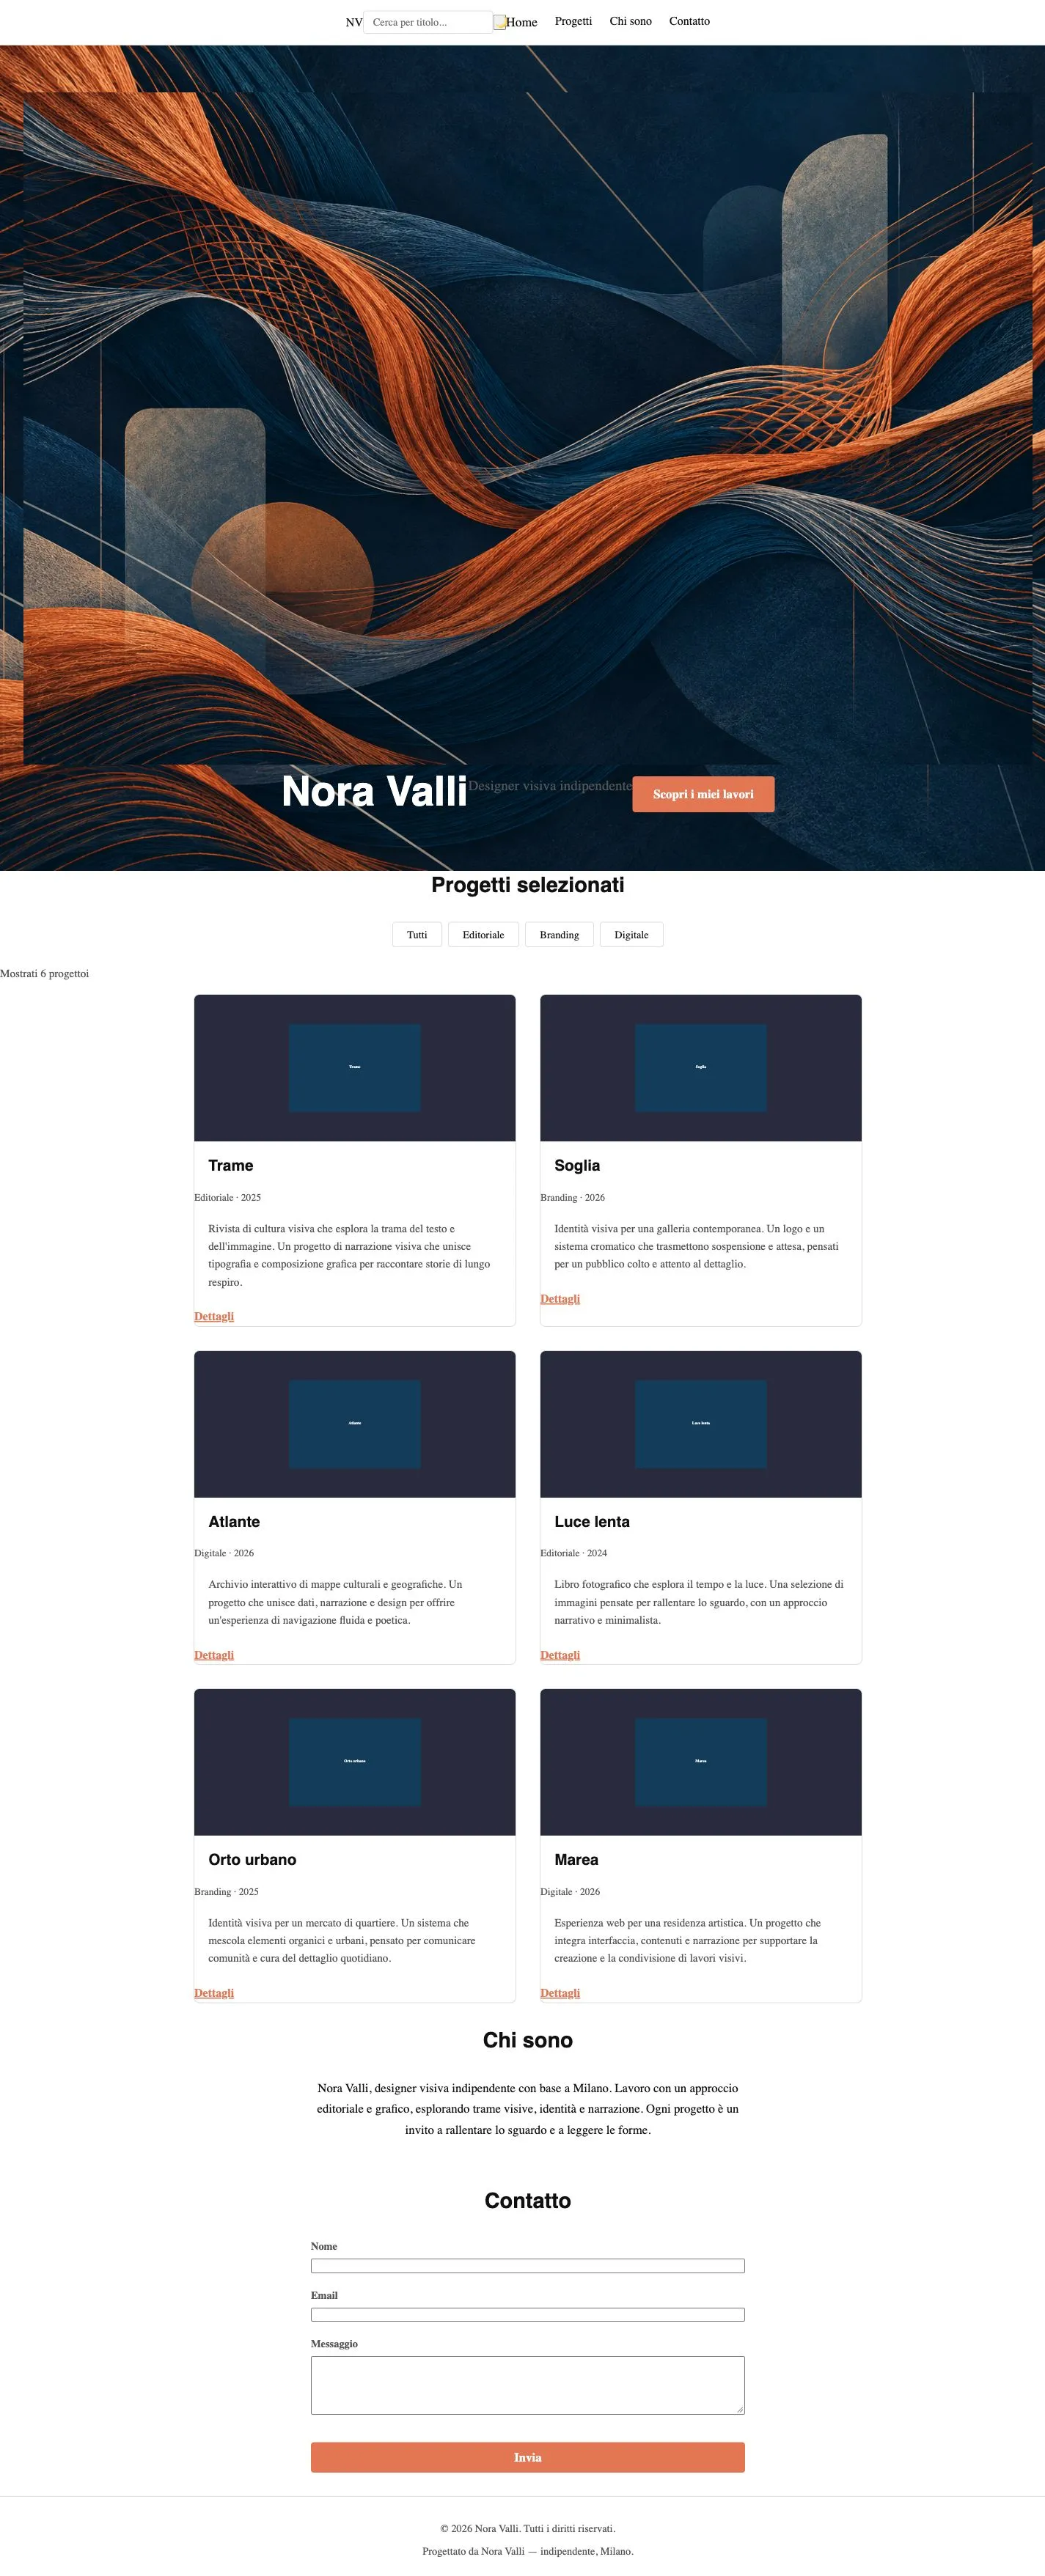
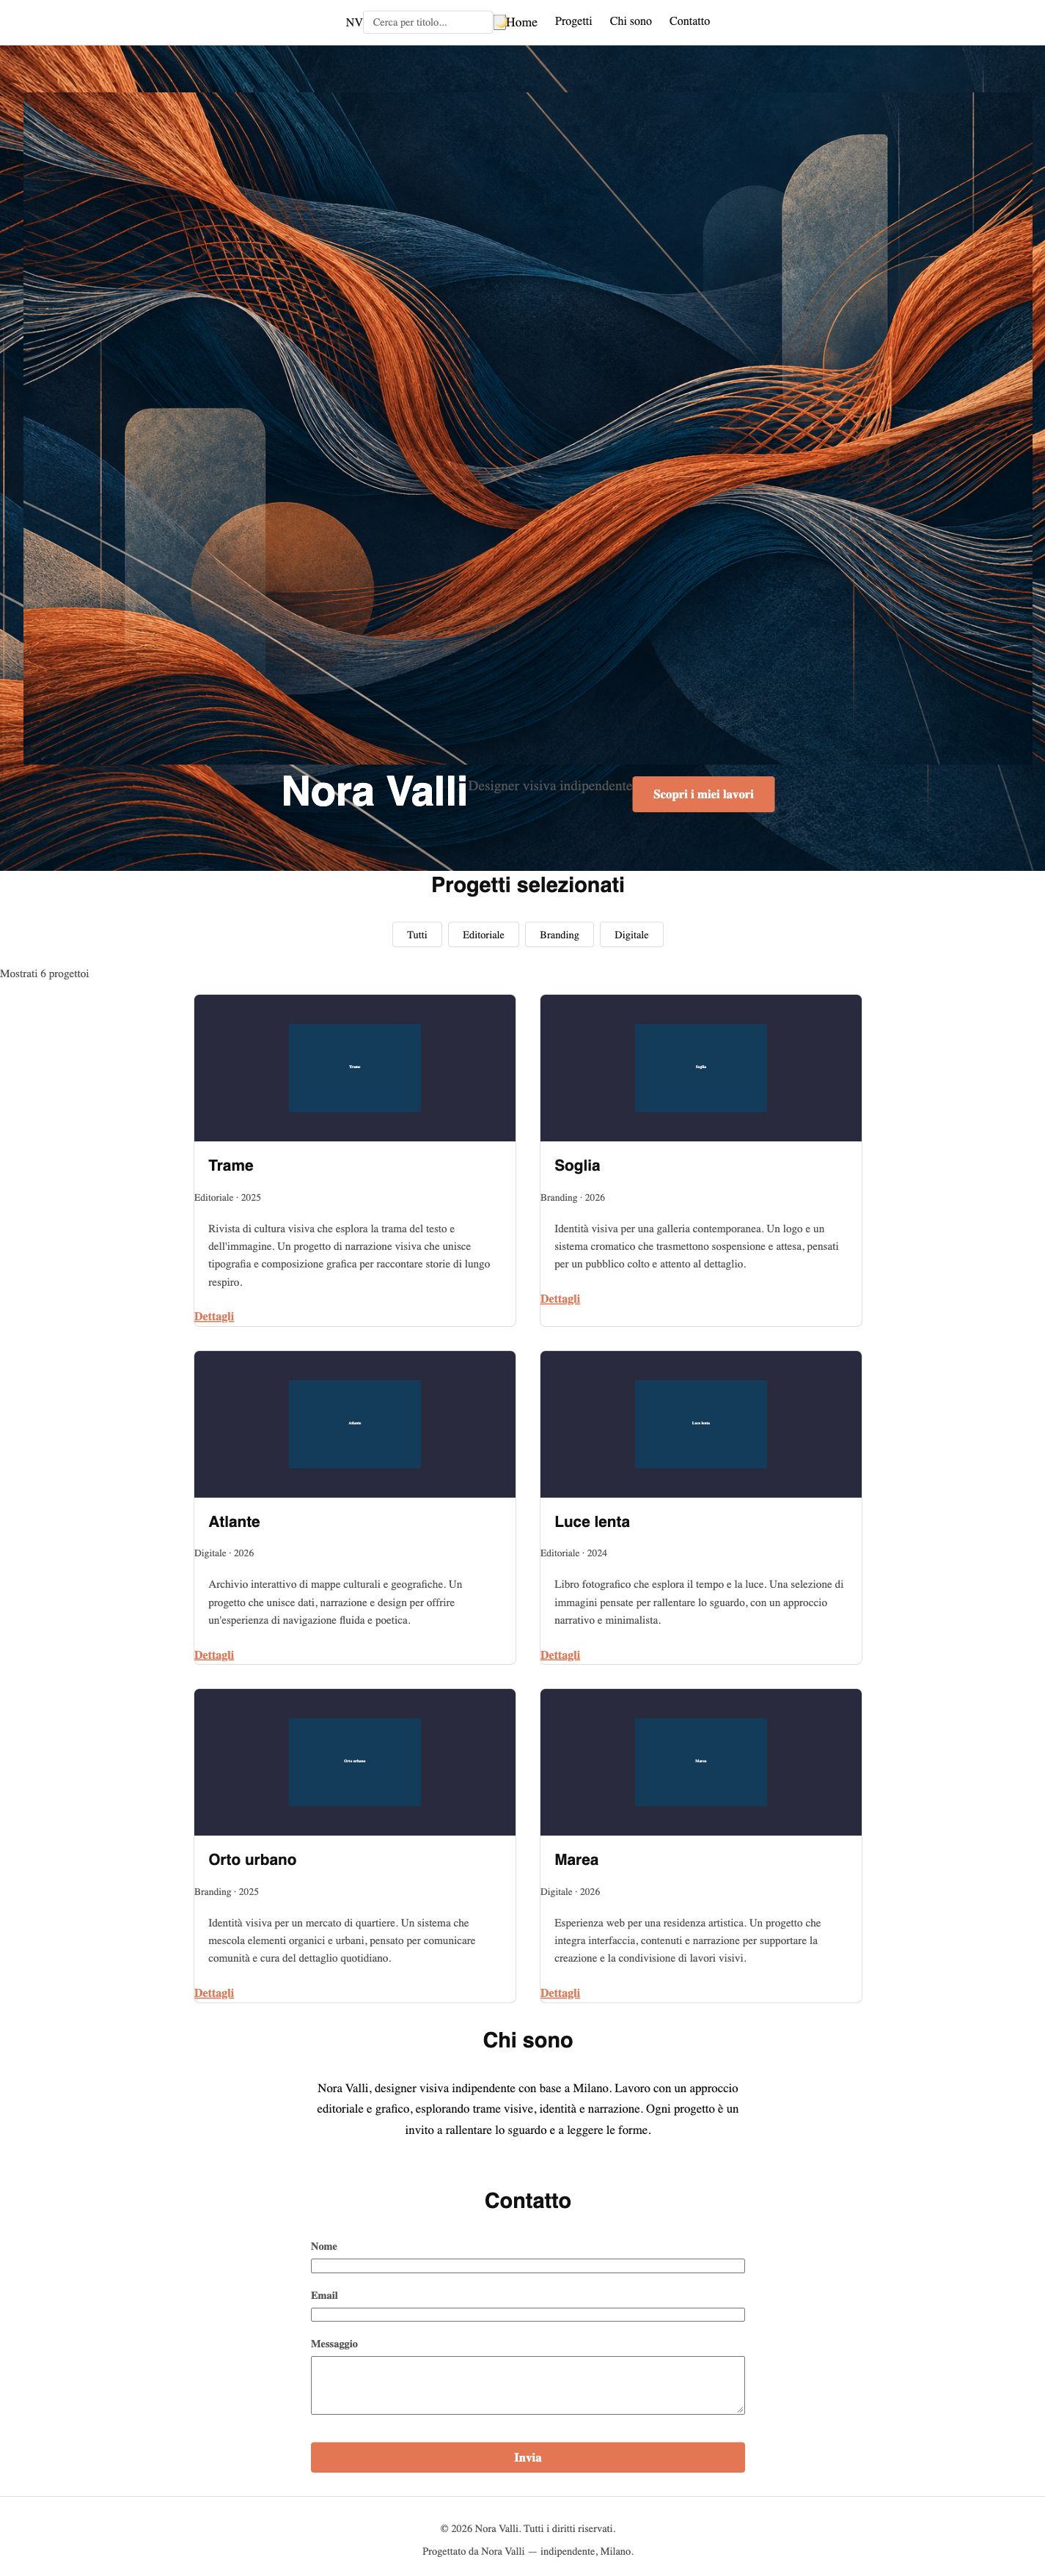
In meinem abschließenden Urteil bevorzuge ich Qwens ästhetisches Ergebnis, Ornith finde ich sehr gut, LFM überzeugt mich nicht. Sein 10/10 ändert diese Wahl nicht. Die Zahl zählt Funktionsprüfungen, die vor der Korrektur festgelegt und im Audit präzisiert wurden; sie ist keine Gesamtnote für Webdesign.
Auch außerhalb der Testsuite bleiben Fehler. LFMs endgültiger Bildalternativtext ist allgemein gehalten. Qwens HTML-Attribute brauchen Überarbeitung. Formular- und Zählertexte benötigen redaktionelle Aufmerksamkeit. Eine für andere nutzbare Website müsste weiter geprüft werden.
Erfasste Zeit und nicht mitgezählte Arbeit
| Konfiguration | Erste Fassung | Korrektur | Gesamt | Erfasste Ausgabe bei der Korrektur |
|---|---|---|---|---|
| Qwen | 1656,4 s | 2470,1 s | 4126,6 s | mindestens 7581 Tokens |
| Ornith | 505,3 s | 48,2 s | 553,4 s | 873 Tokens |
| LFM | 161,3 s | 2070,6 s | 2232,0 s | 139.532 Tokens |
Die Laufzeiten misst das Programm, das jeden Durchlauf startet und beendet, der Runner. Sie umfassen Start, Serverwartezeiten, Agentenarbeit und abschließendes Aufräumen. Es sind weder reine GPU-Zeiten noch enthalten sie sämtliche Koordinations- und Bewertungsarbeit. Anfragezeiten umfassen Kontextverarbeitung, Generierung und lokale Kommunikation und überschneiden sich mit der Runner-Zeit; ihre Addition würde doppelt zählen.
Bei Qwen gab es Zeitüberschreitungen und eine abgebrochene Anfrage ohne abschließende Tokenzählung. Die erfassten Tokens sind deshalb eine Untergrenze, sowohl anfangs als auch bei der Korrektur. Neue Eingaben und Cache-Lesevorgänge betrugen bei der Korrektur 849.146 und null für Qwen, 18.149 und 76.388 für Ornith sowie 863.073 und 1.108.820 für LFM. Das sind wiederholte Zählungen je Anfrage, keine Korpora einzigartiger Wörter. Tokenizer und Backends unterscheiden sich.
Der API-Wert für gesonderte Reasoning-Tokens ist nicht verfügbar, als NA gekennzeichnet. Die normalisierte Null in Pis Aufzeichnungen beweist kein fehlendes Reasoning. Für LFM wurden 84 ausgegebene Thinking-Blöcke aufbewahrt und ihr Text erneut in 87.101 Tokens zerlegt: ein abgeleitetes Maß eines Ausgabeteils, weder zum Gesamtwert zu addieren noch als Zugang zu innerem Denken zu bezeichnen. Eine verlässliche Zeitmessung des Reasonings gibt es nicht.
Auch die Tokens des Koordinators und die Kosten des Bildgenerators wurden nicht gemessen. Aus diesen Zahlen leite ich keine finanziellen, energetischen oder gesamten Systemkosten ab.
Nach dem Versuch habe ich LFM deinstalliert: etwa 13,59 GB Gewichte und Startdateien entfernt. Das Versuchsarchiv bleibt unverändert.
Was diesen Versuch überprüfbar macht
Am Ende wurde dieselbe eingefrorene Testsuite auf allen 19 aufbewahrten Fassungen erneut ausgeführt: drei Baselines und sechzehn Korrekturen. Die 190 Einzelurteile stimmen mit den maßgeblichen Punktzahlen überein. Diese Neubewertung prüft die Artefaktkonsistenz nach Prüferkorrekturen; sie fügt keine Inferenzwiederholungen hinzu.
Das Korrekturprotokoll entstand nach Sichtung der Ausgangsfassungen. Spätere Anpassungen sind in den Änderungen verzeichnet. Die Reihenfolge war nicht randomisiert, Ausgangsfehler unterschieden sich und die Hilfe wurde sehr ungleich, vor allem bei LFM. Cache, Backends und Systemaktivität waren weder gleich noch isoliert. Der operative Koordinator war eine KI, kein unabhängiger menschlicher Prüfer. Das spätere ästhetische Urteil ist meines.
Mit einem Verlauf je Checkpoint und einem einzigen Portfolio beschreiben die Daten einen Fall. Sie erlauben weder eine allgemeine Rangliste noch eine statistische Erfolgswahrscheinlichkeit oder eine kausale Erklärung der Thinking-Wirkung. Die Tests waren bekannt und die Rückmeldungen bezogen sich darauf: Zehn von zehn misst die Korrektur dieser Aufgabe.
Für meine Arbeit nehme ich einen konkreten Maßstab mit: versprochene Handlungen prüfen, die Seite auch nach der Punktzahl beobachten und nötige Hilfestellung mitzählen. Ob ein Ergebnis verwendet wird, bleibt dem Urteil der Menschen überlassen, die damit arbeiten sollen.
Daten, Quellen und Herkunft
- Daten je Iteration, CSV, JSON-Ergebnisse und JSON-Zusammenfassung.
- Korrekturprotokoll, zusammen mit Änderungen, Rollen und ästhetischem Urteil zu lesen.
- Nachweisverzeichnis und Handlungen, URLs und Viewports der redaktionellen Aufnahmen. Die historischen Prüfungen stehen im Materialpaket; es sind keine neuen Inferenzläufe. Einige Randmarkierungen stammen vom Browser oder von Erweiterungen.
- Qwen-Repository in der getesteten Revision, Ornith mit ebenso fixierter Kennung, LFM-Quantisierungskarte.
Das öffentliche Paket enthält ausgewählte Daten, Methodendokumente, Prüfungen und Bilder. Das SHA256-Manifest ermöglicht die Prüfung heruntergeladener Dateien. Lokale Pfade und URLs wurden aus Dokumentkopien entfernt; Original-Rasterbilder bleiben unretuschiert. Das spätere ästhetische Urteil bleibt von den Funktionswertungen getrennt.