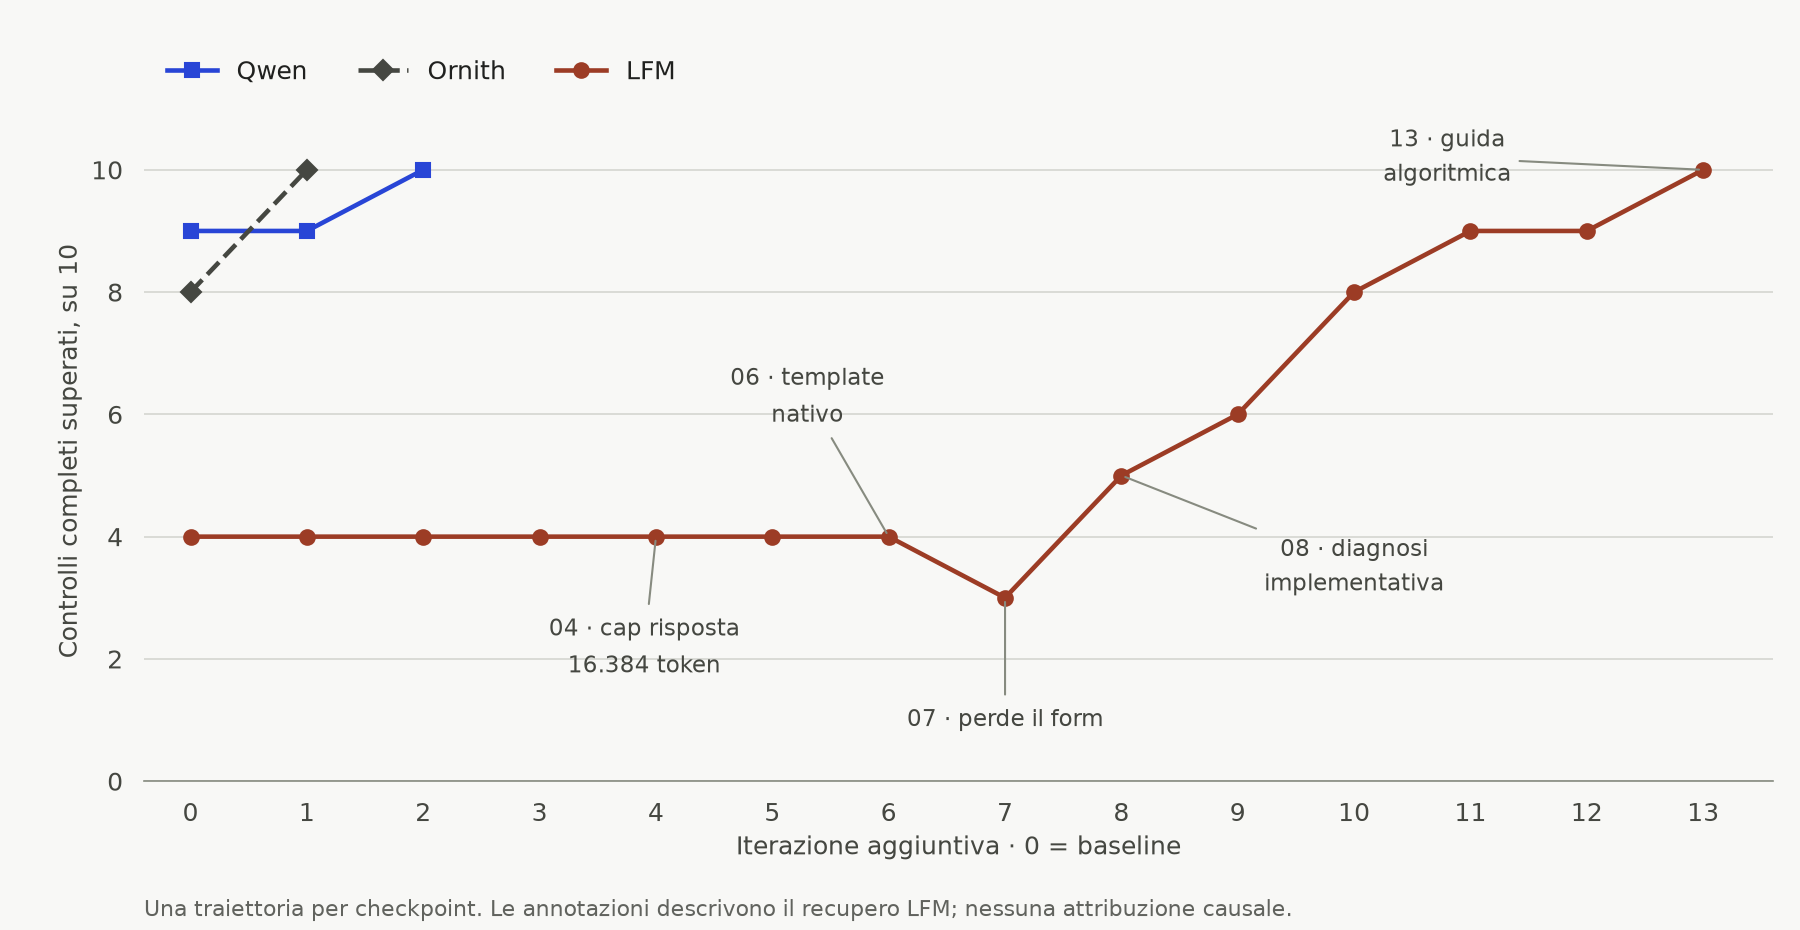
Ho chiesto a tre modelli locali di costruire lo stesso portfolio. Alla fine tutti hanno superato dieci verifiche funzionali. Il mio giudizio sui siti è rimasto molto diverso: Qwen il migliore sul piano estetico, Ornith molto buono, LFM bocciato. Dopo la prova ho disinstallato LFM.
Fra queste due valutazioni c’è il motivo per cui vale la pena guardare il lavoro da vicino. Un filtro può funzionare dentro una pagina che non convince. Una composizione riuscita può nascondere quattro schede impossibili da aprire. Il tempo per arrivare a un risultato dipende anche da quanto aiuto siamo disposti a dare.
Quello che segue è il racconto di una prova svolta sul mio Mac il 23 e 24 ottobre 2026: un compito, un percorso documentato per ciascuna delle tre configurazioni provate. I file, i passaggi falliti e le correzioni sono stati conservati. Le immagini permettono di vedere che cosa è cambiato; i log servono a verificare ciò che uno screenshot non può dimostrare.
Un portfolio inventato, richieste concrete
Nora Valli è una designer immaginaria. Anche i lavori del portfolio sono inventati: Trame e Luce lenta per l’editoriale, Soglia e Orto urbano per il branding, Atlante e Marea per il digitale. Nomi, categorie e anni erano fissati dal brief. Le descrizioni potevano essere scritte dai modelli.
La consegna richiedeva tre file funzionanti, HTML, CSS e JavaScript, senza framework, CDN o font remoti. Ricerca e filtri dovevano combinarsi, il contatore seguire i risultati e lo stato vuoto comparire al momento giusto. Ogni progetto doveva aprire un dettaglio coerente, con chiusura, Escape e gestione del focus. Servivano inoltre tema persistente, presentazione, form dimostrativo e layout senza overflow a 390 e 1440 pixel.
Per la prima realizzazione ciascun modello poteva richiedere una sola immagine a un generatore esterno comune. Sceglieva il prompt e dove collocare il file restituito. I pixel erano prodotti da quel servizio: attribuirli al modello locale confonderebbe due lavori diversi. Durante il recupero i tre file immagine sono rimasti invariati: lo conferma il confronto delle loro impronte digitali.
Il coordinatore della prova era un assistente AI: ha predisposto strumenti e verifiche, scritto feedback e, nelle fasi avanzate di LFM, fornito diagnosi e indicazioni algoritmiche. I modelli locali hanno scritto e modificato i file attraverso strumenti controllati; non disponevano di browser o shell e non vedevano il lavoro dei concorrenti. Nessuna correzione manuale è stata applicata ai portfolio.
Per dare ai modelli accesso ai file è stato usato Pi, un agente di programmazione che collega le loro risposte agli strumenti di lettura e scrittura. I modelli venivano eseguiti con MLX, un framework per il calcolo sui chip Apple Silicon, attraverso i due backend indicati nella scheda tecnica. È il software che organizza e fa girare la prova; la verifica delle pagine avveniva separatamente nel browser.
Il Mac e l’ambiente di prova
| Componente | Configurazione della macchina usata |
|---|---|
| Computer | MacBook Pro 16 pollici, 2026; identificatore Mac17,8 |
| Processore | Apple M5 Pro |
| CPU | 18 core: 6 super core e 12 performance core |
| GPU | 20 core |
| RAM | 48 GB di memoria unificata; il sistema rileva 51.539.607.552 byte, pari a 48 GiB |
| Banda di memoria | 307 GB/s nominali, secondo Apple; non misurati in questa prova |
| Neural Engine | 16 core secondo Apple; il suo impiego non è misurato dal benchmark |
| Sistema operativo | macOS 27.0.1, build 26A434 |
| Alimentazione | Collegato alla rete elettrica nel rilevamento iniziale |
| Agente | Pi 1.2.0 |
| Runtime | Node 26.11.1; Python 3.15.0, per gli script della prova |
| Browser di verifica | Chrome 155.0.8059.85 |
| Backend Qwen | mlx-vlm 0.6.15, MLX 0.32.1 |
| Backend Ornith e LFM | mlx-lm 0.32.2, MLX 0.32.4 |
Chip, memoria, alimentazione, sistema e GPU sono documentati nei log dell’esperimento. Il modello preciso del Mac e il dettaglio dei core CPU sono stati aggiunti con un inventario locale successivo, sempre il 24 ottobre: nessun numero di serie o UUID è incluso. L’identificatore corrisponde al MacBook Pro 16 pollici del 2026; la denominazione dei core e le specifiche nominali vengono dalle specifiche Apple.
I modelli sono stati eseguiti uno alla volta. Durante la prova il Mac eseguiva anche altre attività: il carico del sistema non era isolato. La capacità fisica dell’SSD, il consumo energetico e le prestazioni termiche non sono stati misurati. La banda nominale di memoria non va letta come velocità di generazione osservata.
| Nome usato nel racconto | Checkpoint effettivo | Revisione |
|---|---|---|
| Qwen | orcarouter/Qwen3.8-27B-Uncensored-MLX, variante 4-bit | 34c32b5b1b2c24181e121a5cba3df8924fa66bce |
| Ornith | ornith-ai/Ornith-1.5-35B-A3B-MLX-4bit | 19504d912fa8fc7622bf6b1de3db5d5d890b1f02 |
| LFM | LiquidAI/LFM2.5-24B-A2B-MLX-4bit | 667408d494bde191c2cb9dd4f4549827816b9275 |
Queste versioni precise dei modelli, chiamate checkpoint, identificano le configurazioni provate. Non sono rappresentanti intercambiabili di intere famiglie. Le identità sono riscontrate nelle schede dei repository alle revisioni indicate. Il nome comunitario di Qwen è conservato per intero: questa prova non ha valutato le capacità suggerite dalla parola “uncensored”.
Tre direzioni visive, prima dei punteggi
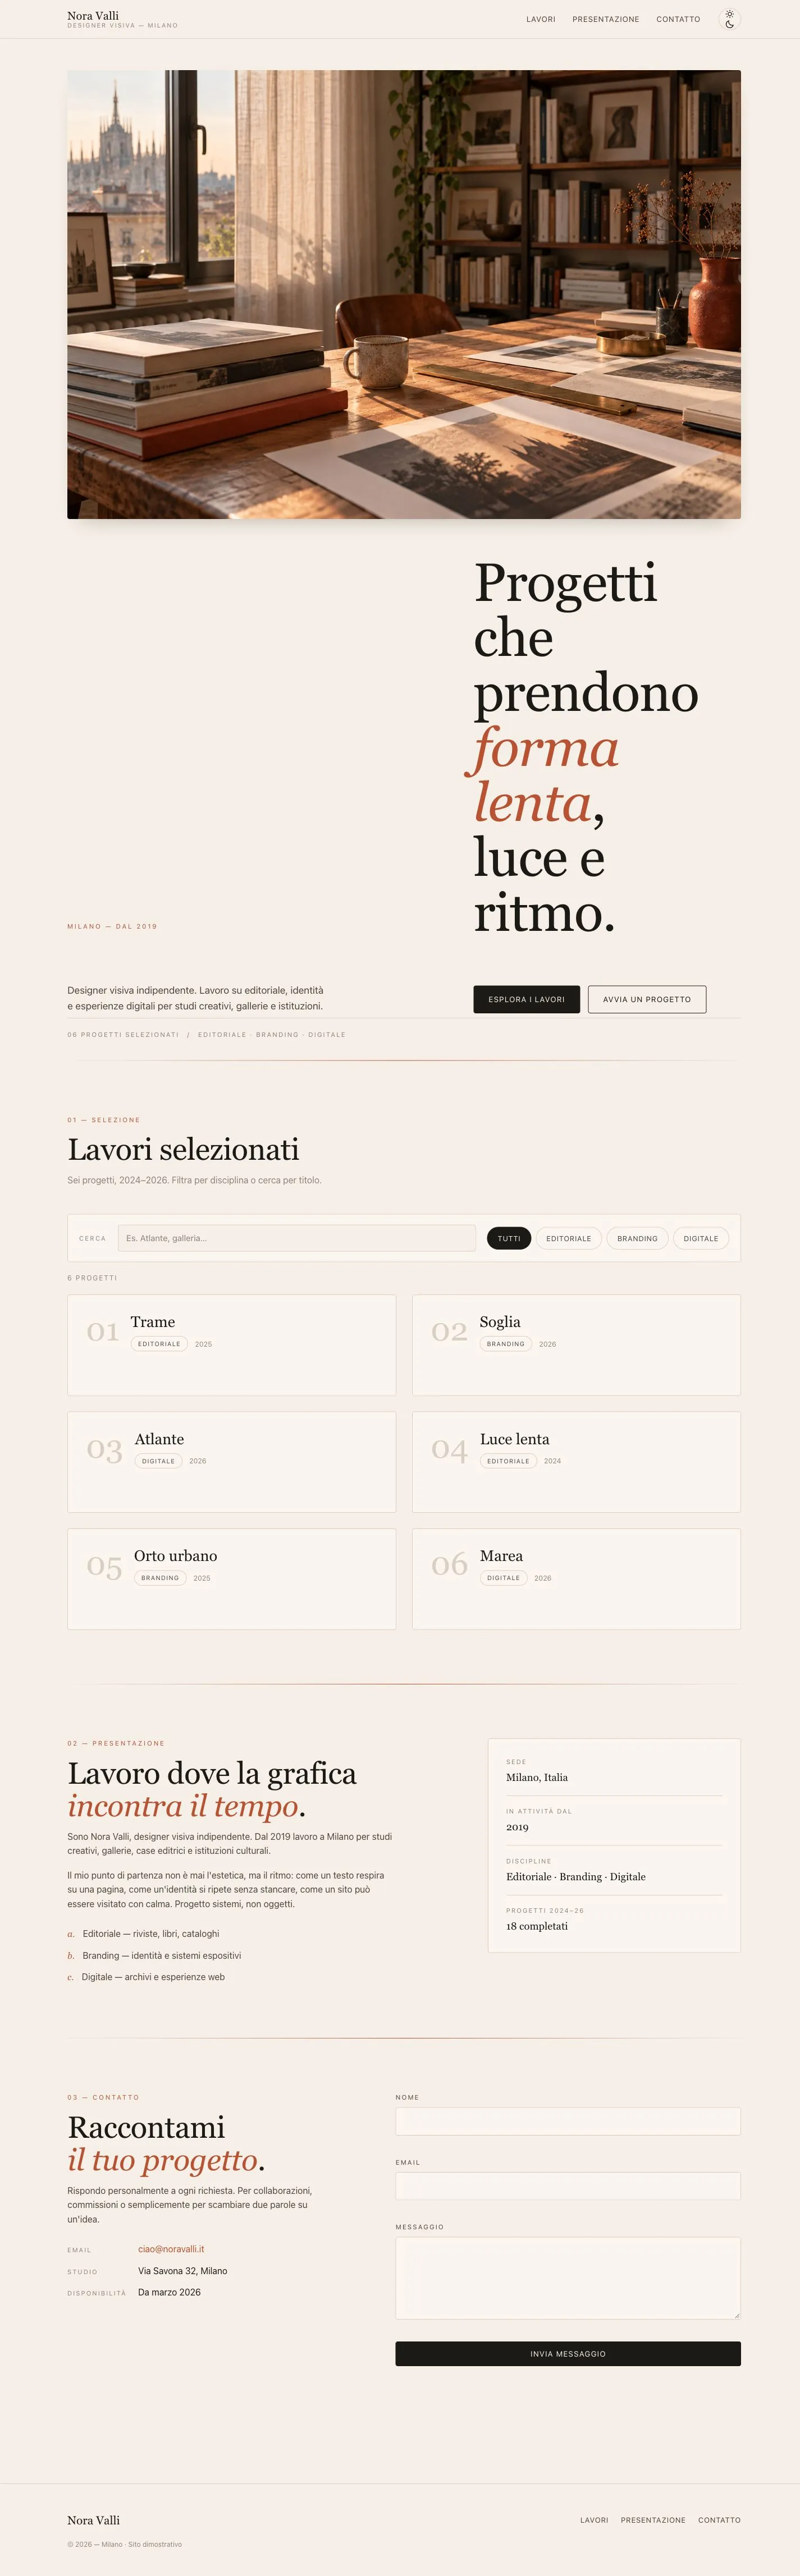
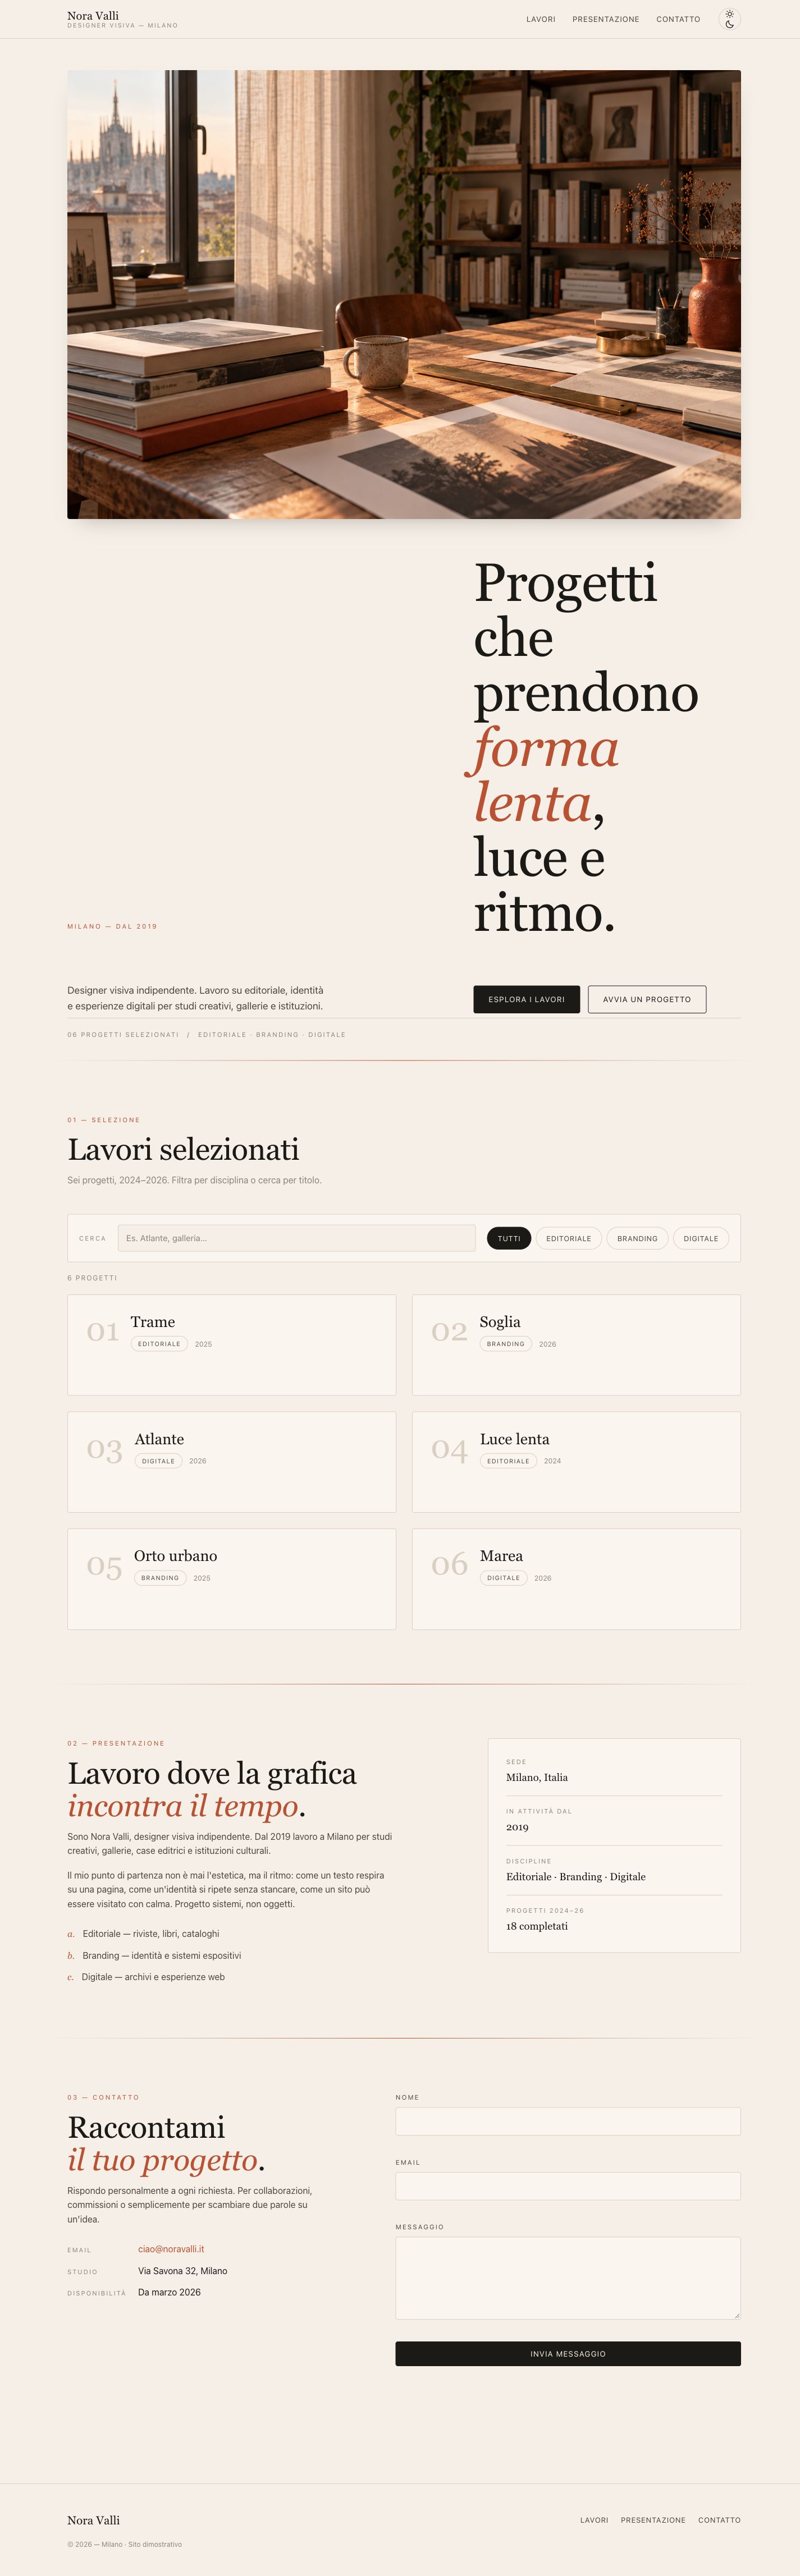
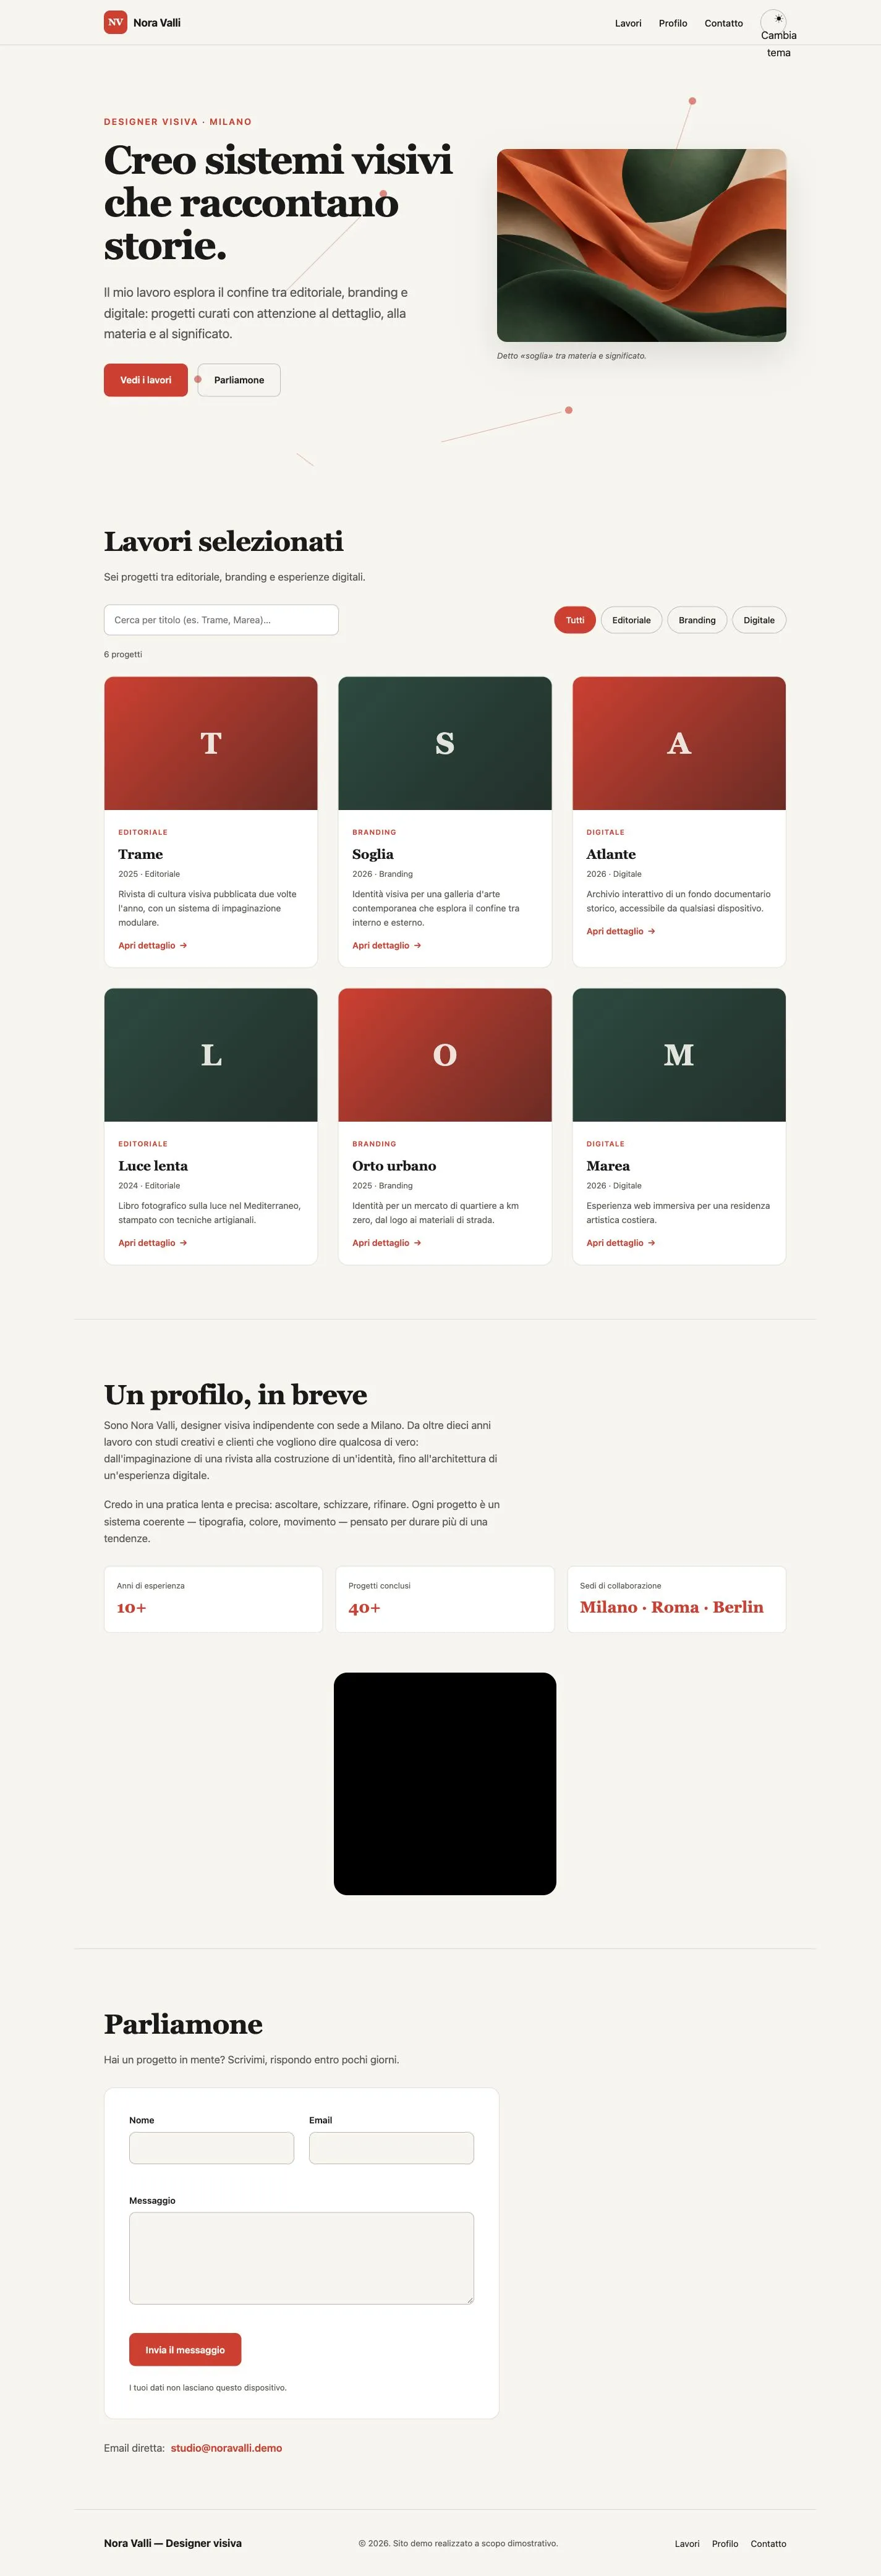
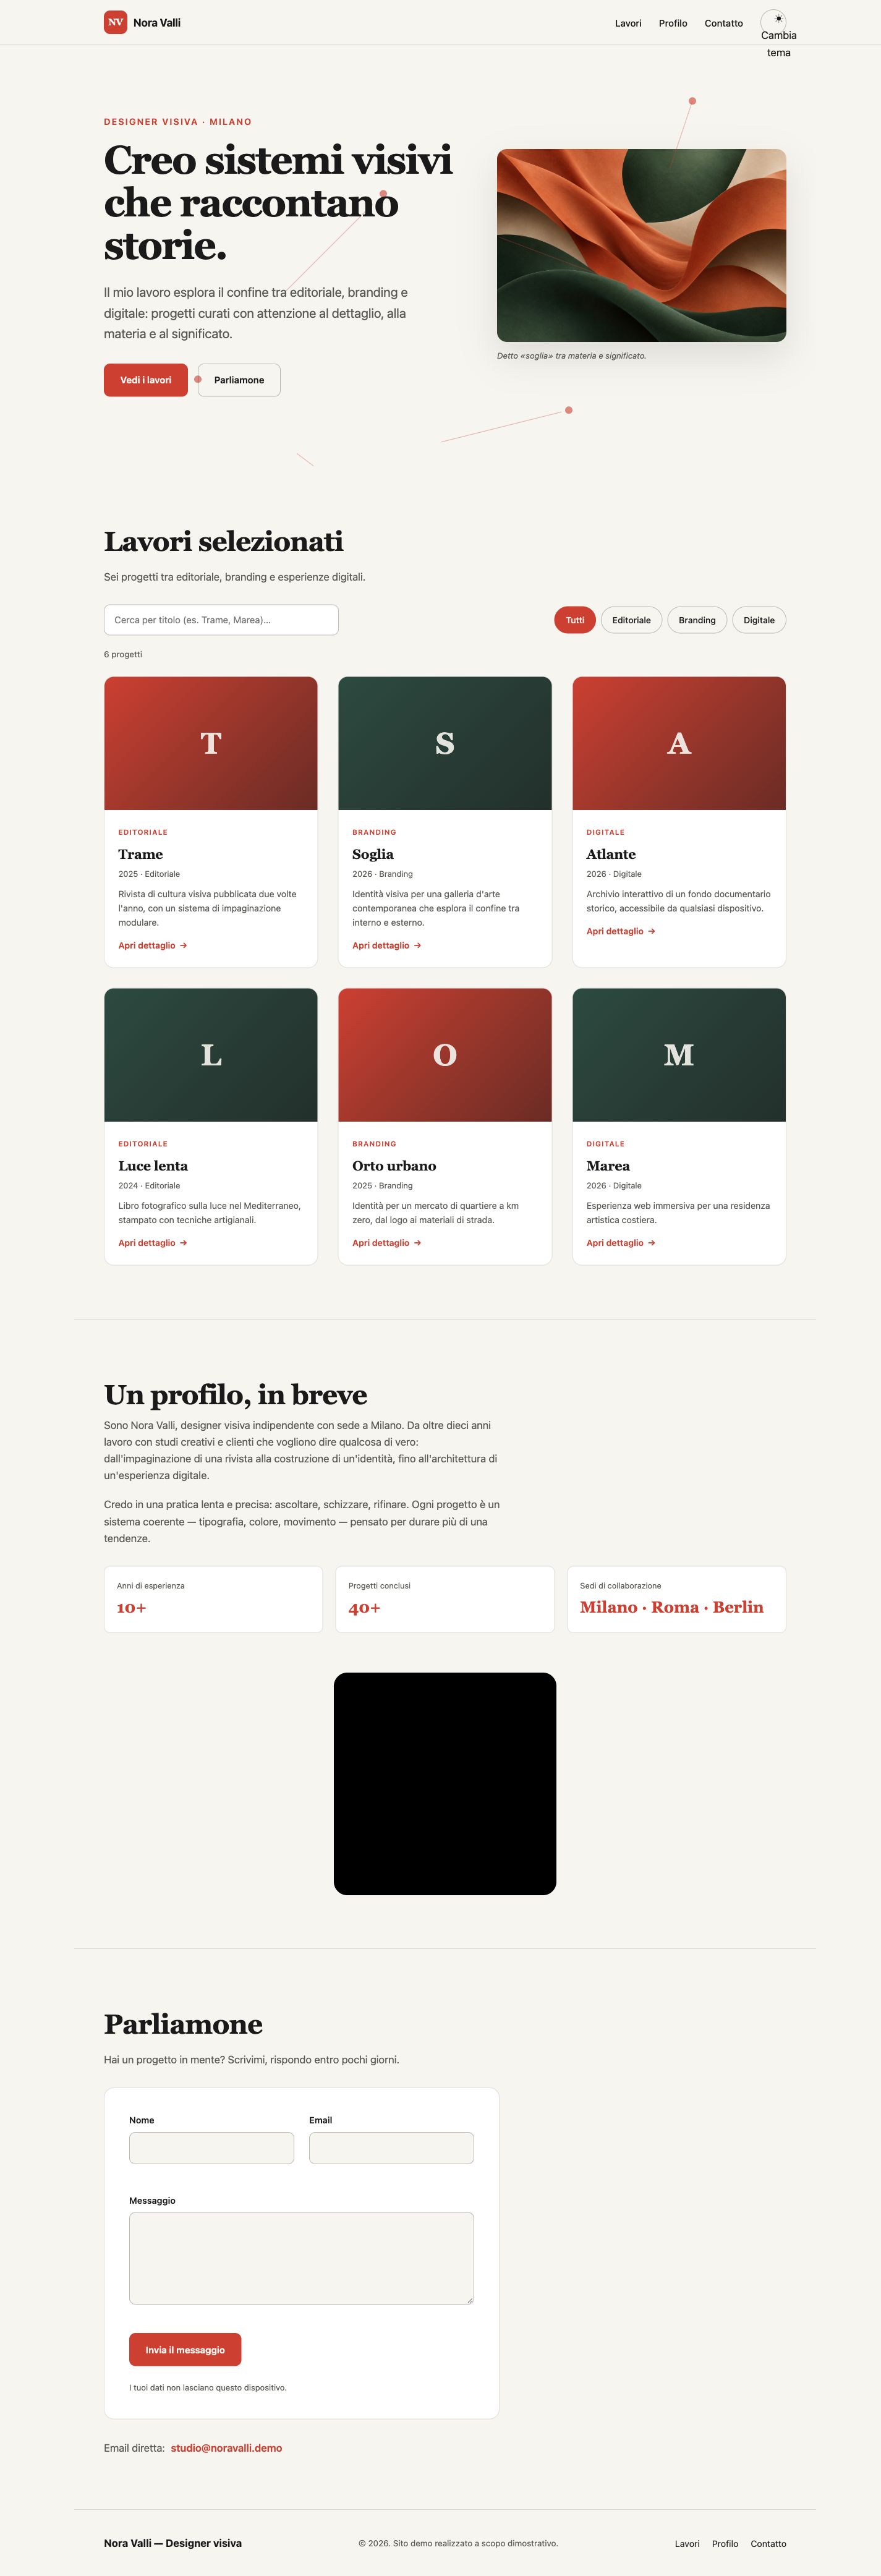
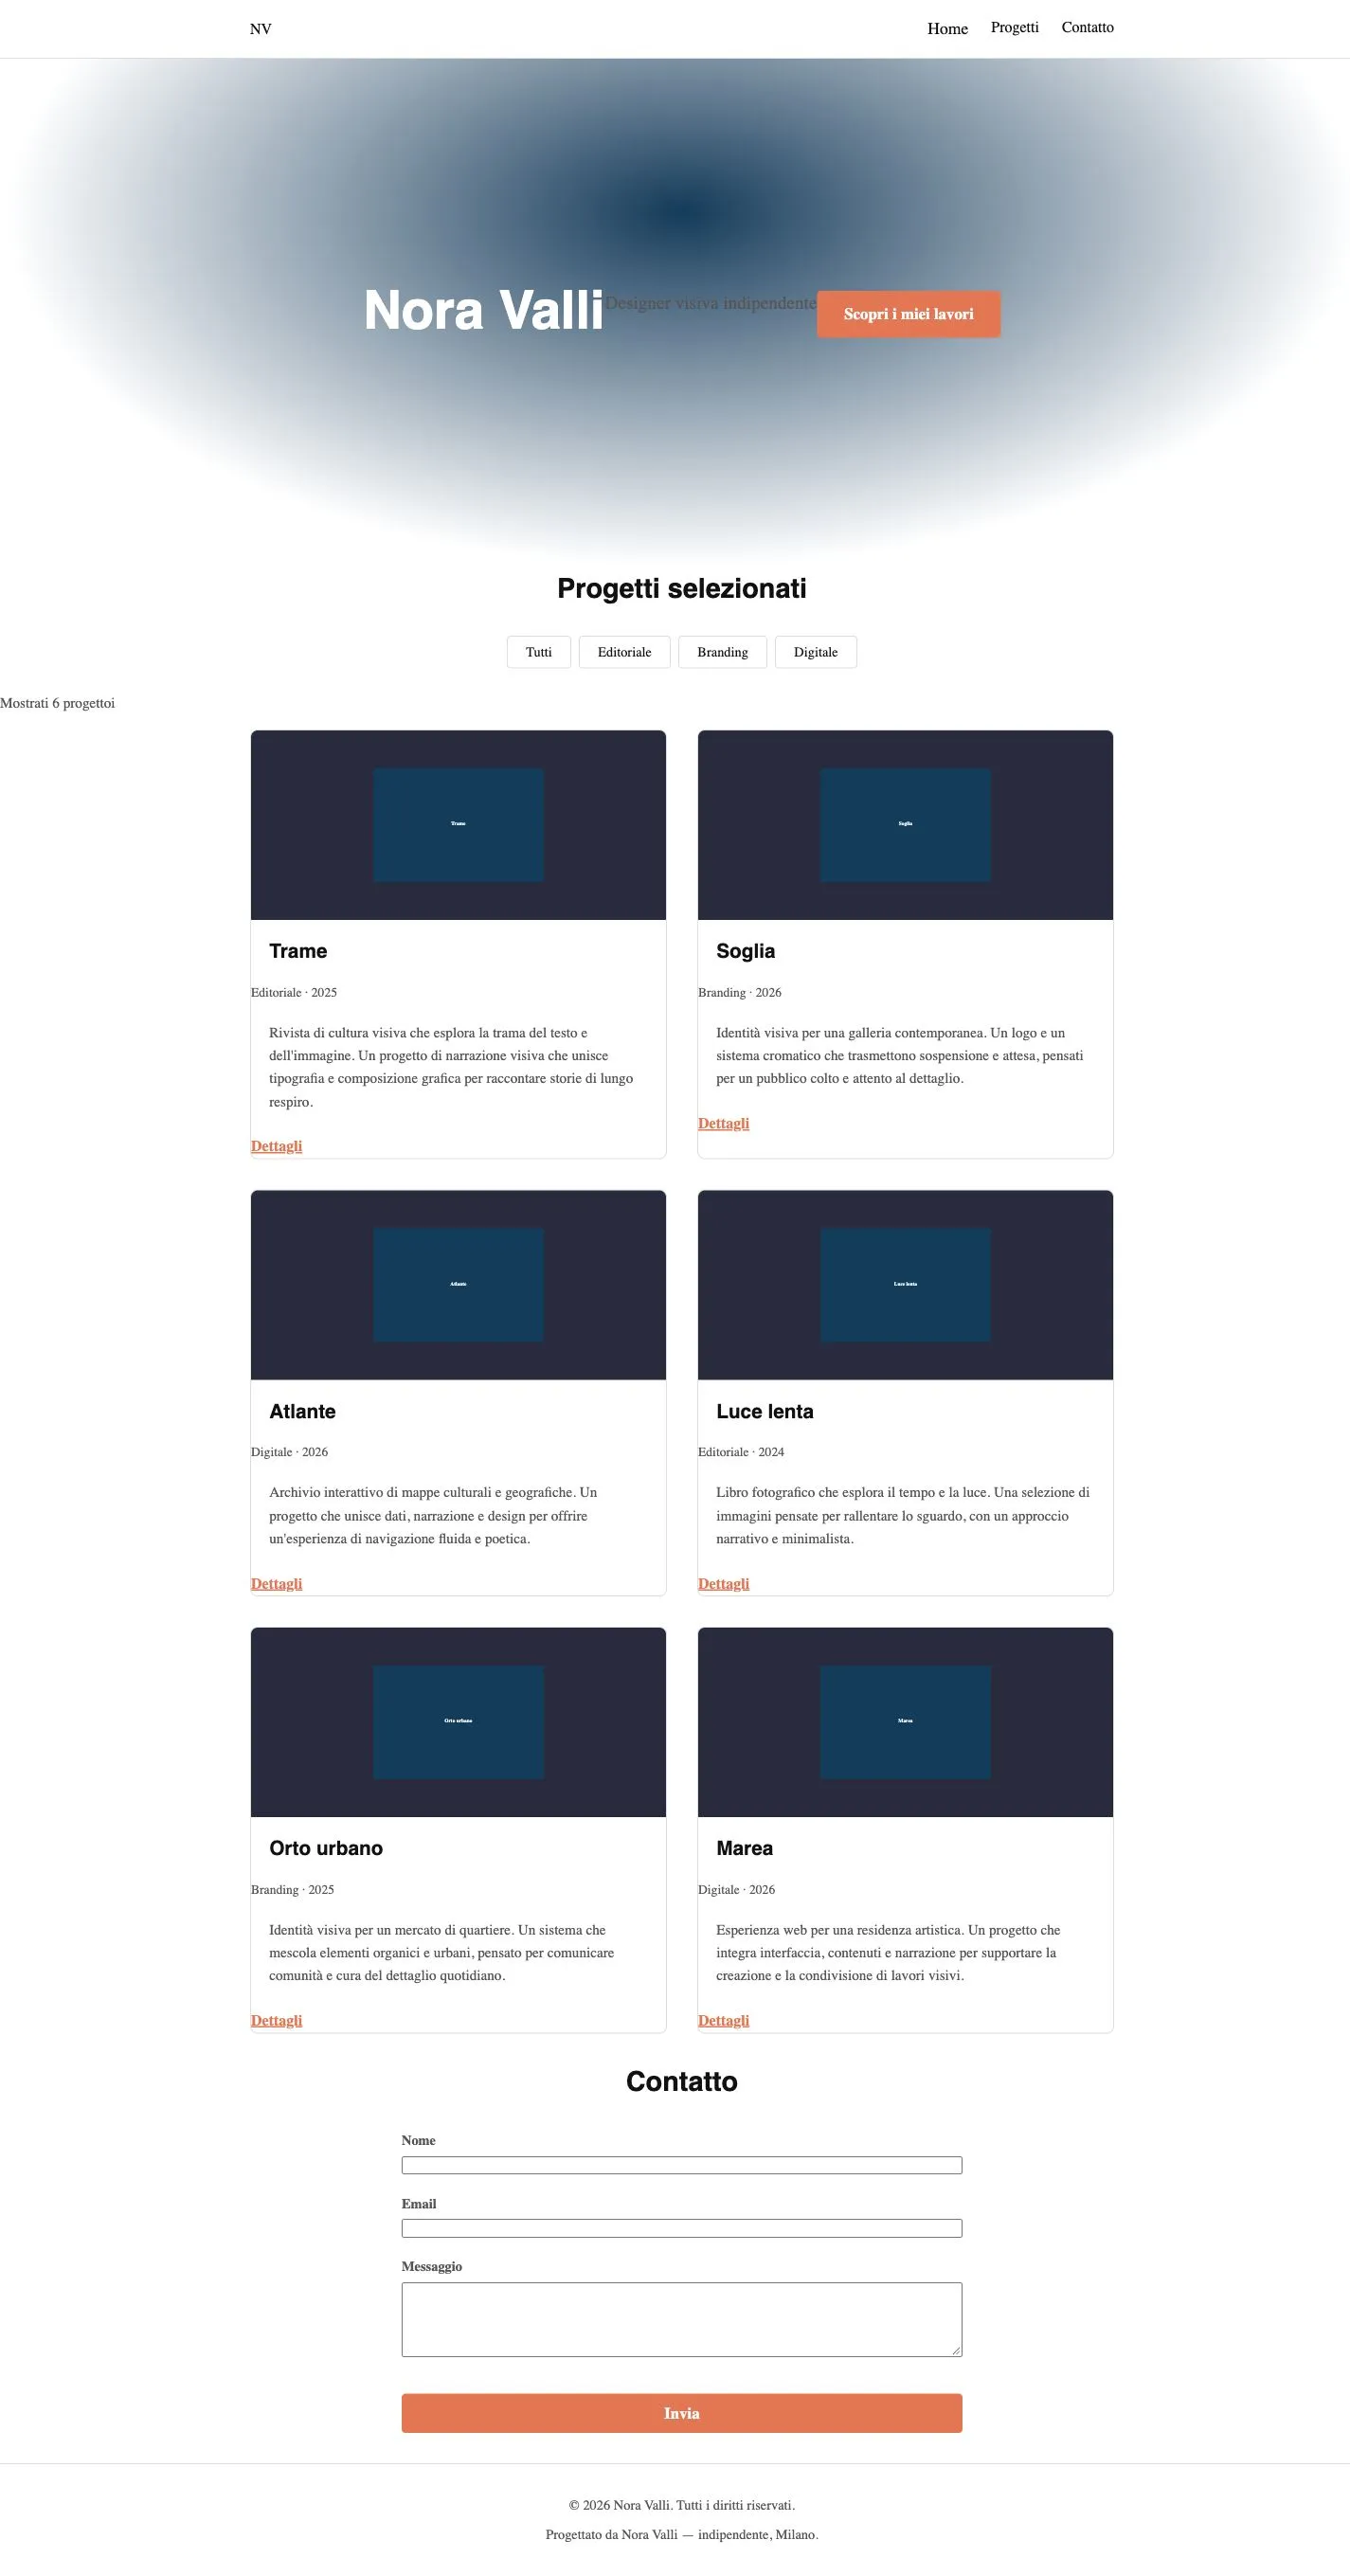
Qwen costruisce una pagina chiara, con un’immagine ampia dello studio, titoli graziati, corsivi color terra e molto spazio. Ornith affianca titolo e immagine, usa accenti rossi e verdi e organizza i lavori in schede con iniziali grandi. LFM presenta una grande fascia blu sfumata, con una relazione poco risolta fra titolo, testo e comando principale. Il file generato esiste, ma nella baseline non è ancora integrato nella pagina; comparirà durante il recupero.
Il mio ordine di preferenza è Qwen, poi Ornith, poi LFM. È un giudizio personale dichiarato, successivo alla prova. Per osservarne le ragioni possibili conviene confrontare proporzioni, gerarchie e integrazione dell’immagine; il numero dei controlli superati risponde a un’altra domanda.
Tutte le catture qui sotto sono riproduzioni editoriali successive, ottenute dagli artefatti conservati senza modificarli e senza nuove inferenze. La baseline è la prima realizzazione, chiamata anche iterazione 0. Per i desktop il viewport è 1440×900; l’immagine a pagina intera può essere più alta di 900 pixel. Ogni immagine rimanda al file originale ingrandibile.
Dietro una buona prima impressione
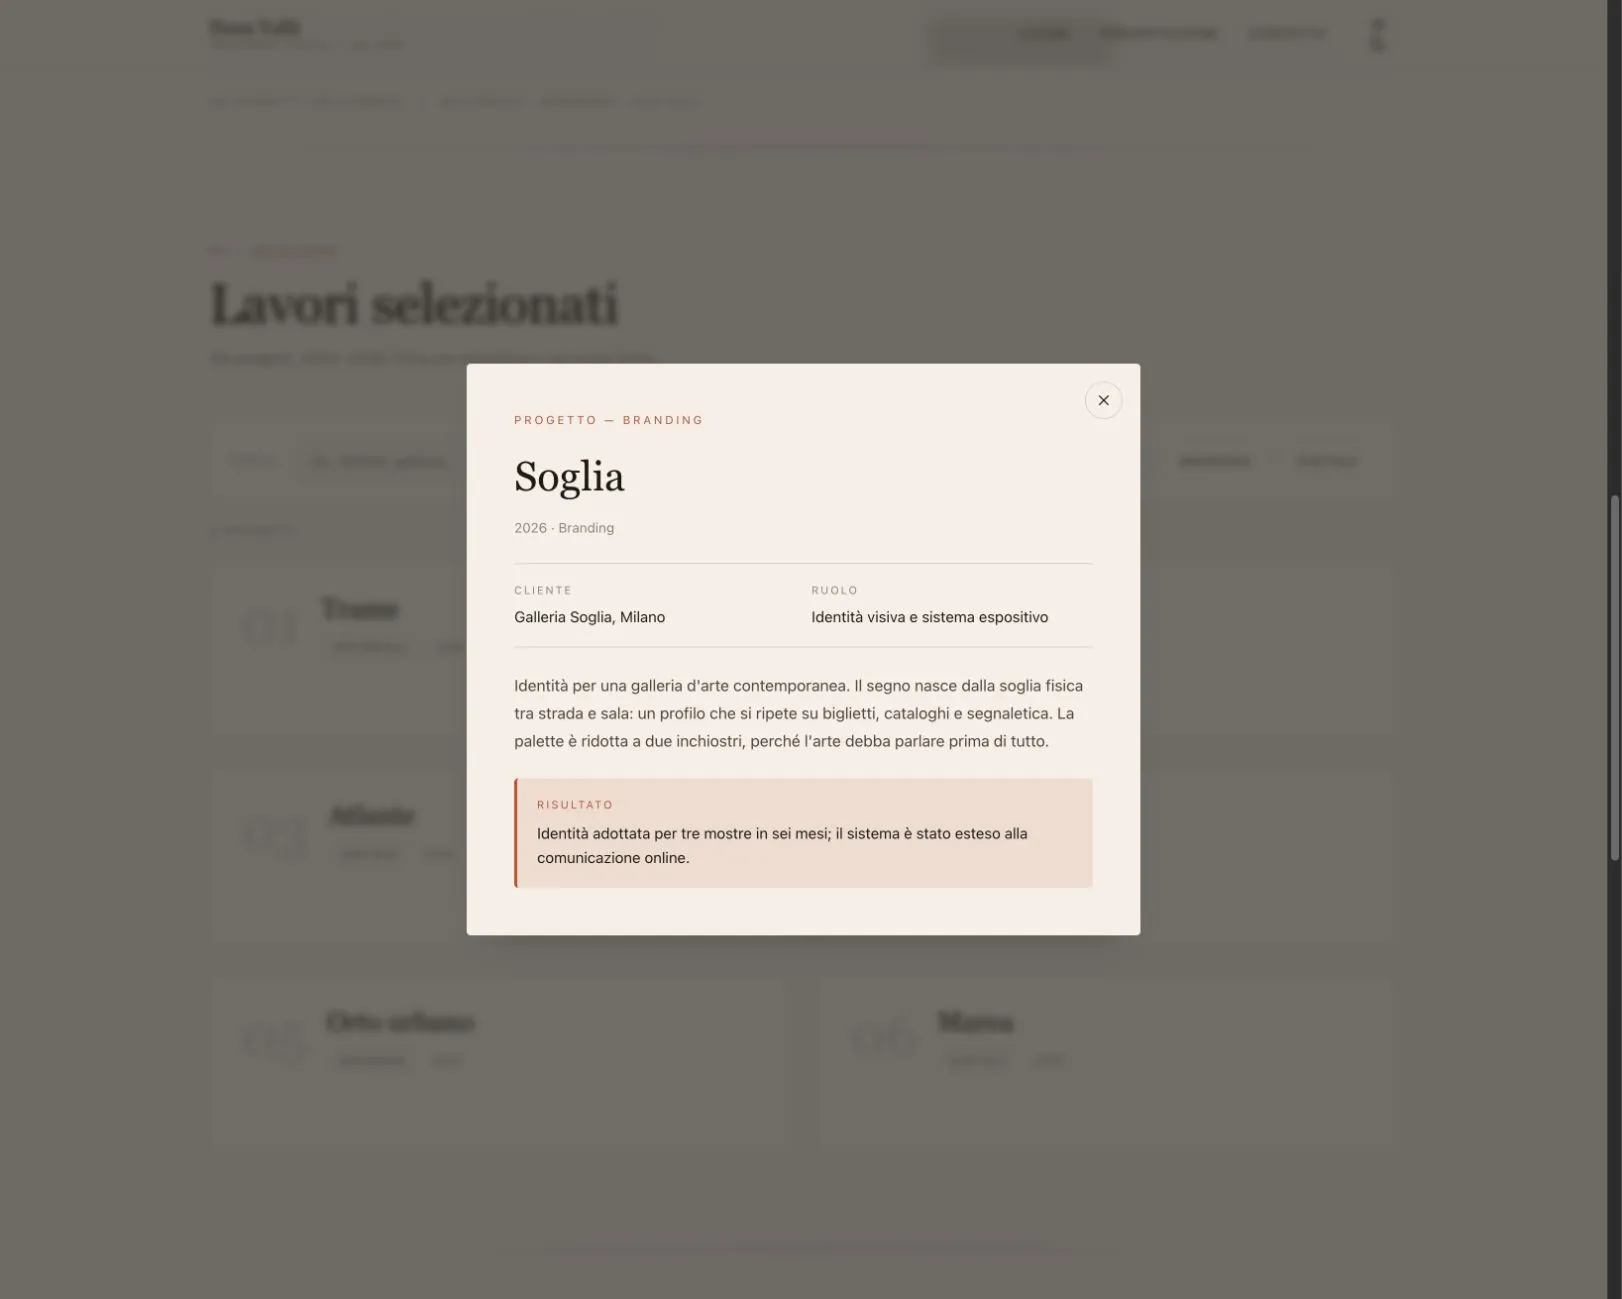
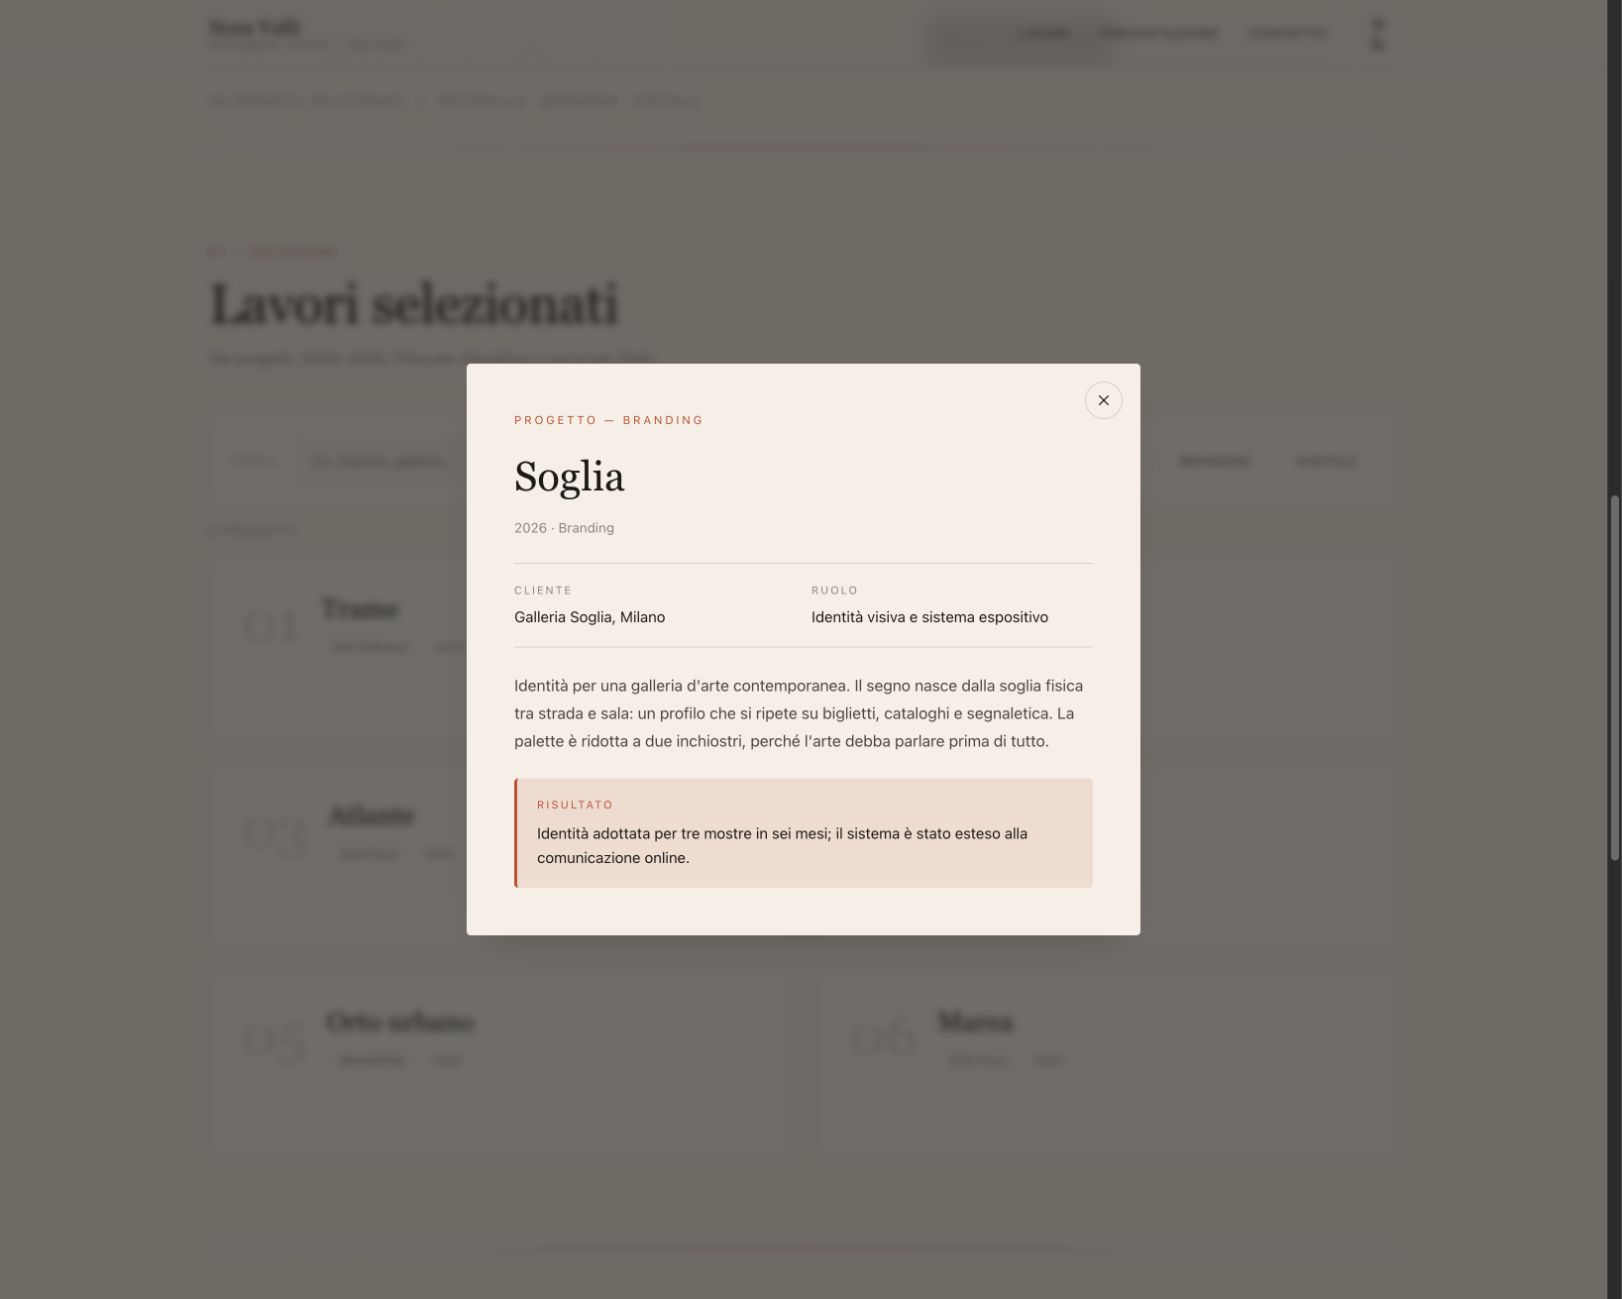
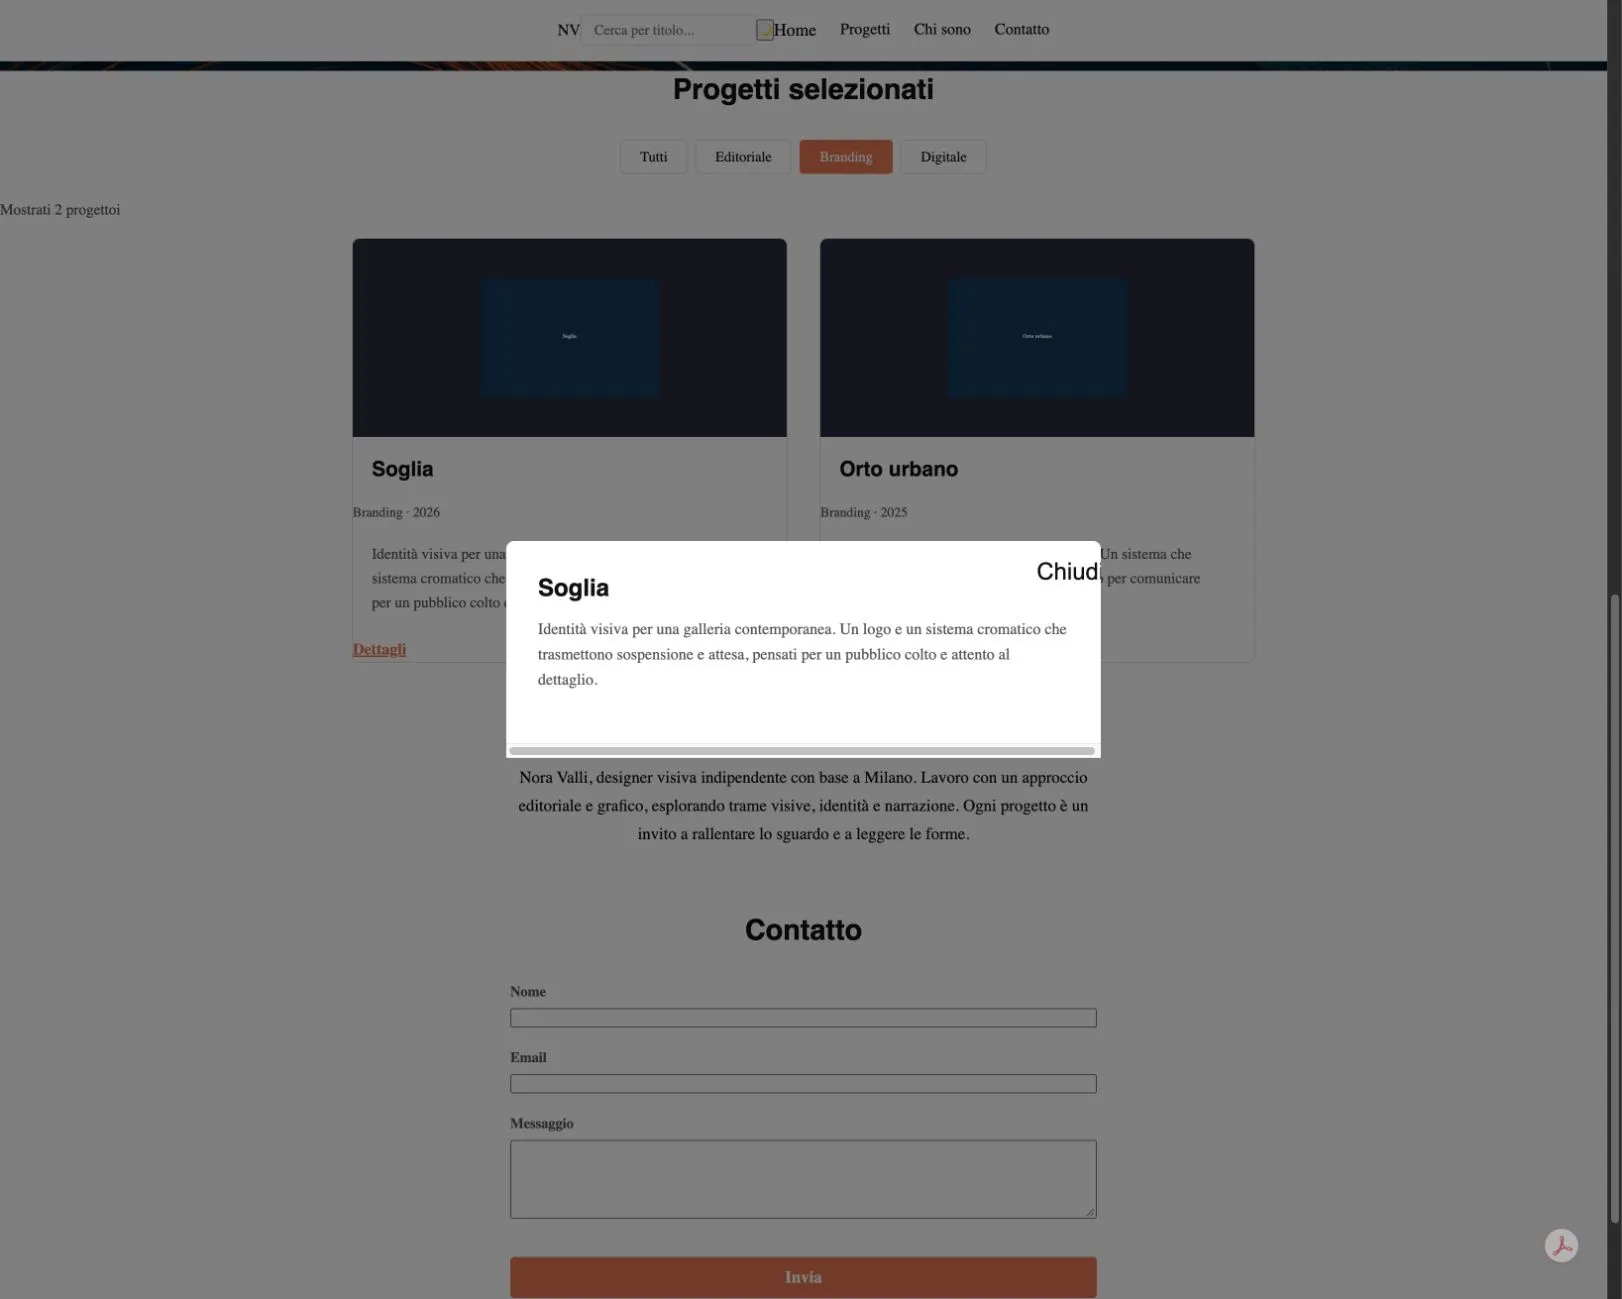
Qwen partiva da nove controlli completi e uno parziale. Il problema riguardava i dettagli dei progetti: quattro dialoghi su sei non funzionavano. Cliccare Soglia lasciava la pagina davanti agli occhi, senza aprire il contenuto richiesto.
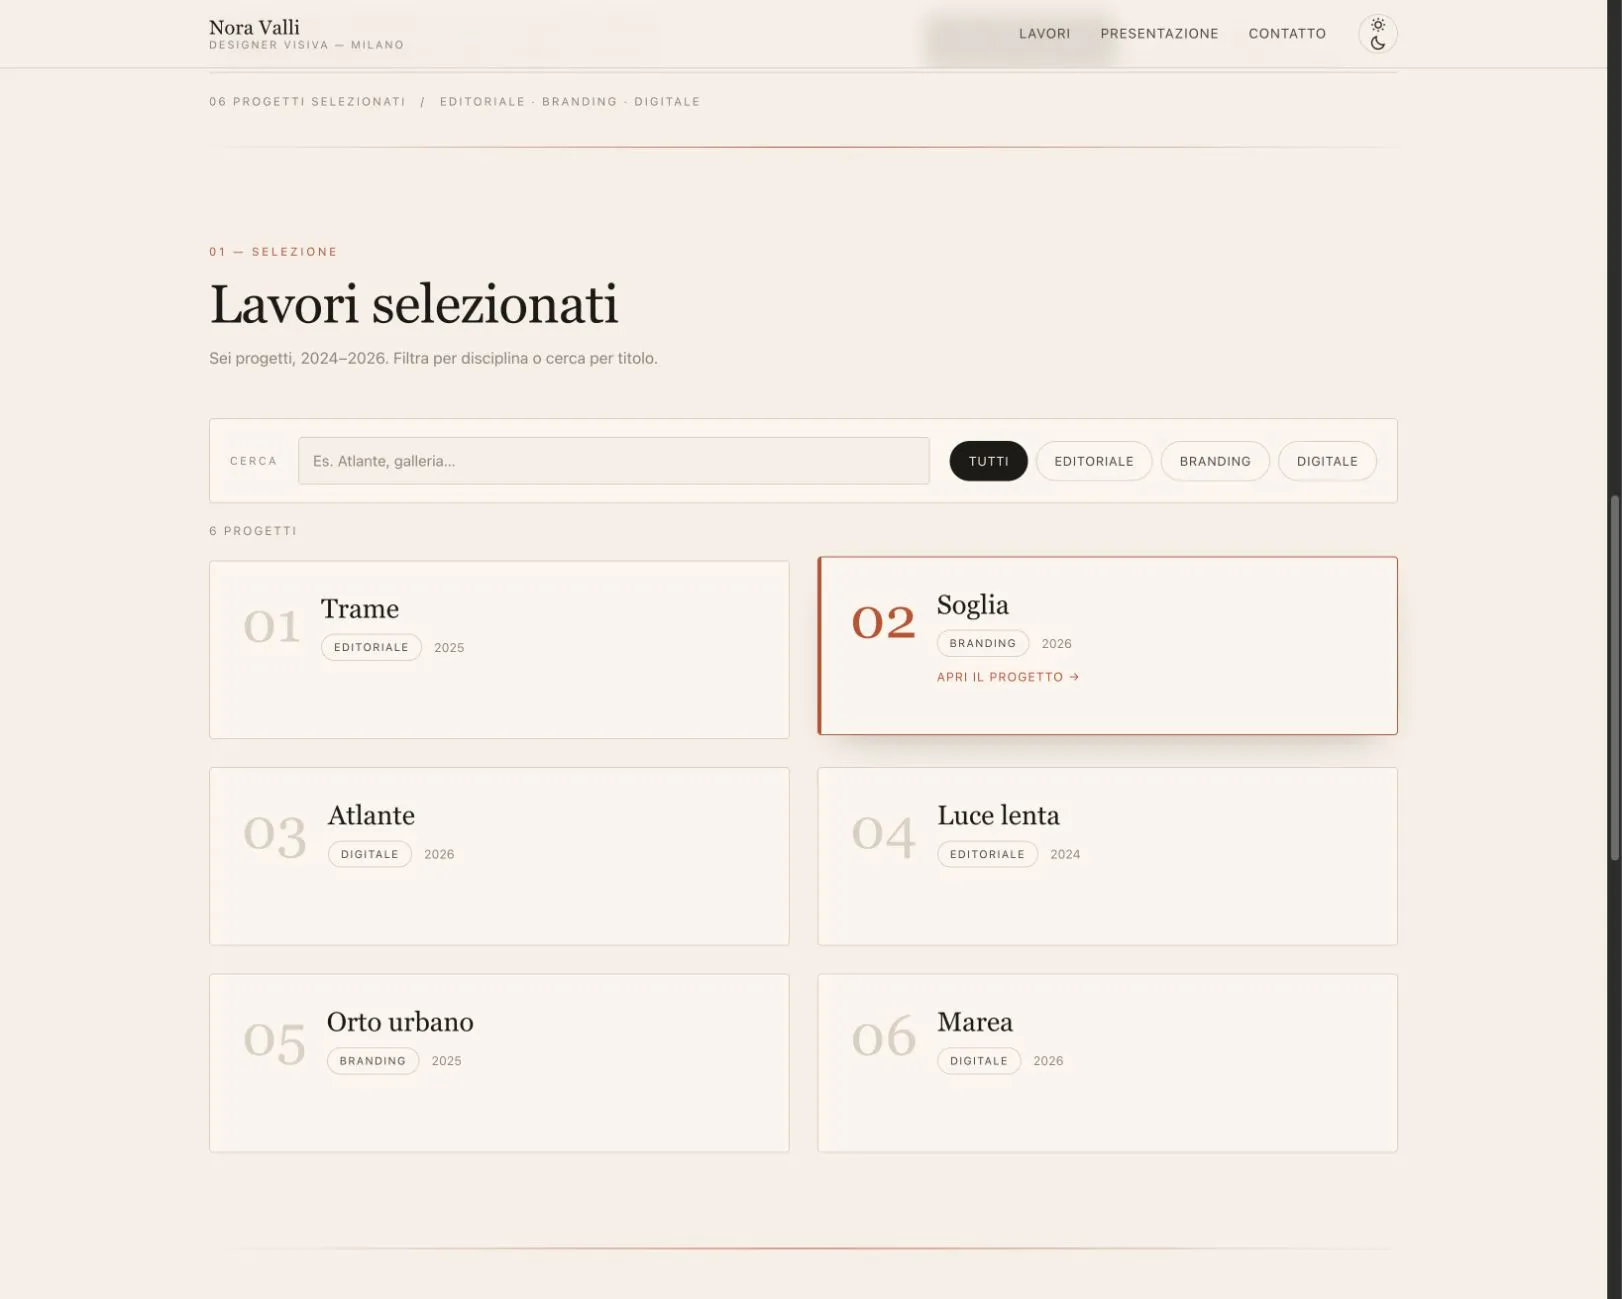
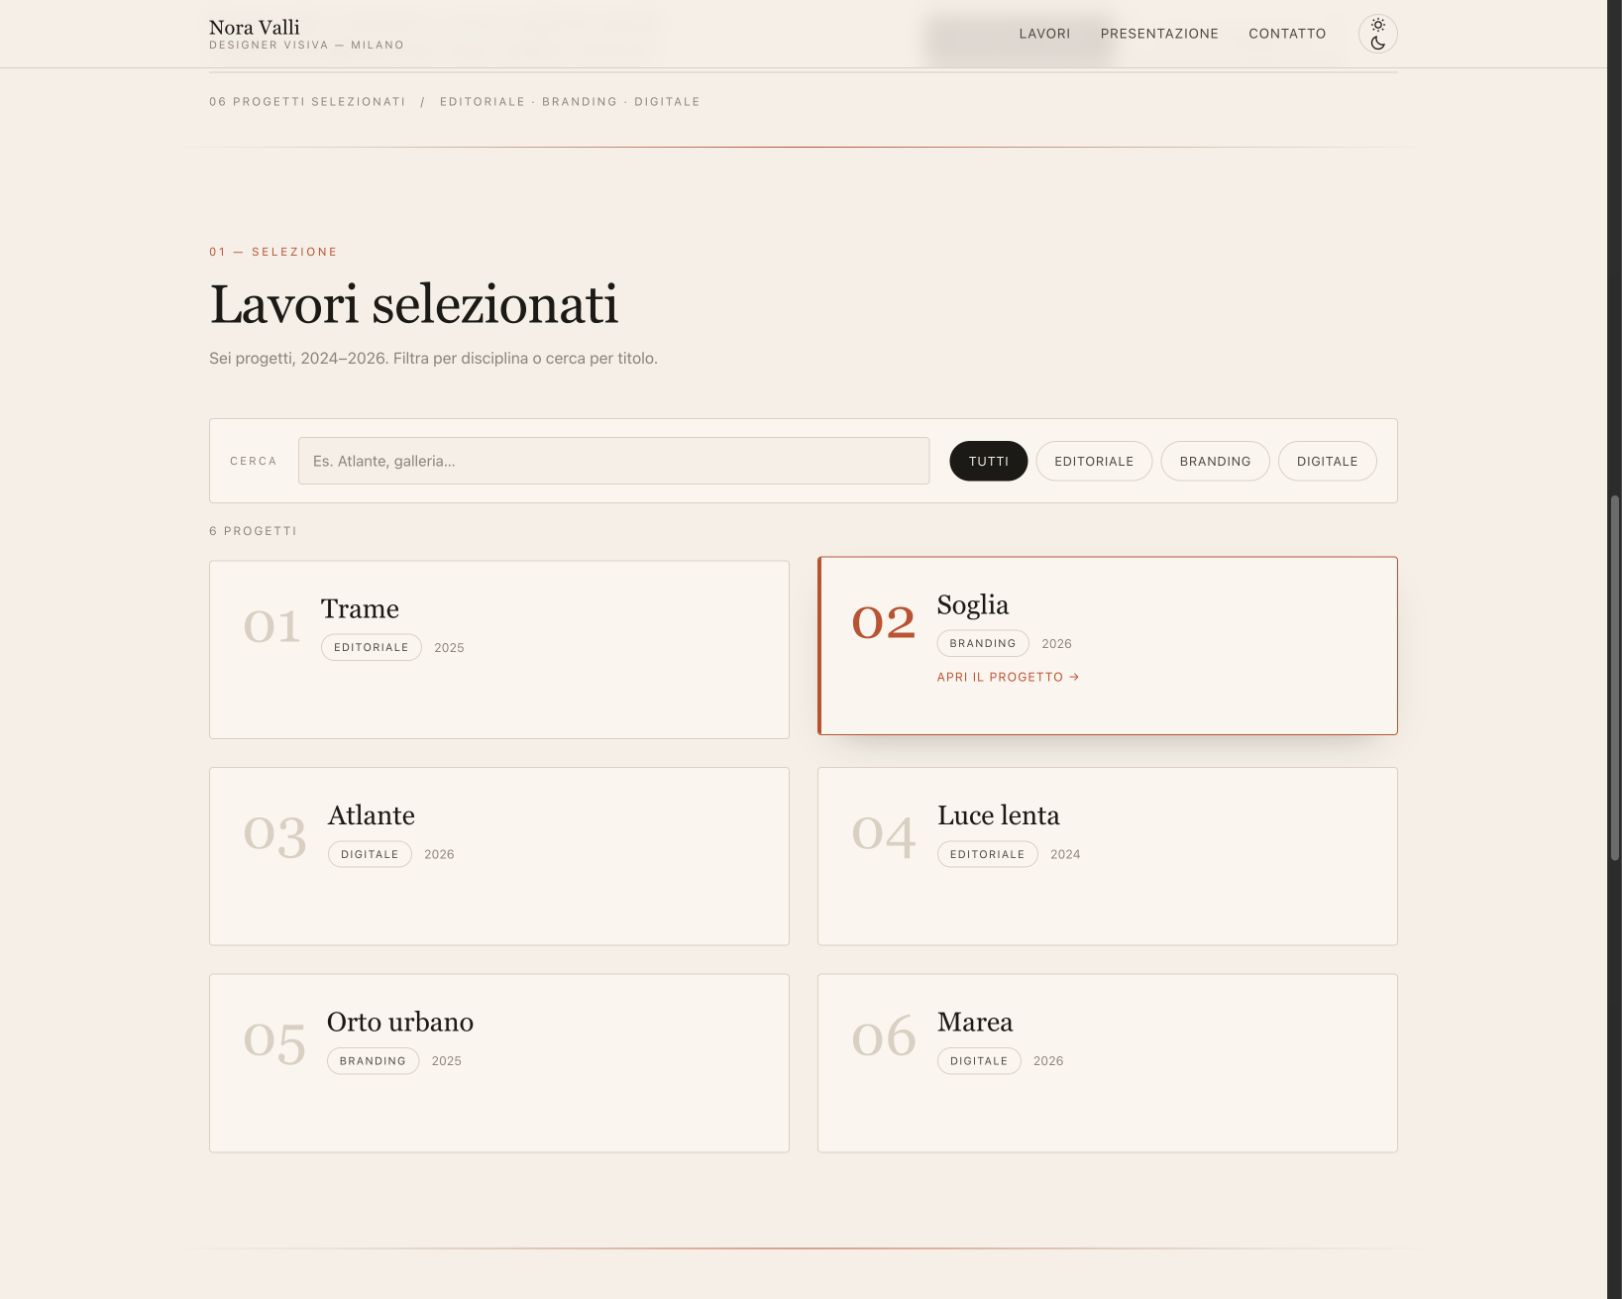
Dopo due iterazioni aggiuntive la stessa azione apre un dettaglio con titolo, anno, ruolo e descrizione. La soluzione introduce un fallback JavaScript: i dati vengono recuperati anche quando gli attributi HTML originali, contenenti JSON, sono troncati. Il comportamento richiesto passa; il markup malformato resta un debito da correggere prima di un uso reale.
Ornith partiva da otto controlli completi. Il filtro Branding cambiava aspetto, ma lasciava visibili tutti e sei i lavori. Il comando comunicava una selezione che la raccolta non rispettava.
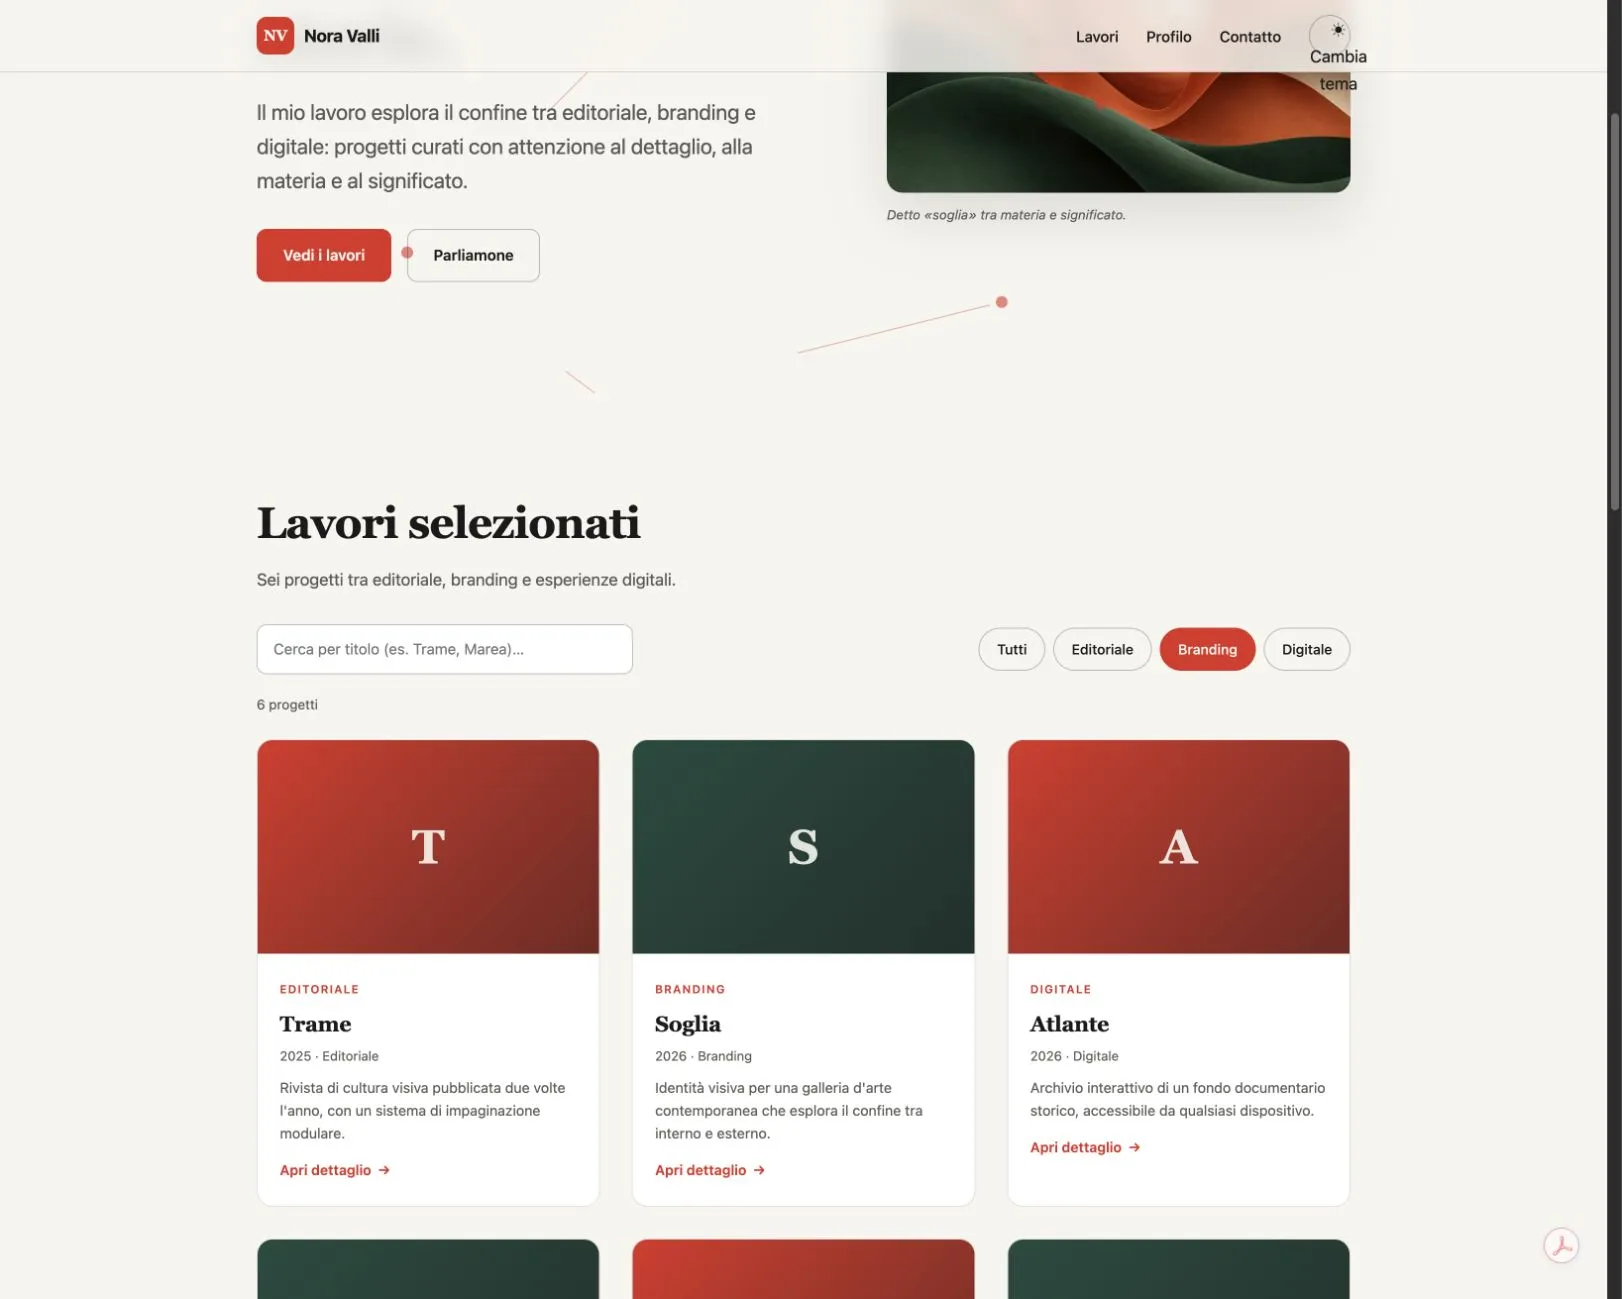
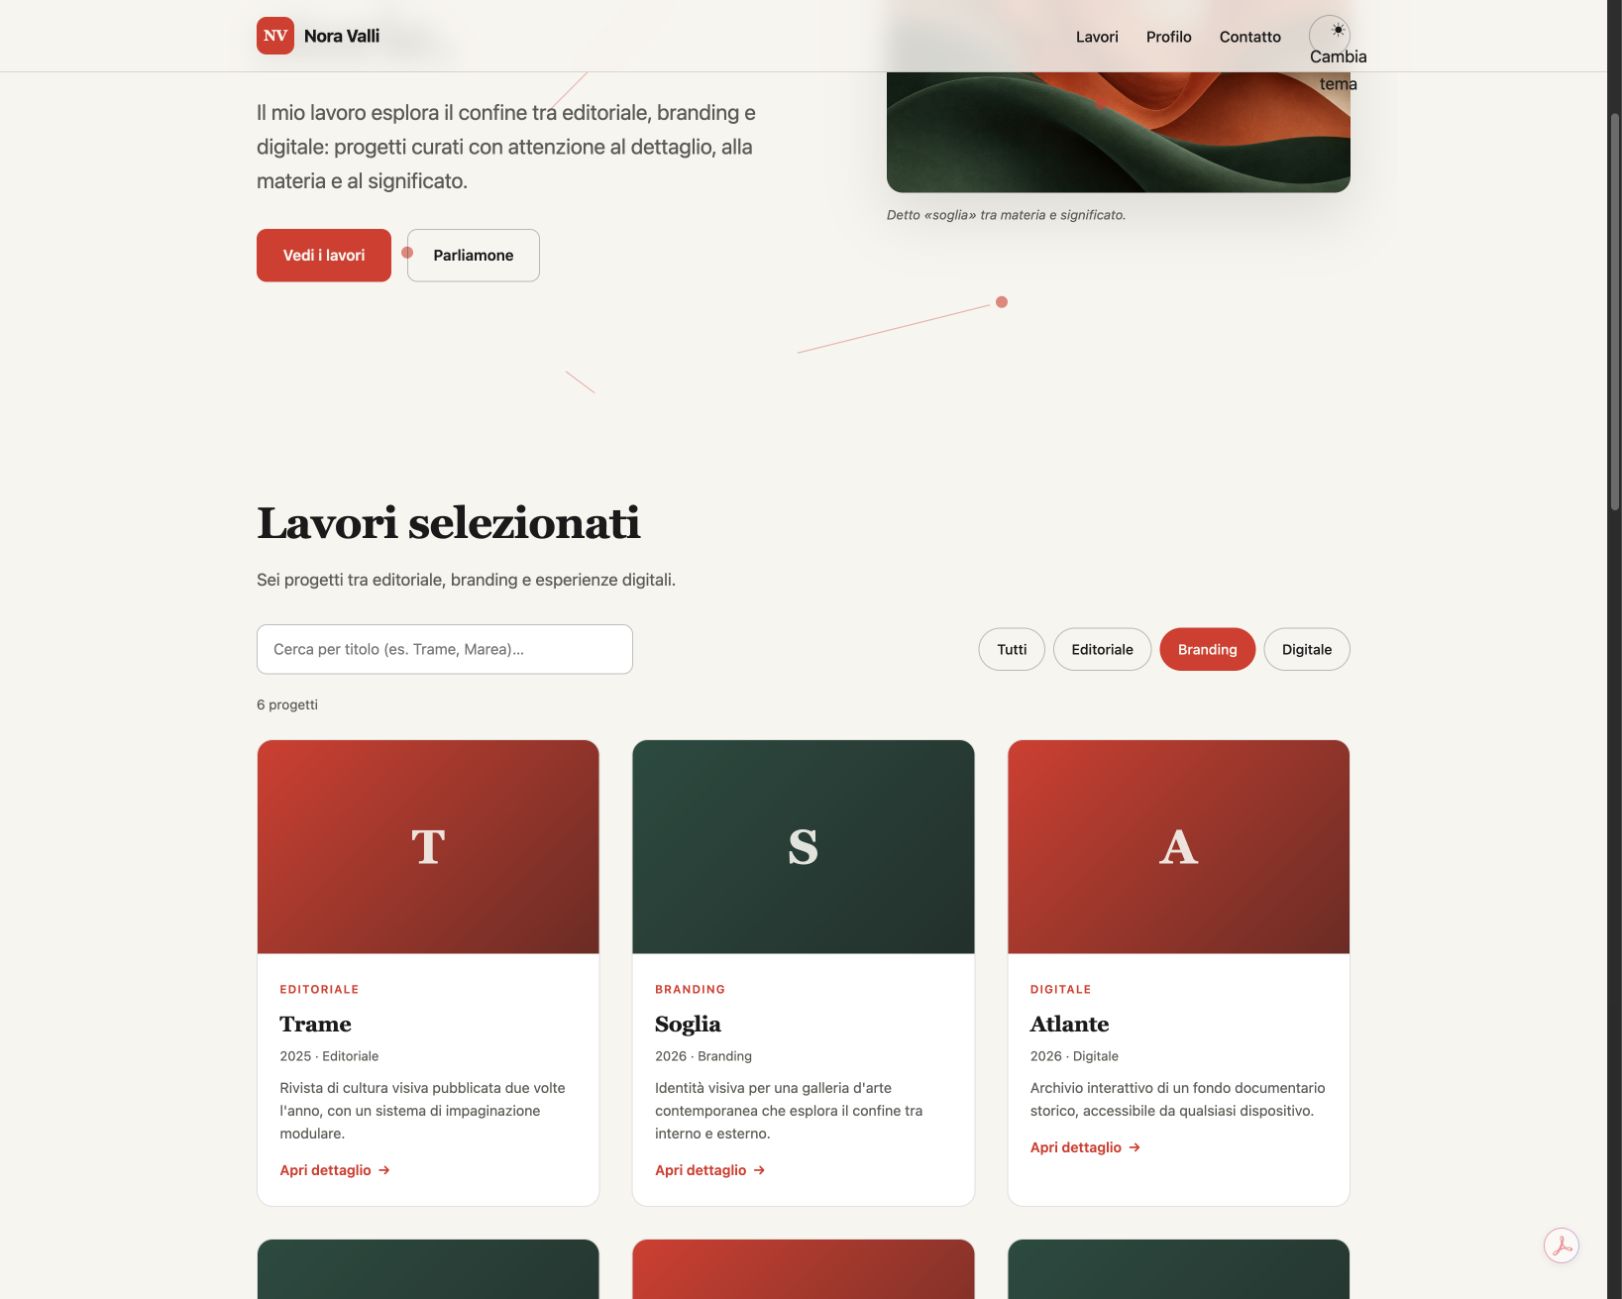
Nel solo round di recupero Ornith corregge riferimenti a variabili del filtro. Restano Soglia e Orto urbano, come richiesto. Il refuso «2 progettoi trovatoi» è ancora lì: il controllo verifica il conteggio e lo stato, senza certificare ogni parola dell’interfaccia.
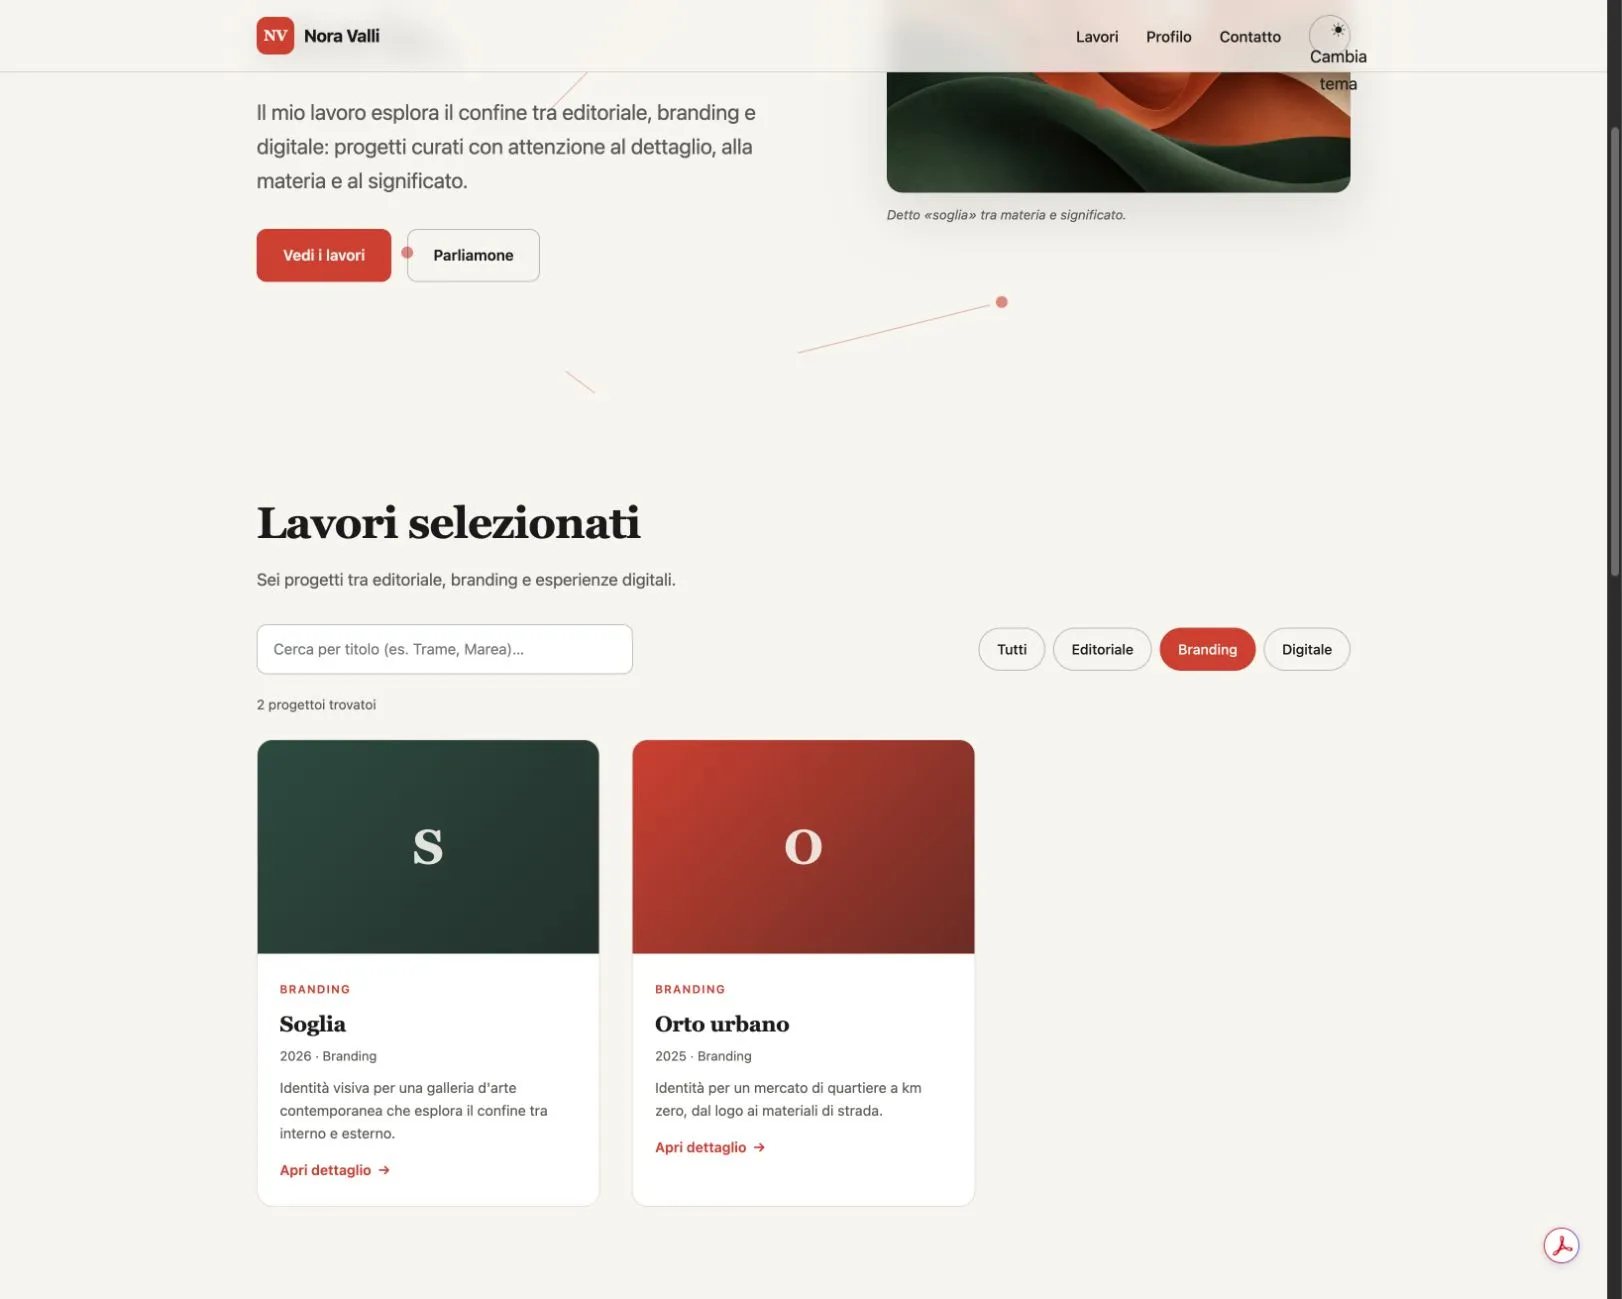
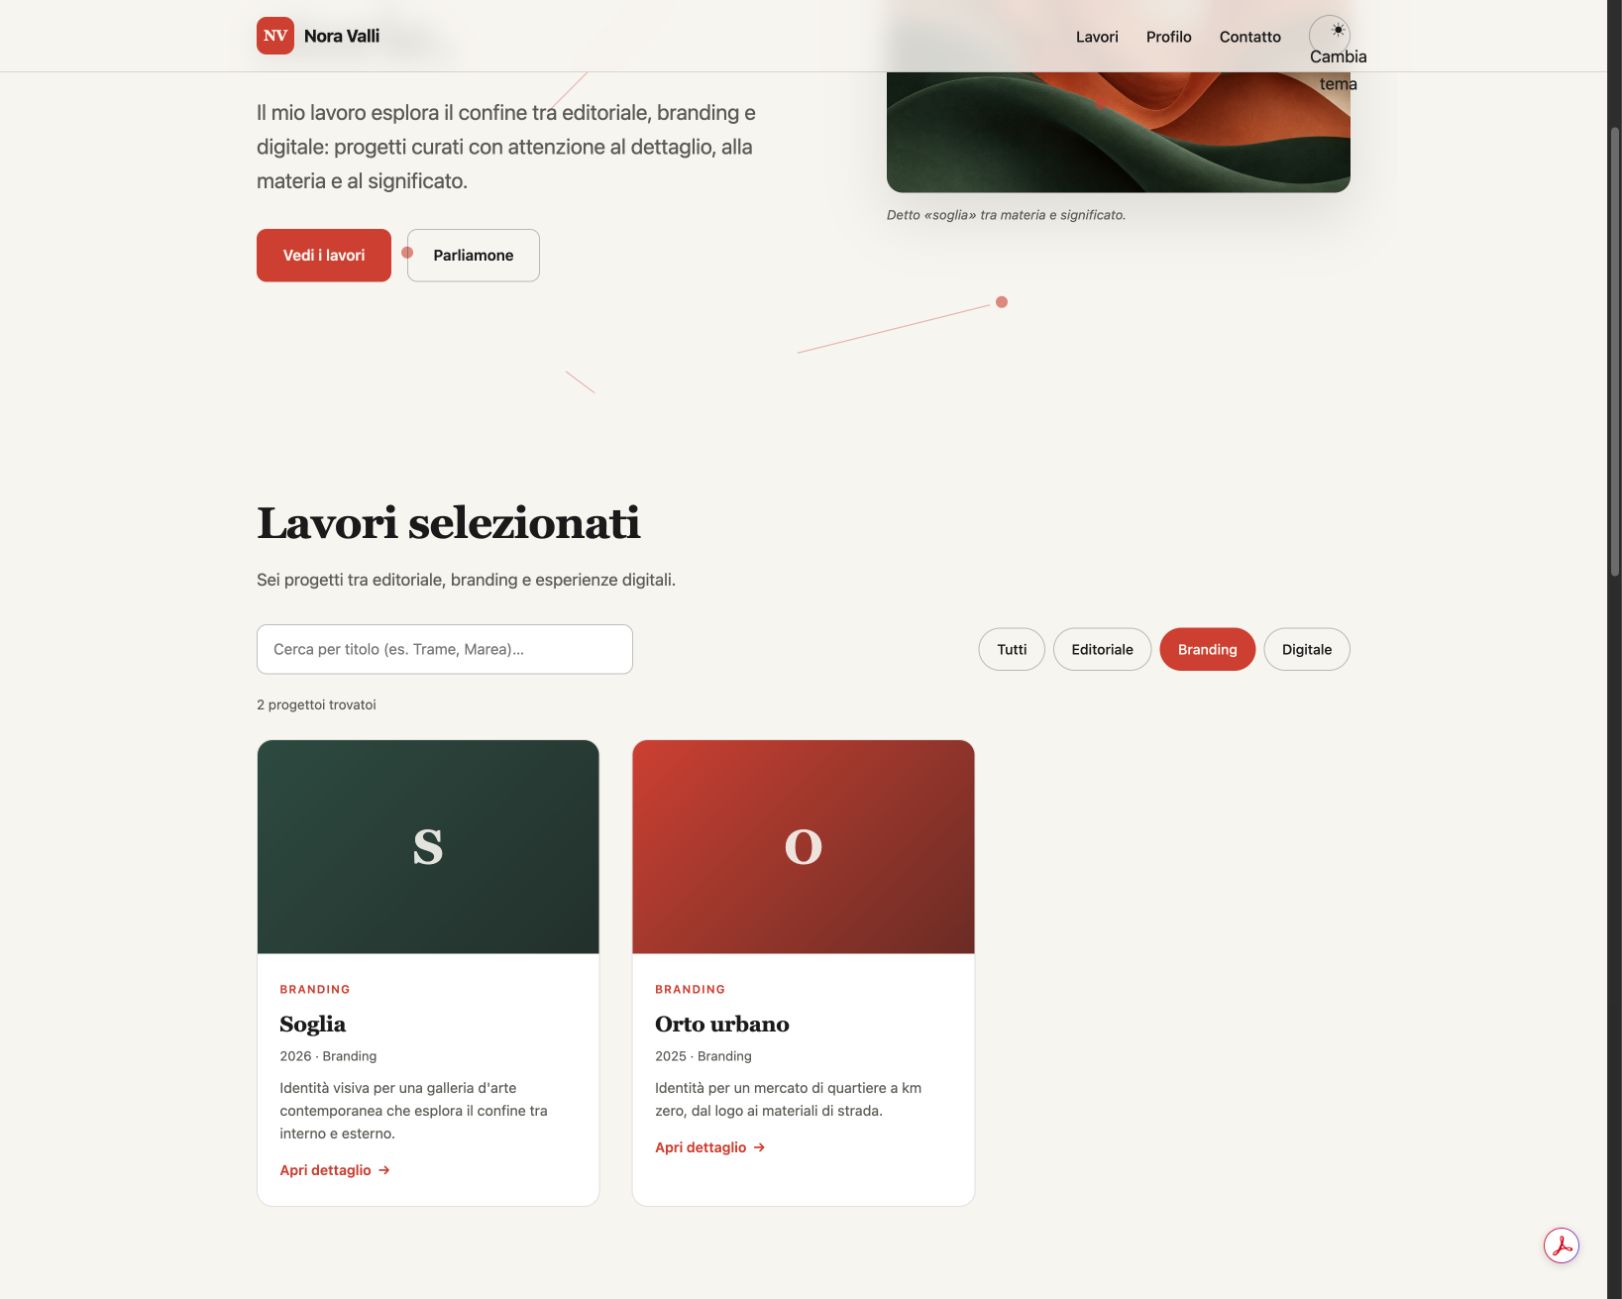
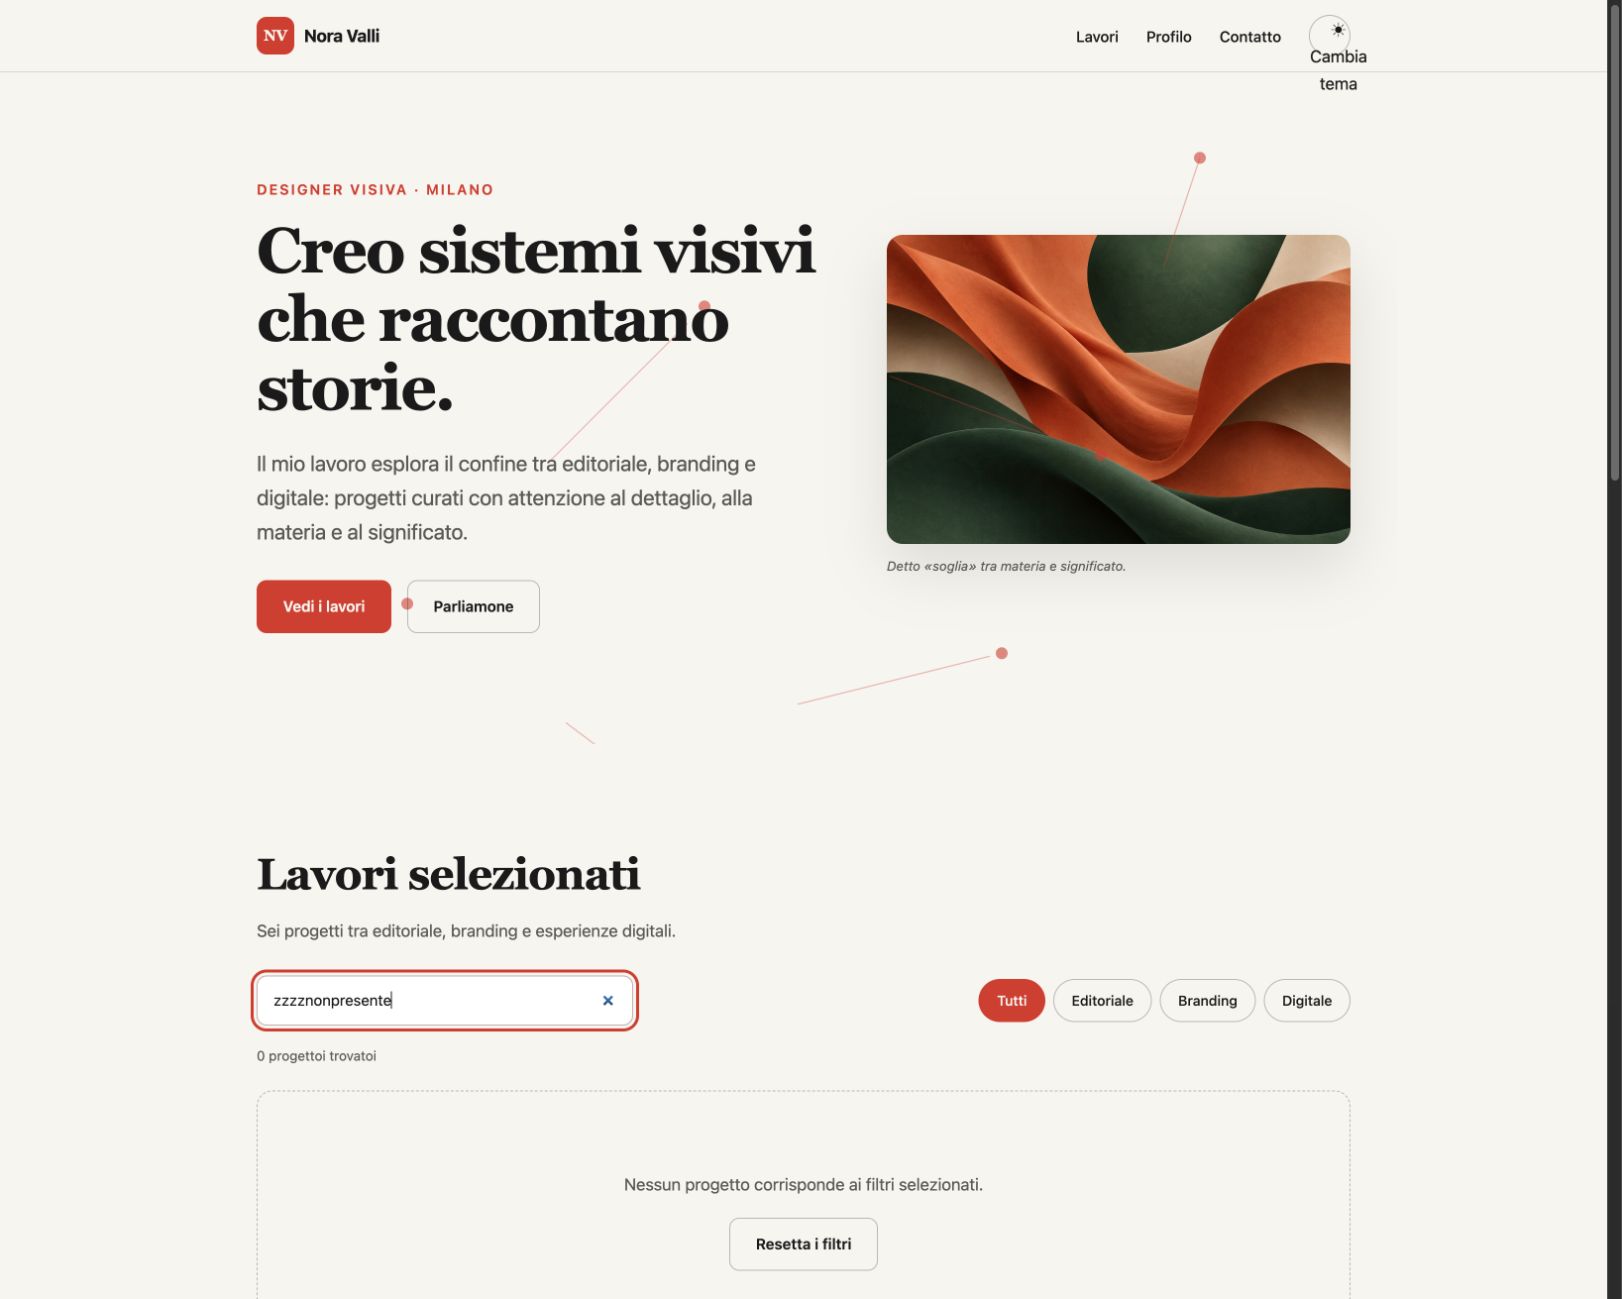
Le prove complete combinano filtro e ricerca. La sequenza attesa passa da sei risultati a due, poi a uno e a zero, per tornare a sei con il reset. Se una ricerca “Soglia” continua a mostrare il progetto sotto Editoriale, il filtro e la query stanno lavorando separatamente: una singola cattura con un filtro riuscito non basta a verificare la combinazione.
Un’iterazione può correggere, ripetere o peggiorare
Qui un’iterazione aggiuntiva significa una nuova esecuzione di Pi, con nuova sessione e prompt, che parte dai file precedenti ed è seguita da tutte le verifiche esterne. Una chiamata a uno strumento o una singola risposta del modello non è una nuova iterazione.
| Configurazione | Partenza | Percorso dei controlli completi | Iterazioni aggiuntive |
|---|---|---|---|
| Qwen | 9, più un parziale | 9 → 9 → 10 | 2 |
| Ornith | 8 | 8 → 10 | 1 |
| LFM | 4 | 4 → 4 → 4 → 4 → 4 → 4 → 4 → 3 → 5 → 6 → 8 → 9 → 9 → 10 | 13 |
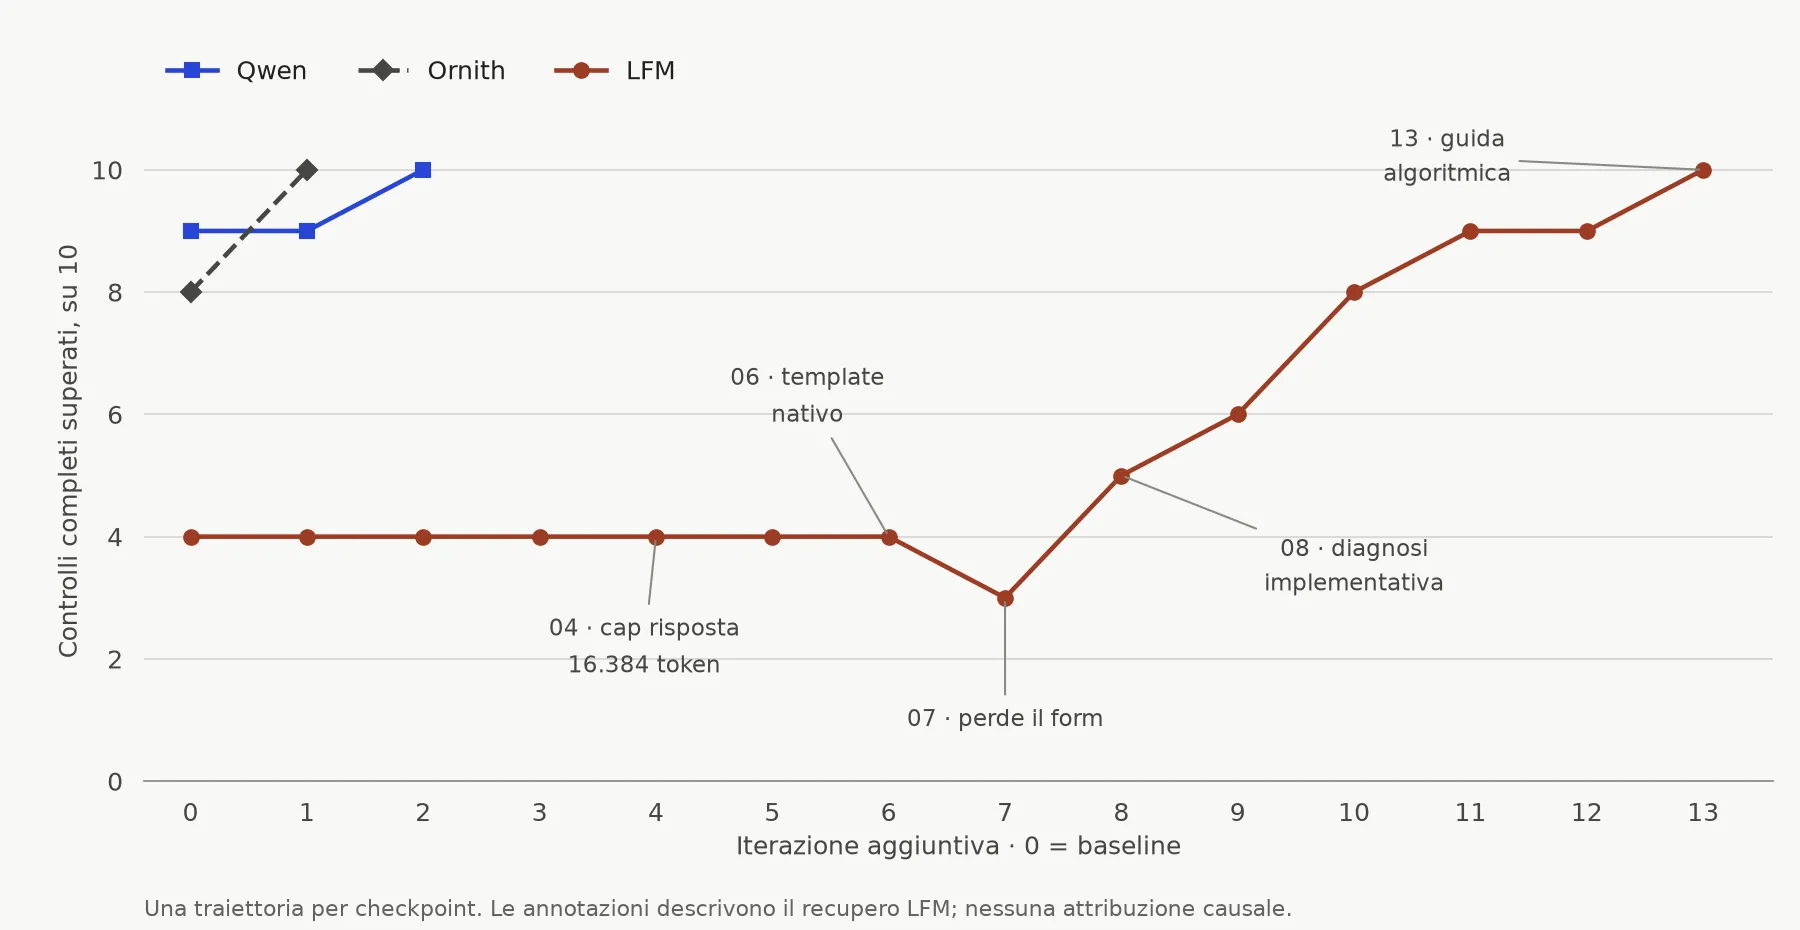
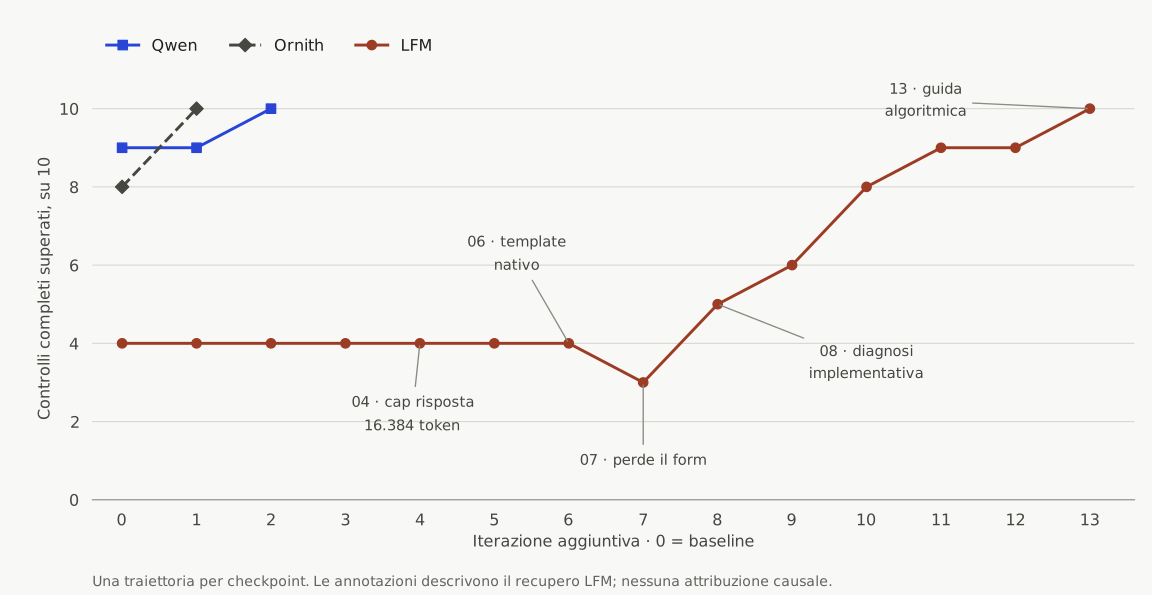
Ogni freccia della riga LFM corrisponde a un’esecuzione conservata, compresi i tentativi senza miglioramento. Il passaggio da quattro a tre è il round 07: una riscrittura perde il gestore del form. L’overflow mobile è un problema distinto, già presente, e non spiega quella perdita di punto.
Nel primo recupero Qwen usa tutte le 24 chiamate a strumenti disponibili. La sequenza include letture di script.js, sostituzioni e ripetuti check_files, poi altre sostituzioni e altri controlli. Il secondo round arriva ancora al limite di 24 strumenti, questa volta con i dieci controlli esterni superati.
Si tratta di una ripetizione operativa osservabile nei log. Qwen e Ornith avevano già enable_thinking=false nelle richieste native. Da questi passaggi non si può ricostruire un processo mentale interno, né dimostrare un difetto generale della famiglia Qwen. check_files verificava file e sintassi: il modello poteva ripeterlo senza vedere il dialogo ancora chiuso nel browser.
Ornith compie otto chiamate a strumenti e applica tre sostituzioni nel suo unico recupero. Il runner registra circa 48 secondi. In questa traiettoria il difetto si risolve rapidamente; quantità e difficoltà dei problemi iniziali erano però diverse da quelle dei concorrenti.
Quanto aiuto ha ricevuto LFM
Per LFM è cambiato il trattamento durante il percorso. Dopo i primi due tentativi senza progresso, il prompt diventa più focalizzato. Dal round 04 il limite della singola risposta sale da 8192 a 16384 token, mantenendo il tetto complessivo di 24.000. Dal round 06 cambia anche il formato dei messaggi inviati al modello, il template: si abbandona un prefisso sperimentale che chiudeva il blocco think e si usa il formato nativo, con thinking richiesto.
Dopo la regressione del round 07, il coordinatore limita gli strumenti alle piccole sostituzioni, usa istruzioni brevi in inglese e fornisce diagnosi implementative. Nel round 10 offre anche la dicitura italiana della conferma del form. Nel round 13 spiega come collegare i link durante la creazione delle schede, usare il progetto corrente, attivare la classe che apre il dialogo e mantenere il focus sul pulsante di chiusura.
Quella guida è consultabile nel prompt originale del round 13, insieme al diff prodotto. Il modello scrive le patch, ma riceve una parte sostanziale della soluzione. Il 10/10 finale va letto come risultato di un recupero fortemente assistito.
Le prove che chiedono una sequenza
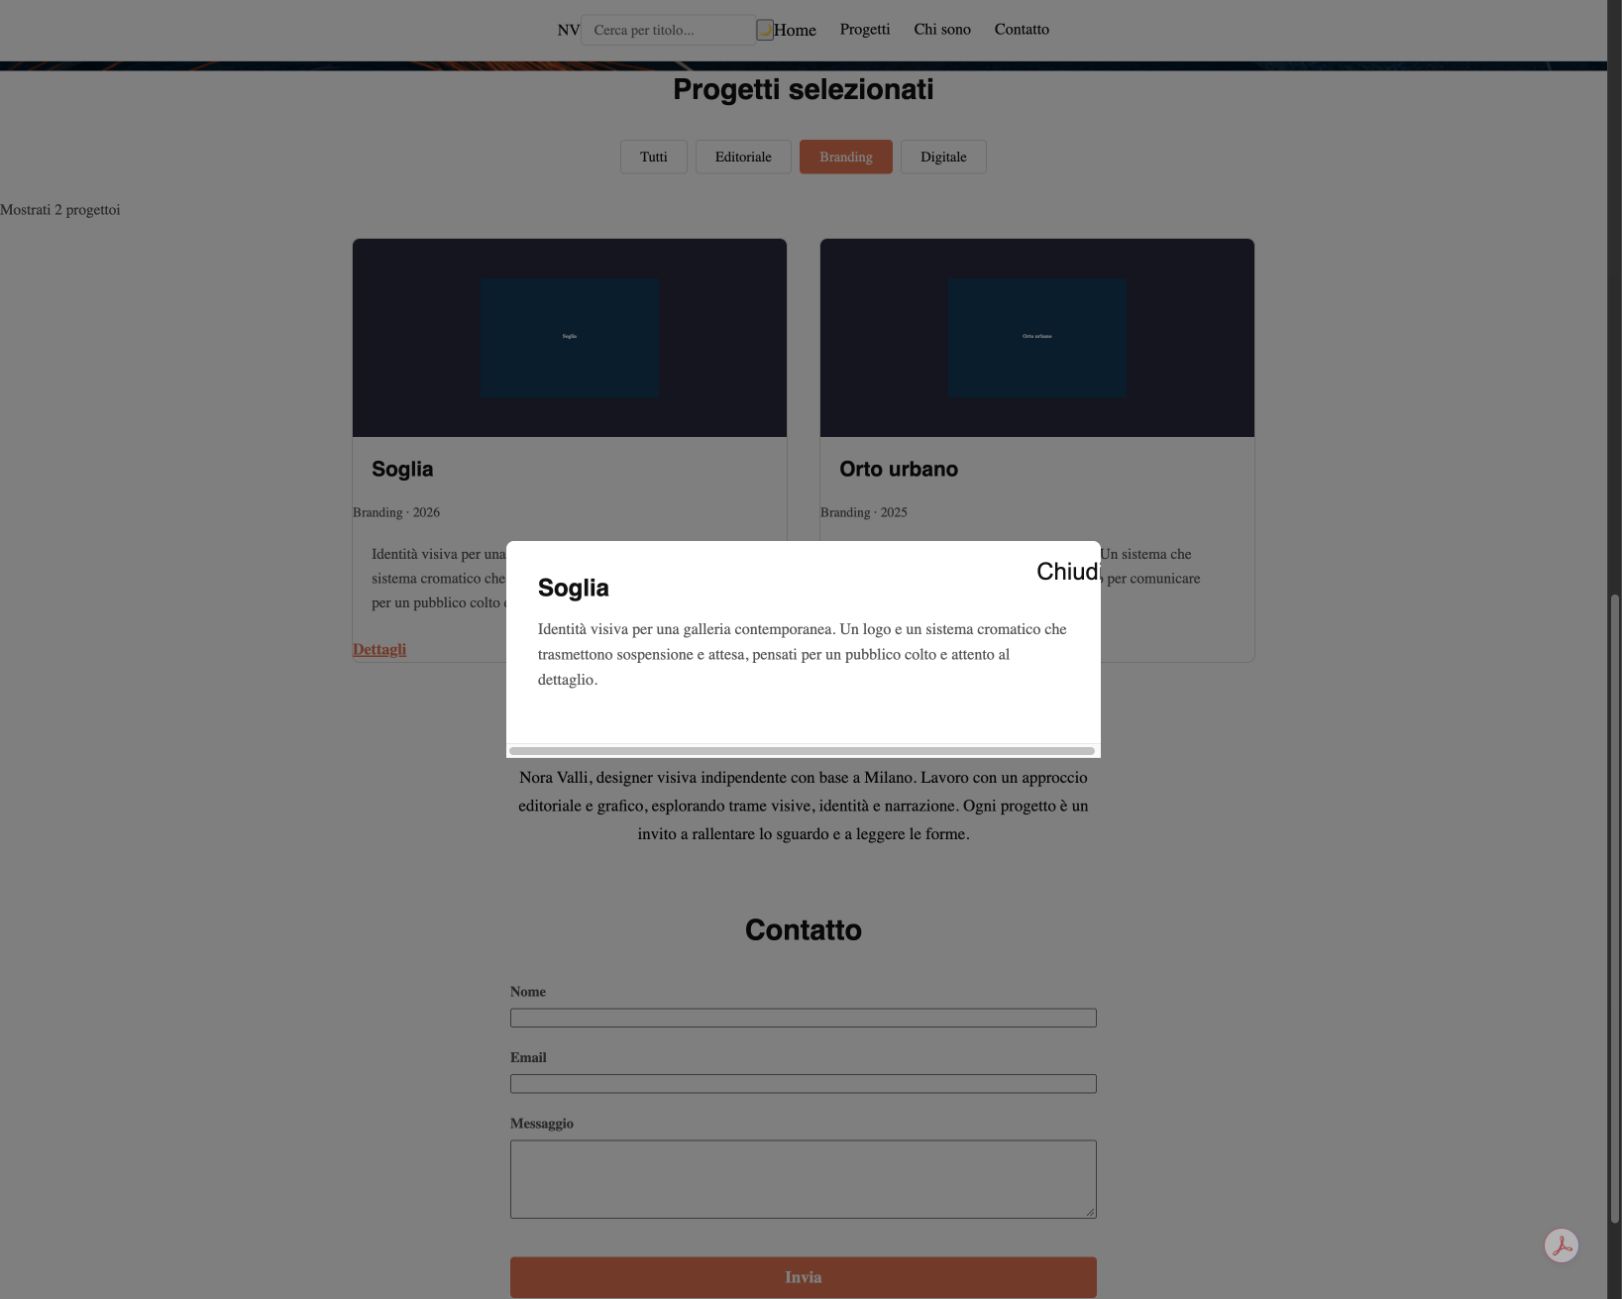
Un dialogo aperto è soltanto una parte della verifica. Occorre aprire ciascuno dei sei lavori, controllare contenuti coerenti, chiudere con pulsante ed Escape e ritrovare il focus sul collegamento iniziale. Tab e Shift+Tab sono stati provati su un dialogo rappresentativo. Le identità dei controlli e i risultati sono nei JSON degli audit: la fotografia del dialogo non dimostra da sola il contenimento del focus.
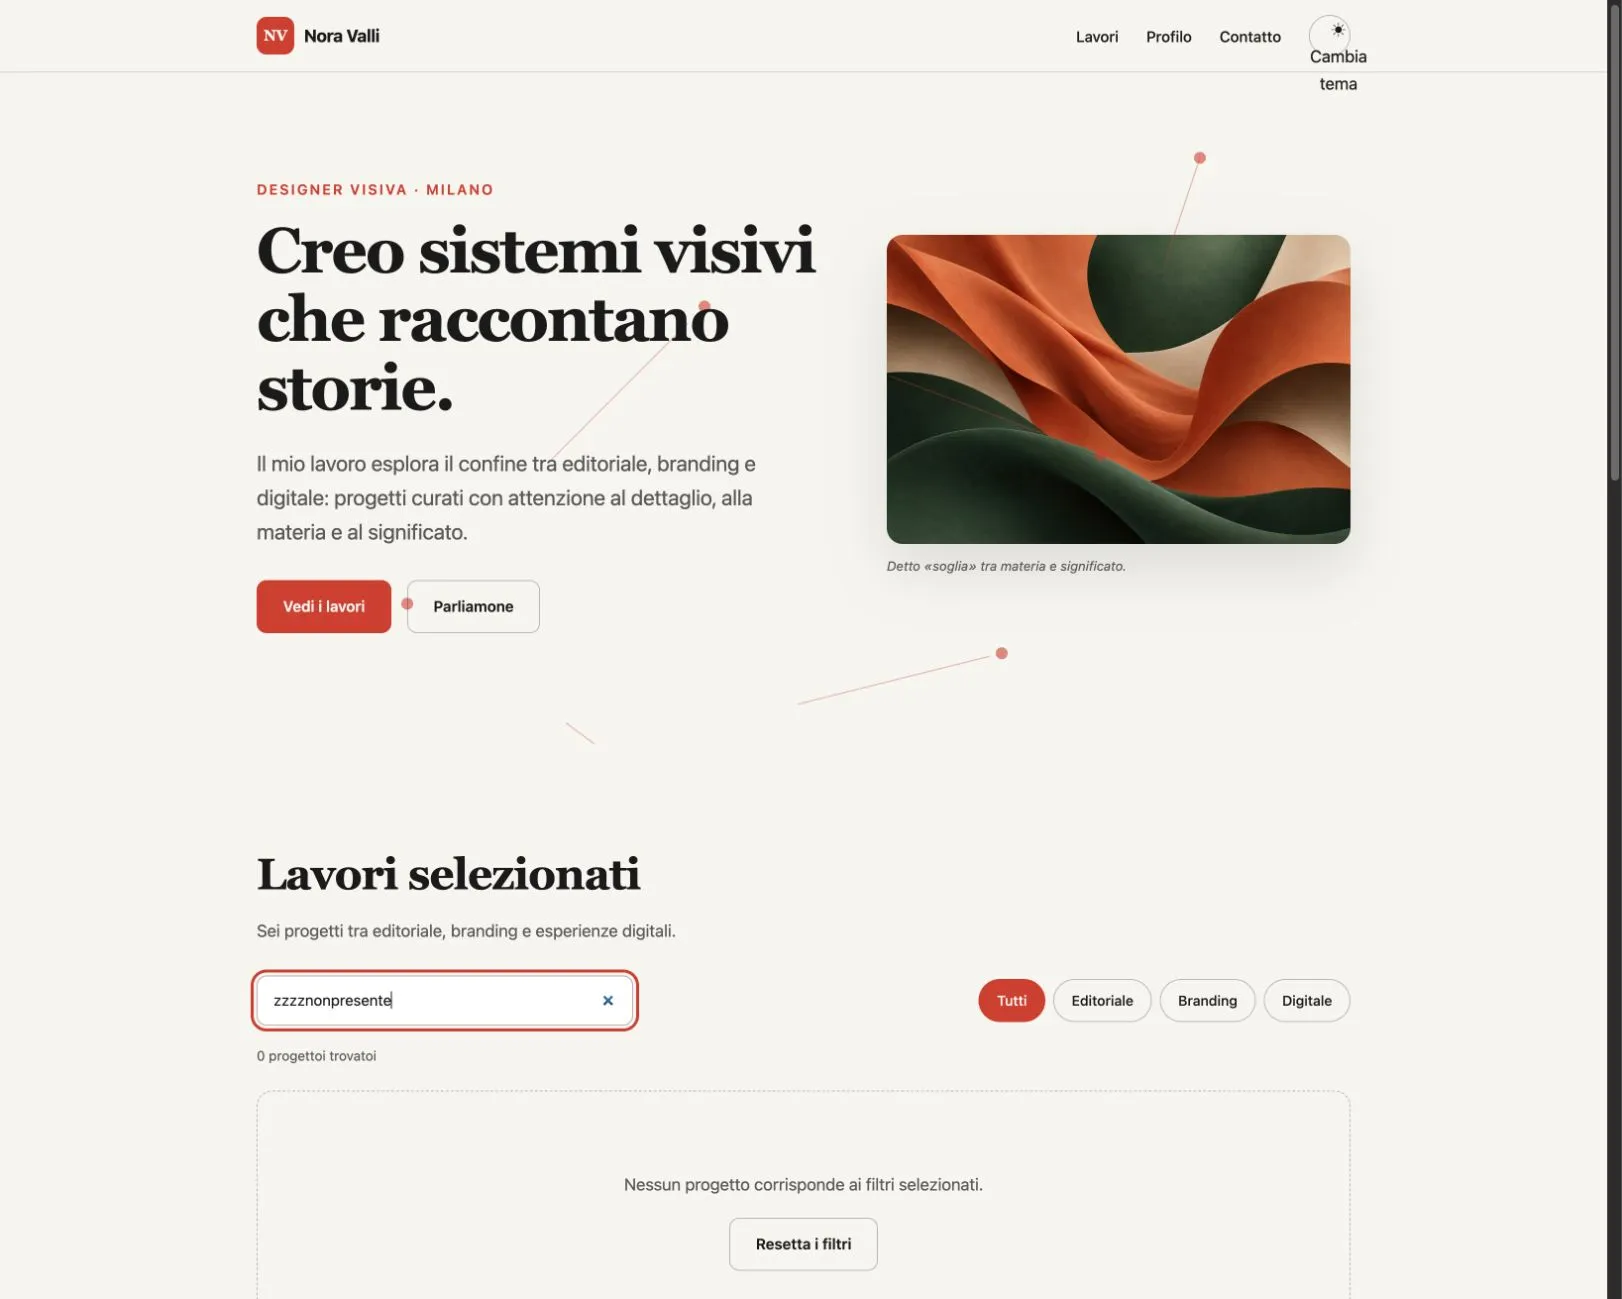
Lo stato vuoto ha bisogno di essere comprensibile e reversibile. In Ornith una ricerca senza corrispondenze mostra zero, un messaggio e il reset. Anche qui i difetti linguistici restano visibili.
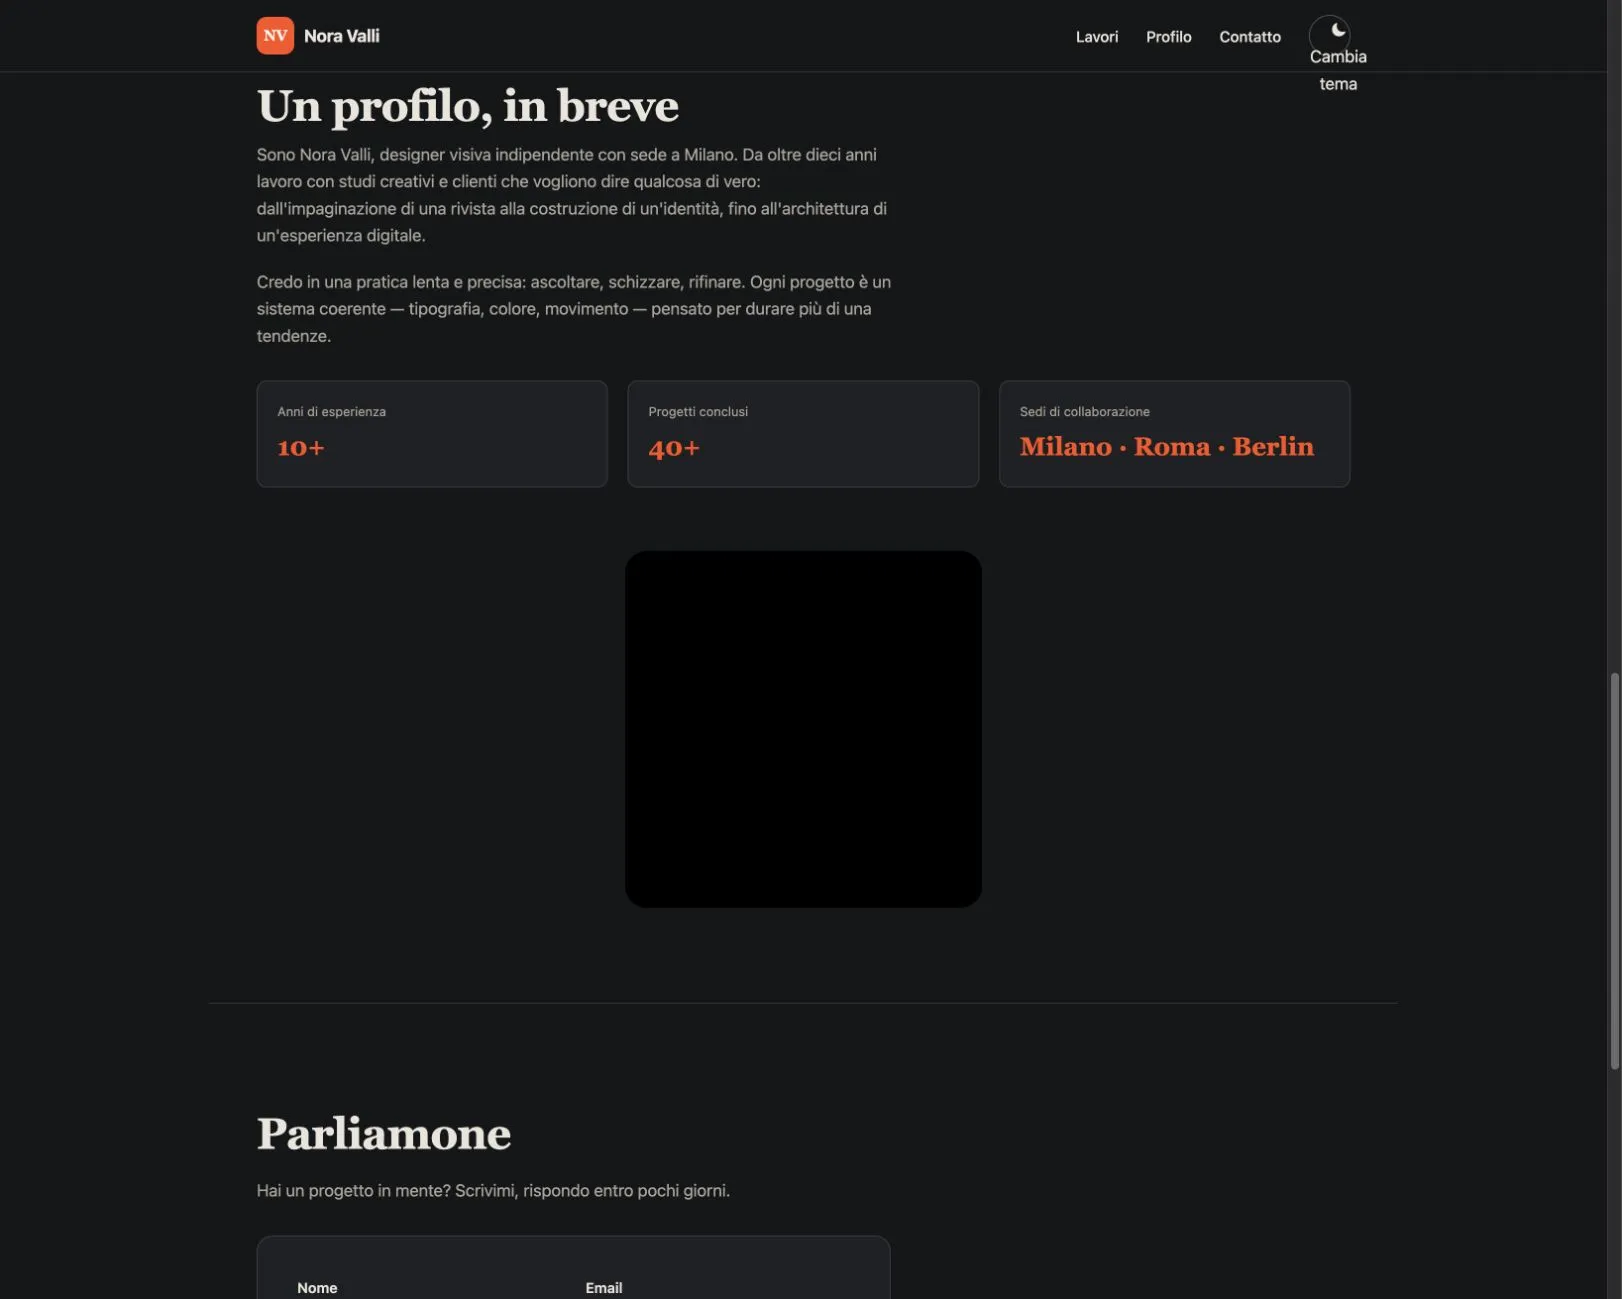
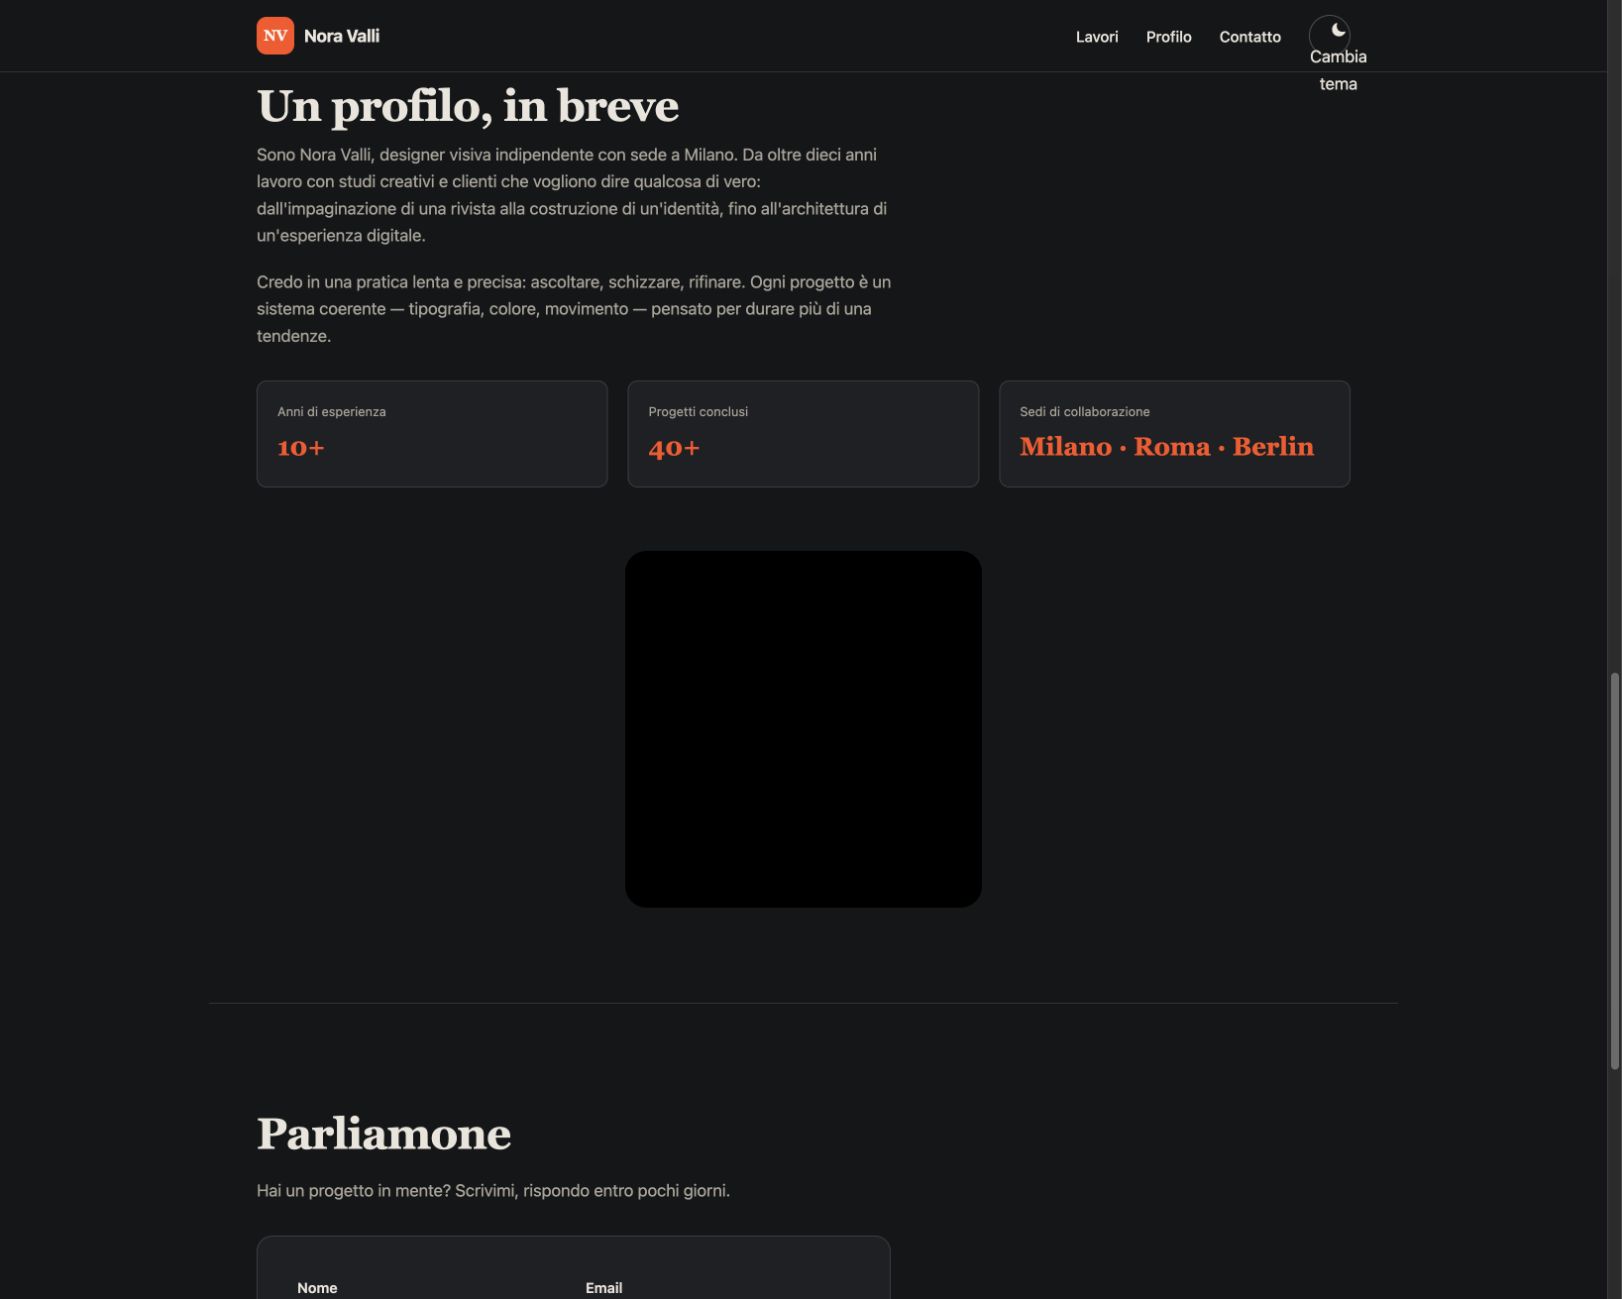
Per il tema, una pagina scura non prova la persistenza. La verifica richiede cambio, ricaricamento e confronto dello stato conservato. Il valutatore aveva inizialmente letto il colore troppo presto, all’inizio della transizione di Ornith: un falso negativo del test, corretto e documentato senza attribuire al modello un nuovo tentativo.
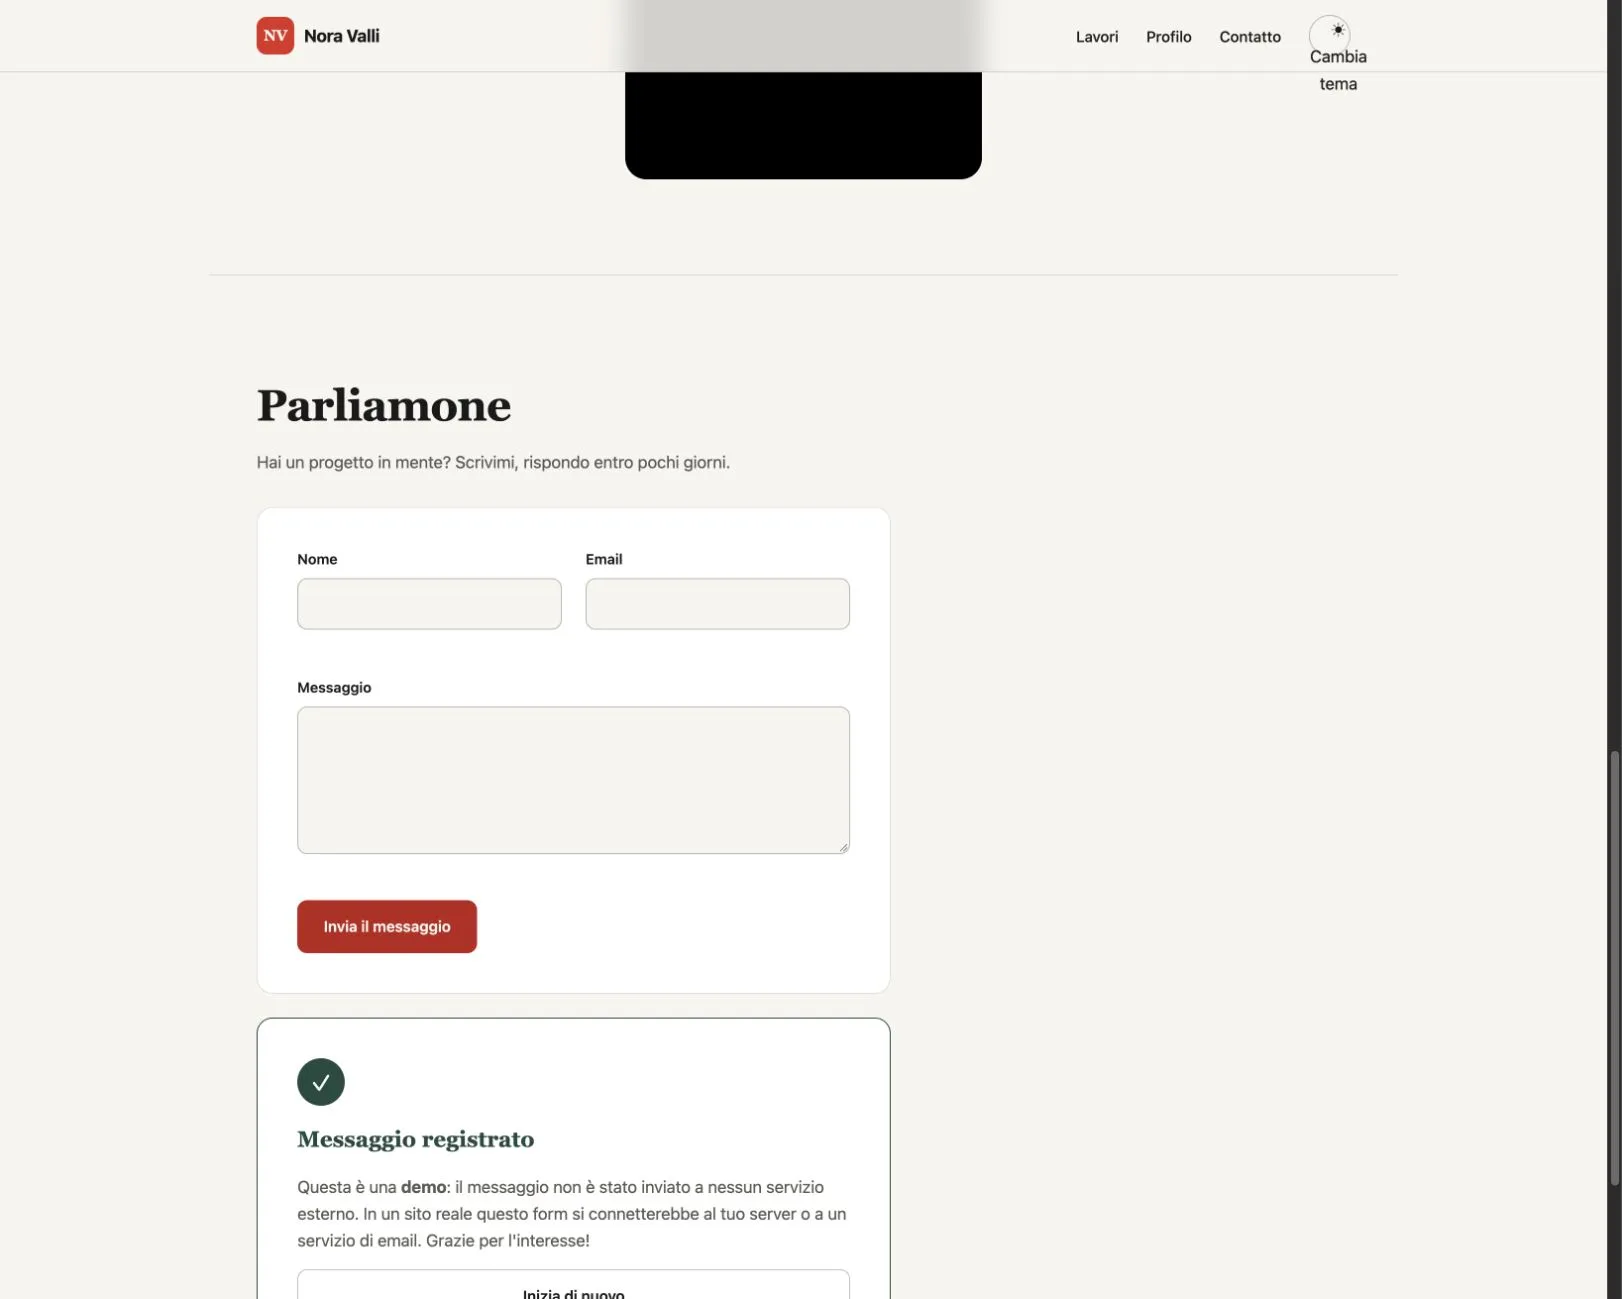
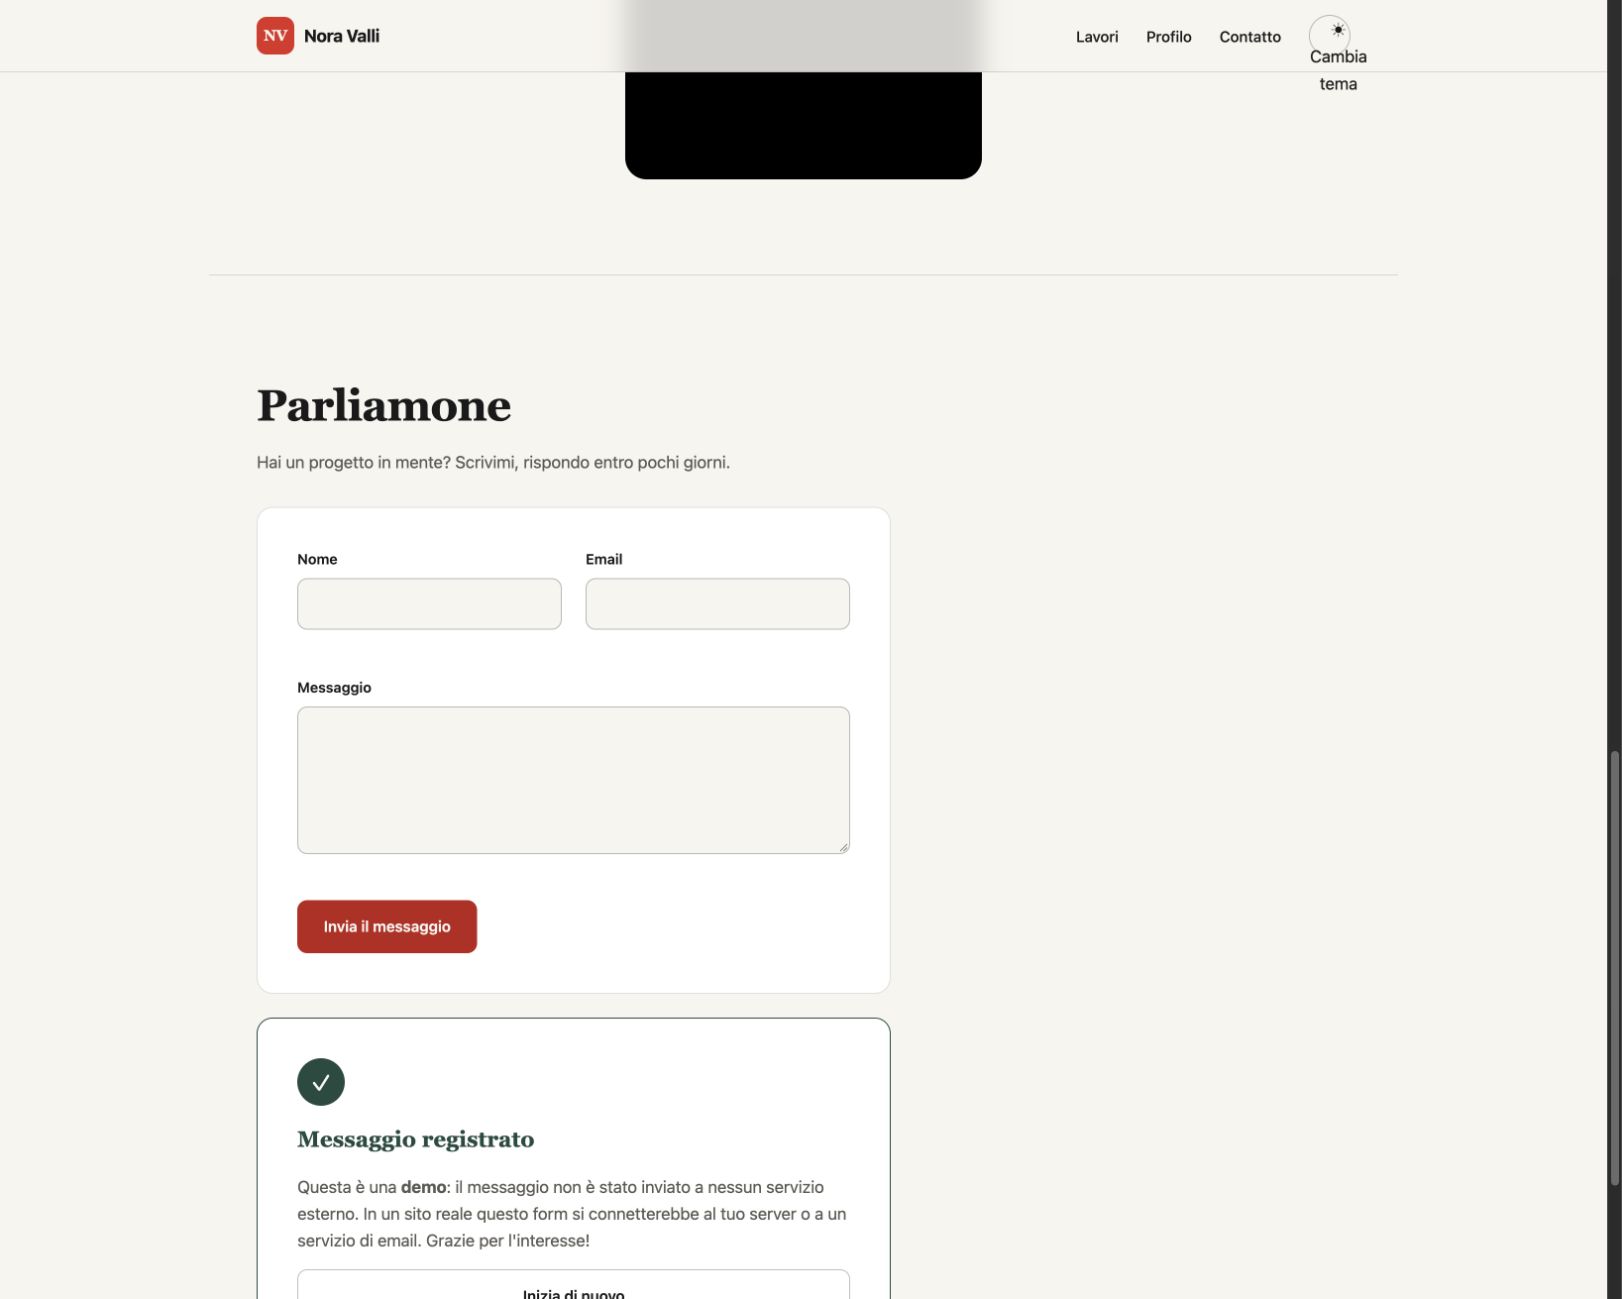
Il form doveva respingere dati mancanti ed email invalide, poi confermare localmente l’invio dimostrativo. Sono stati usati dati sintetici. La frase che dichiara “nulla inviato” è necessaria per il lettore, ma l’assenza di trasmissioni esterne si fonda anche sull’ispezione del codice del form, non sulla sola promessa scritta nella pagina.
Il telefono rende visibili altri problemi
Le quattro immagini seguenti hanno viewport 390×844. Il browser riserva 15 pixel alla scrollbar, quindi la larghezza del contenuto è 375 pixel. Nelle versioni finali di tutti e tre i portfolio, scrollWidth e clientWidth coincidono a 375.
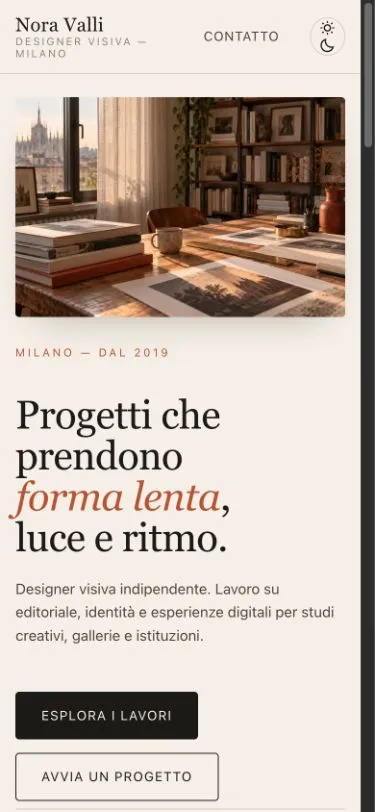
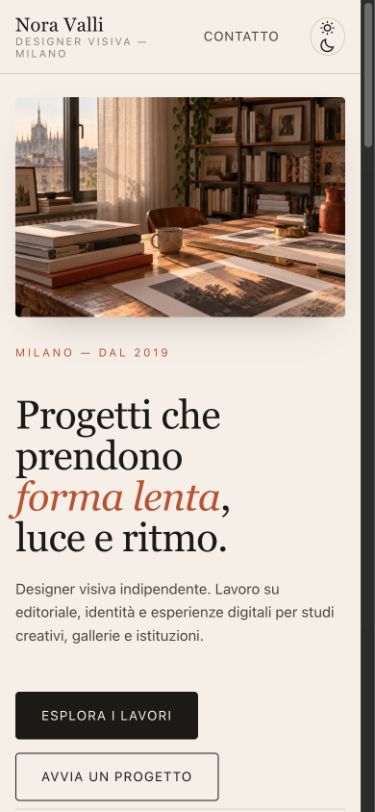
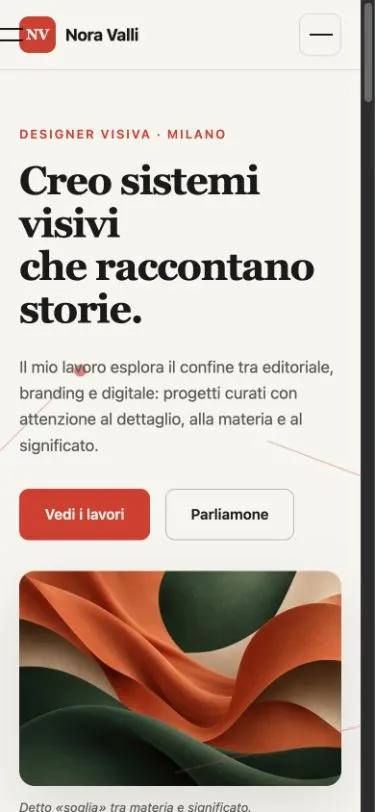
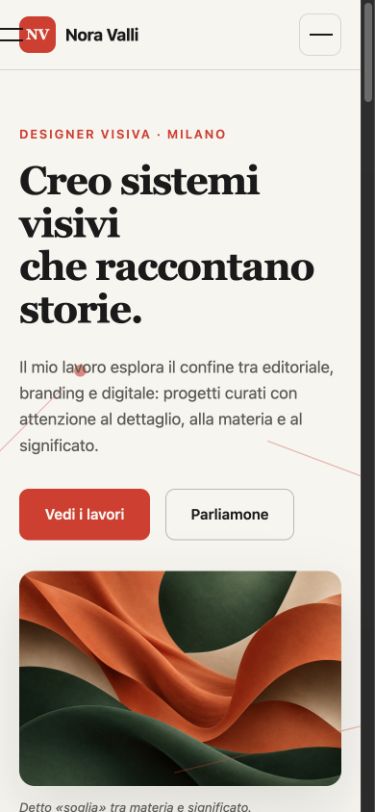
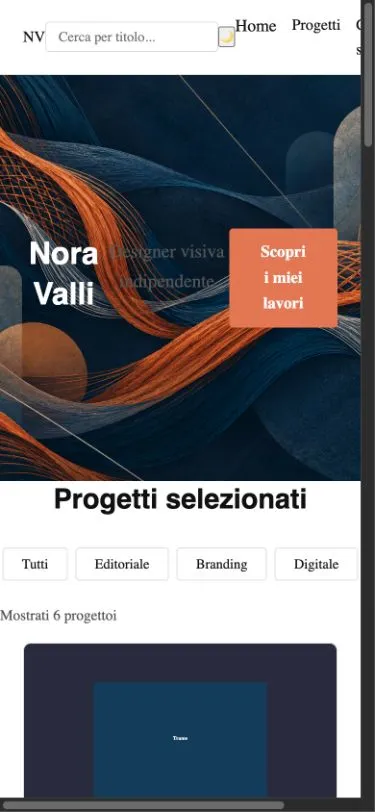
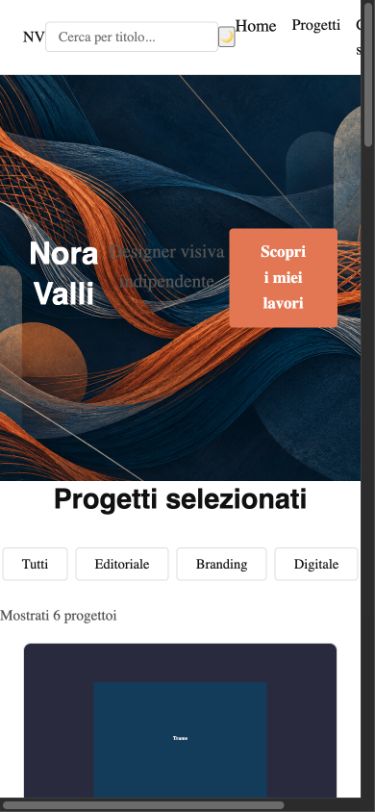
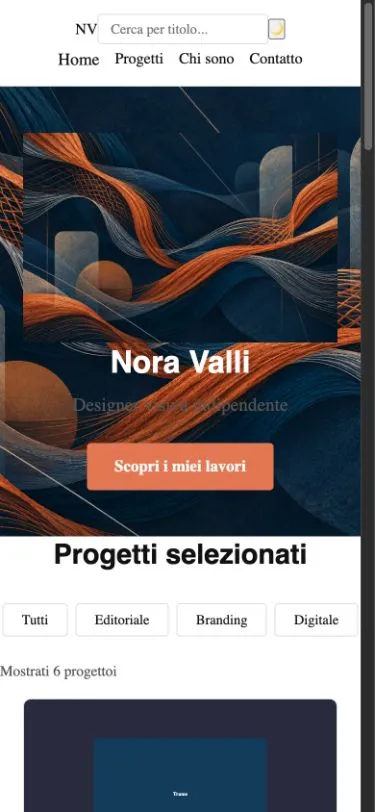
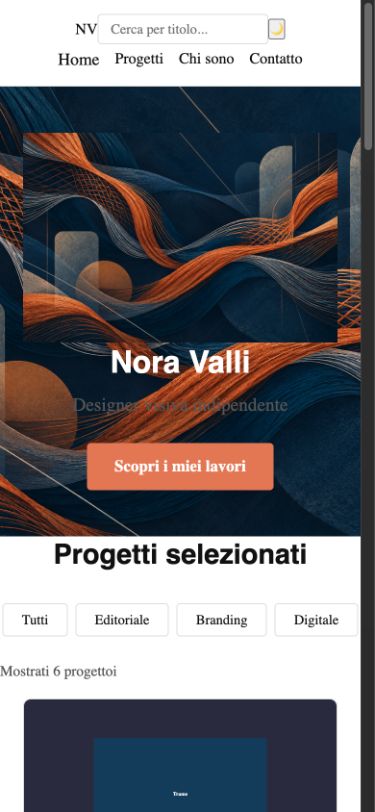
L’assenza di overflow è un controllo preciso e limitato. Non misura la comodità di ogni gesto, la leggibilità di tutti i testi o l’equilibrio della composizione. Per queste qualità bisogna continuare a usare e osservare la pagina.
Tutti a dieci, tre siti diversi
Queste sono le pagine finali, ancora da viewport desktop 1440×900. Le immagini originali dei portfolio sono rimaste identiche durante il recupero. Il codice ha cambiato alcuni comportamenti; l’impianto visivo continua a rendere riconoscibili tre risultati diversi.
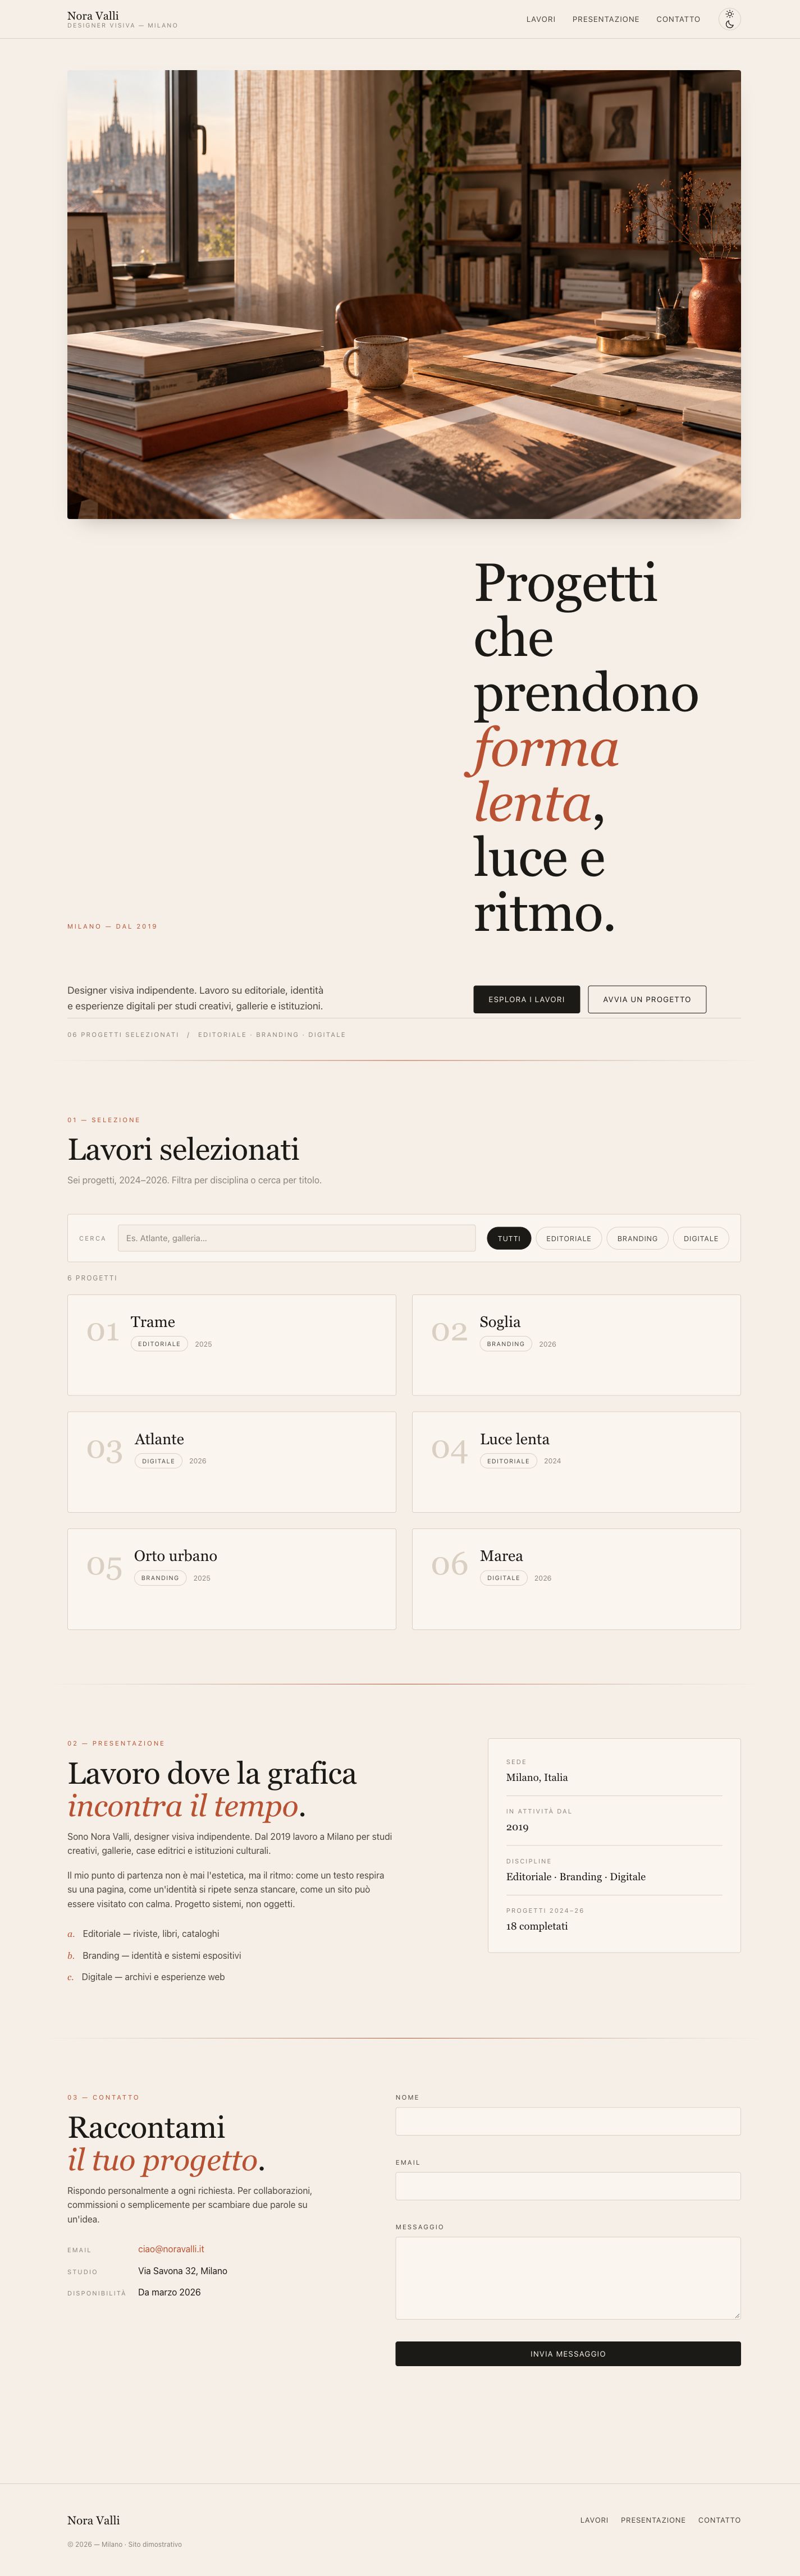
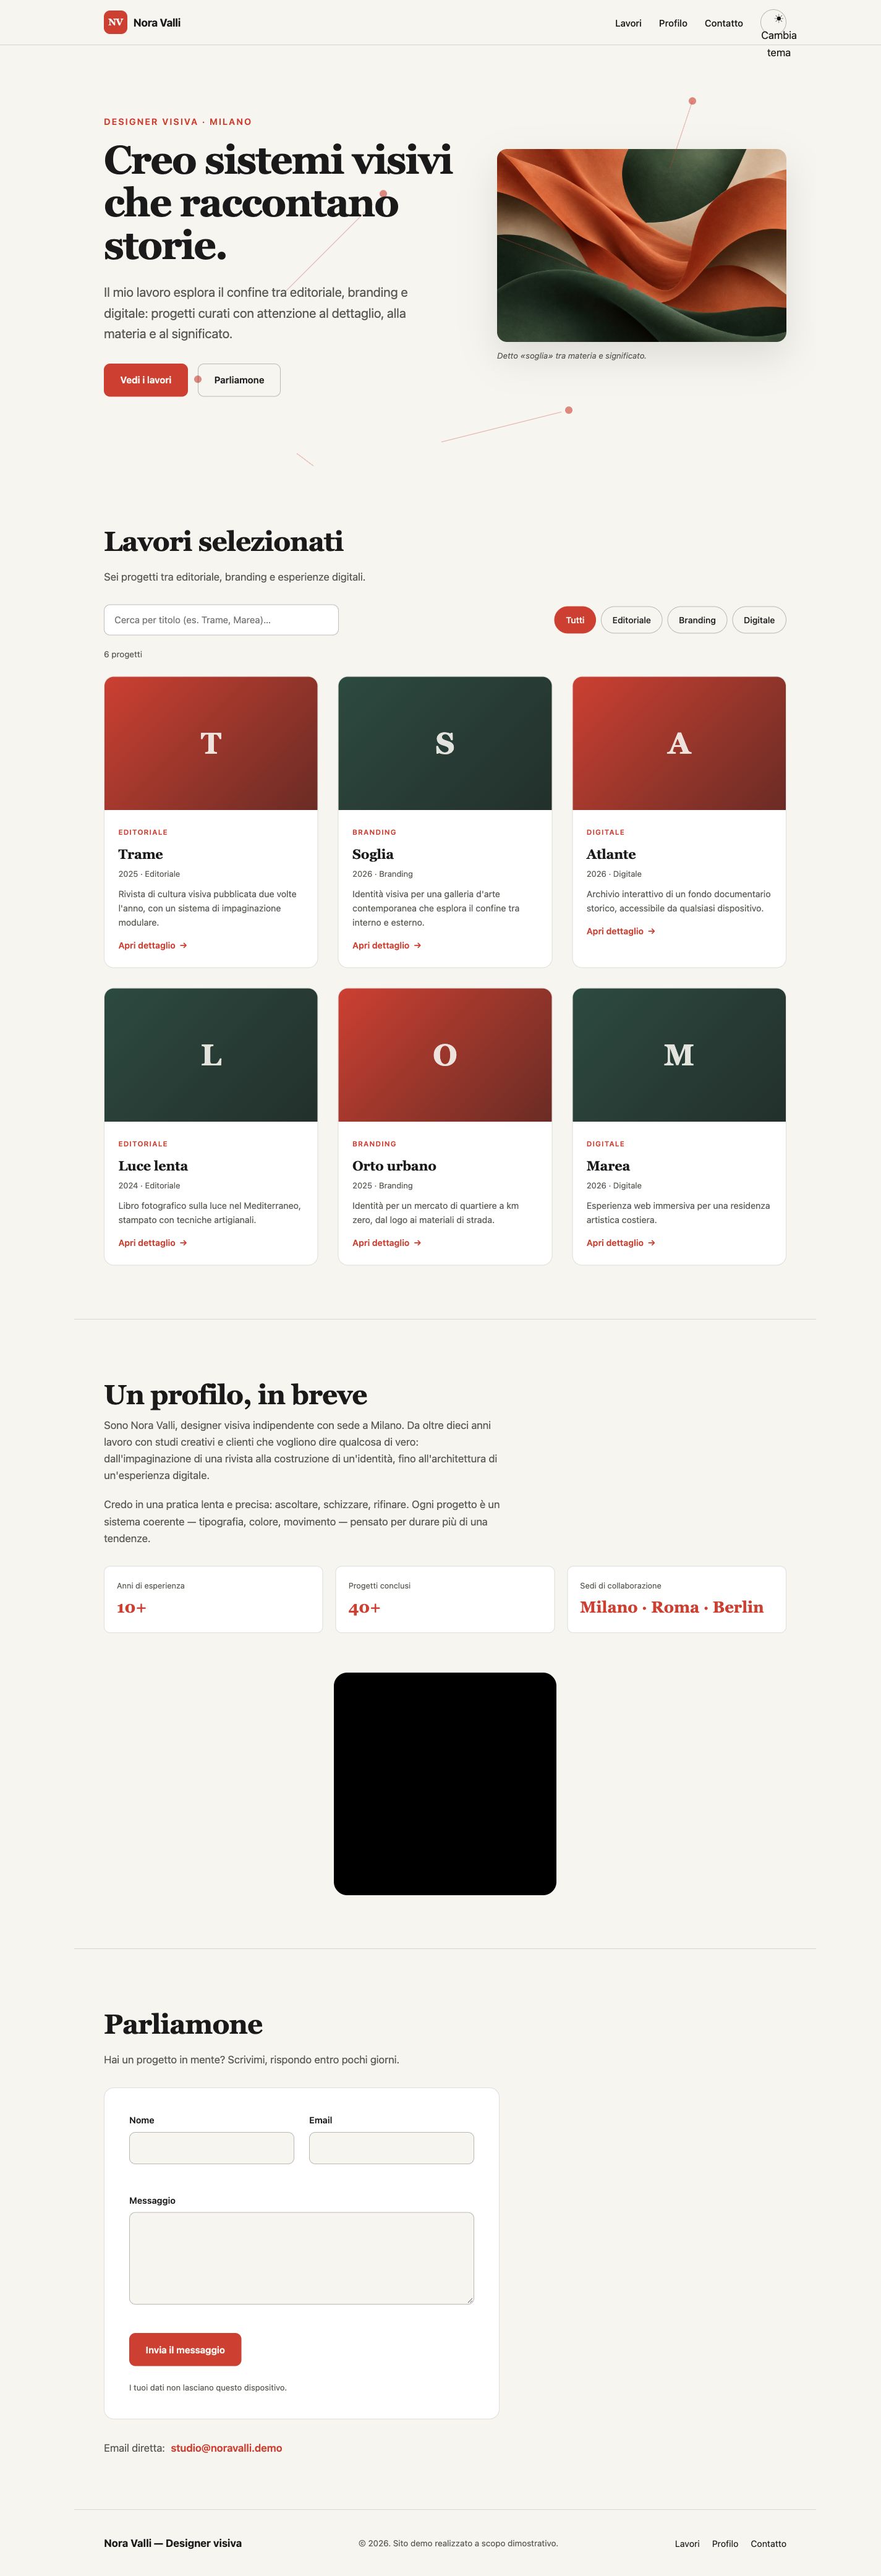
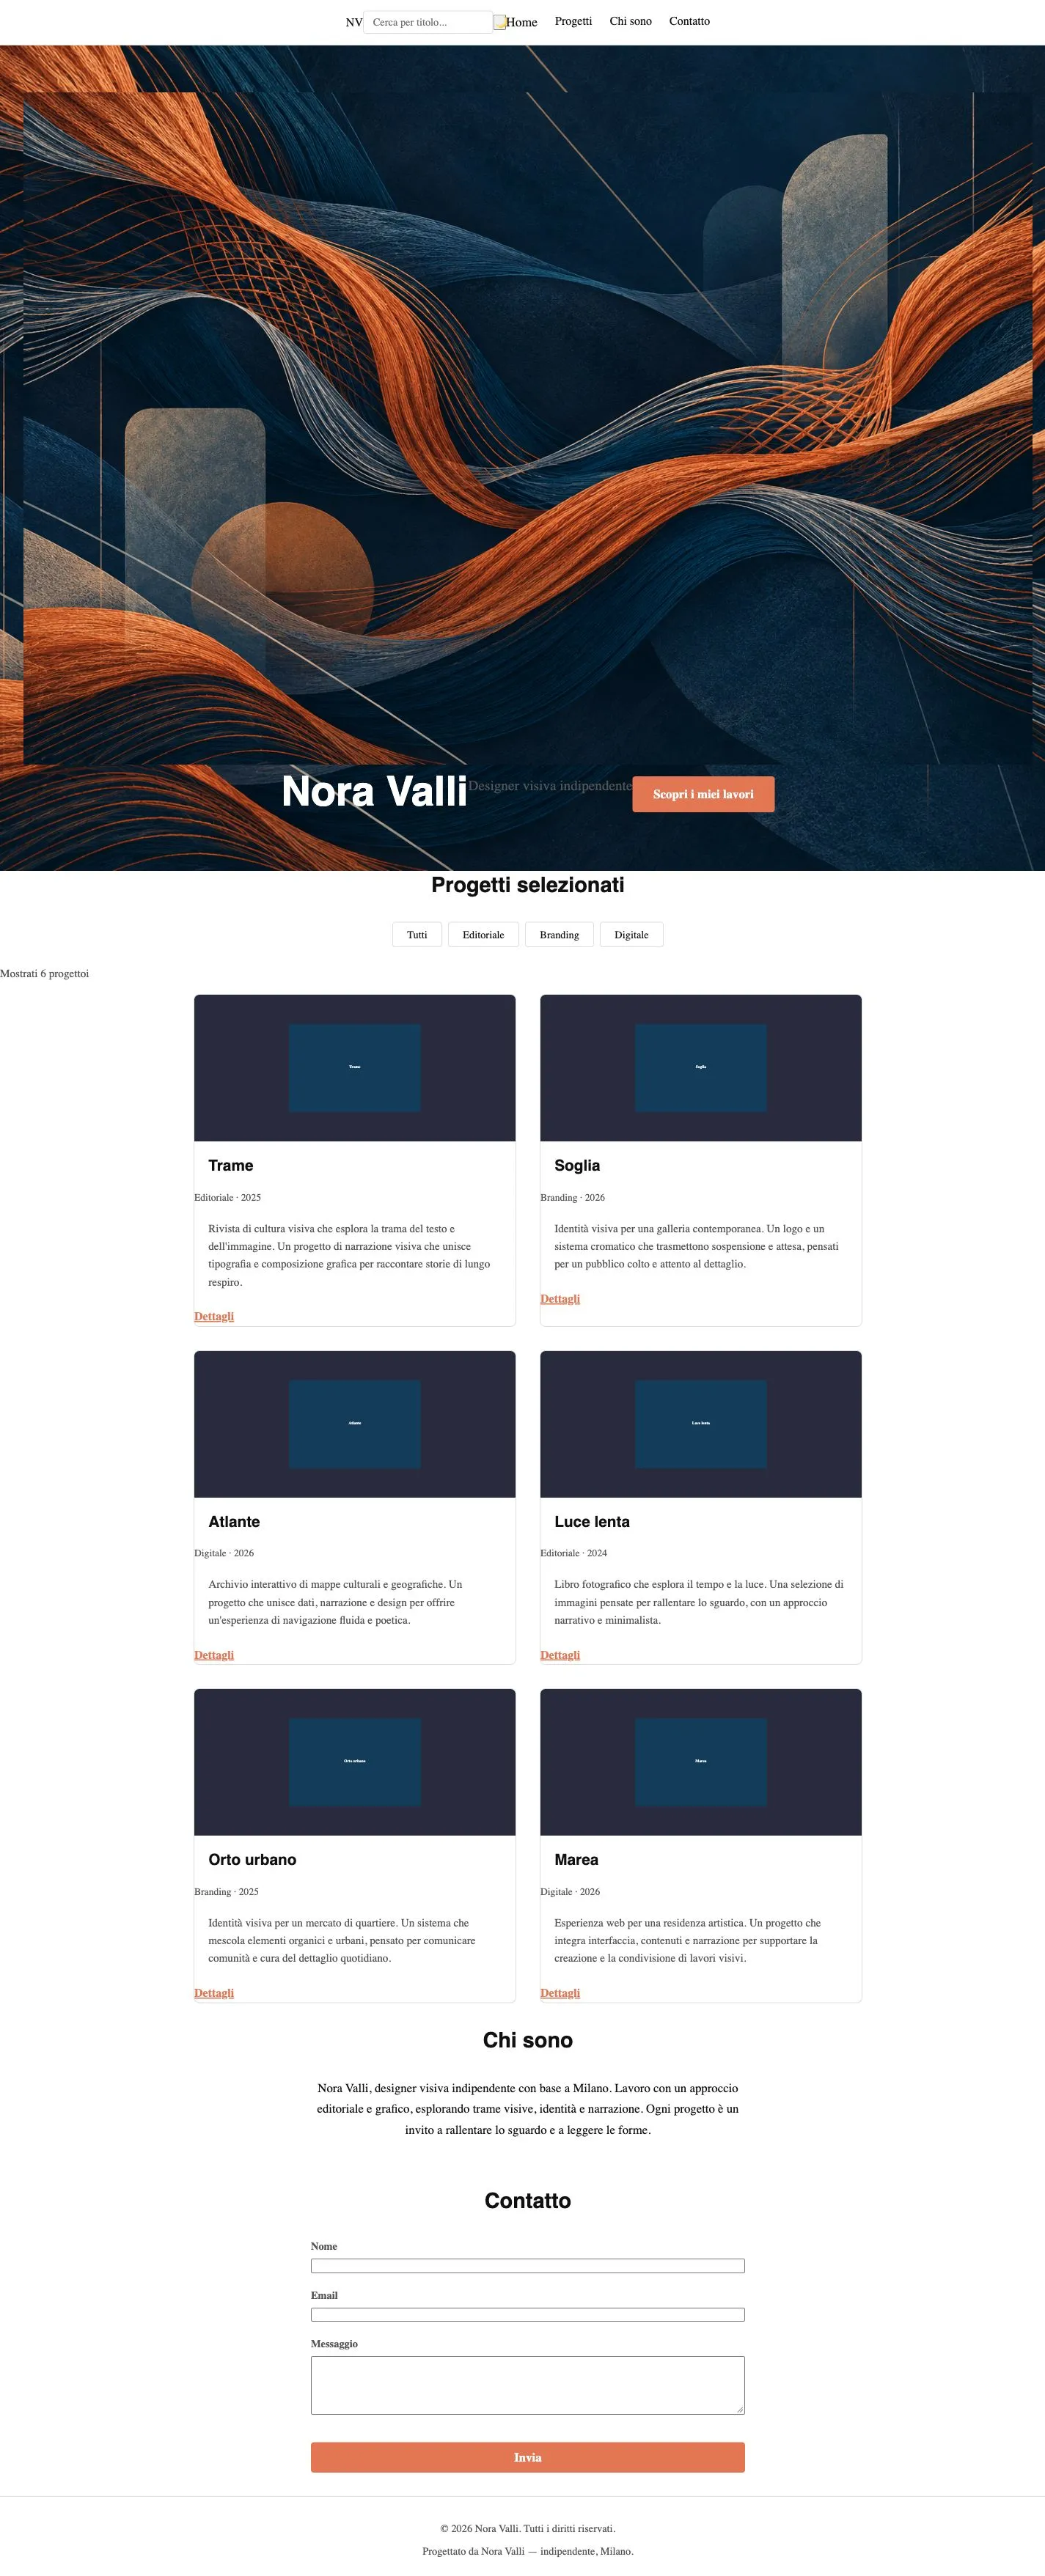
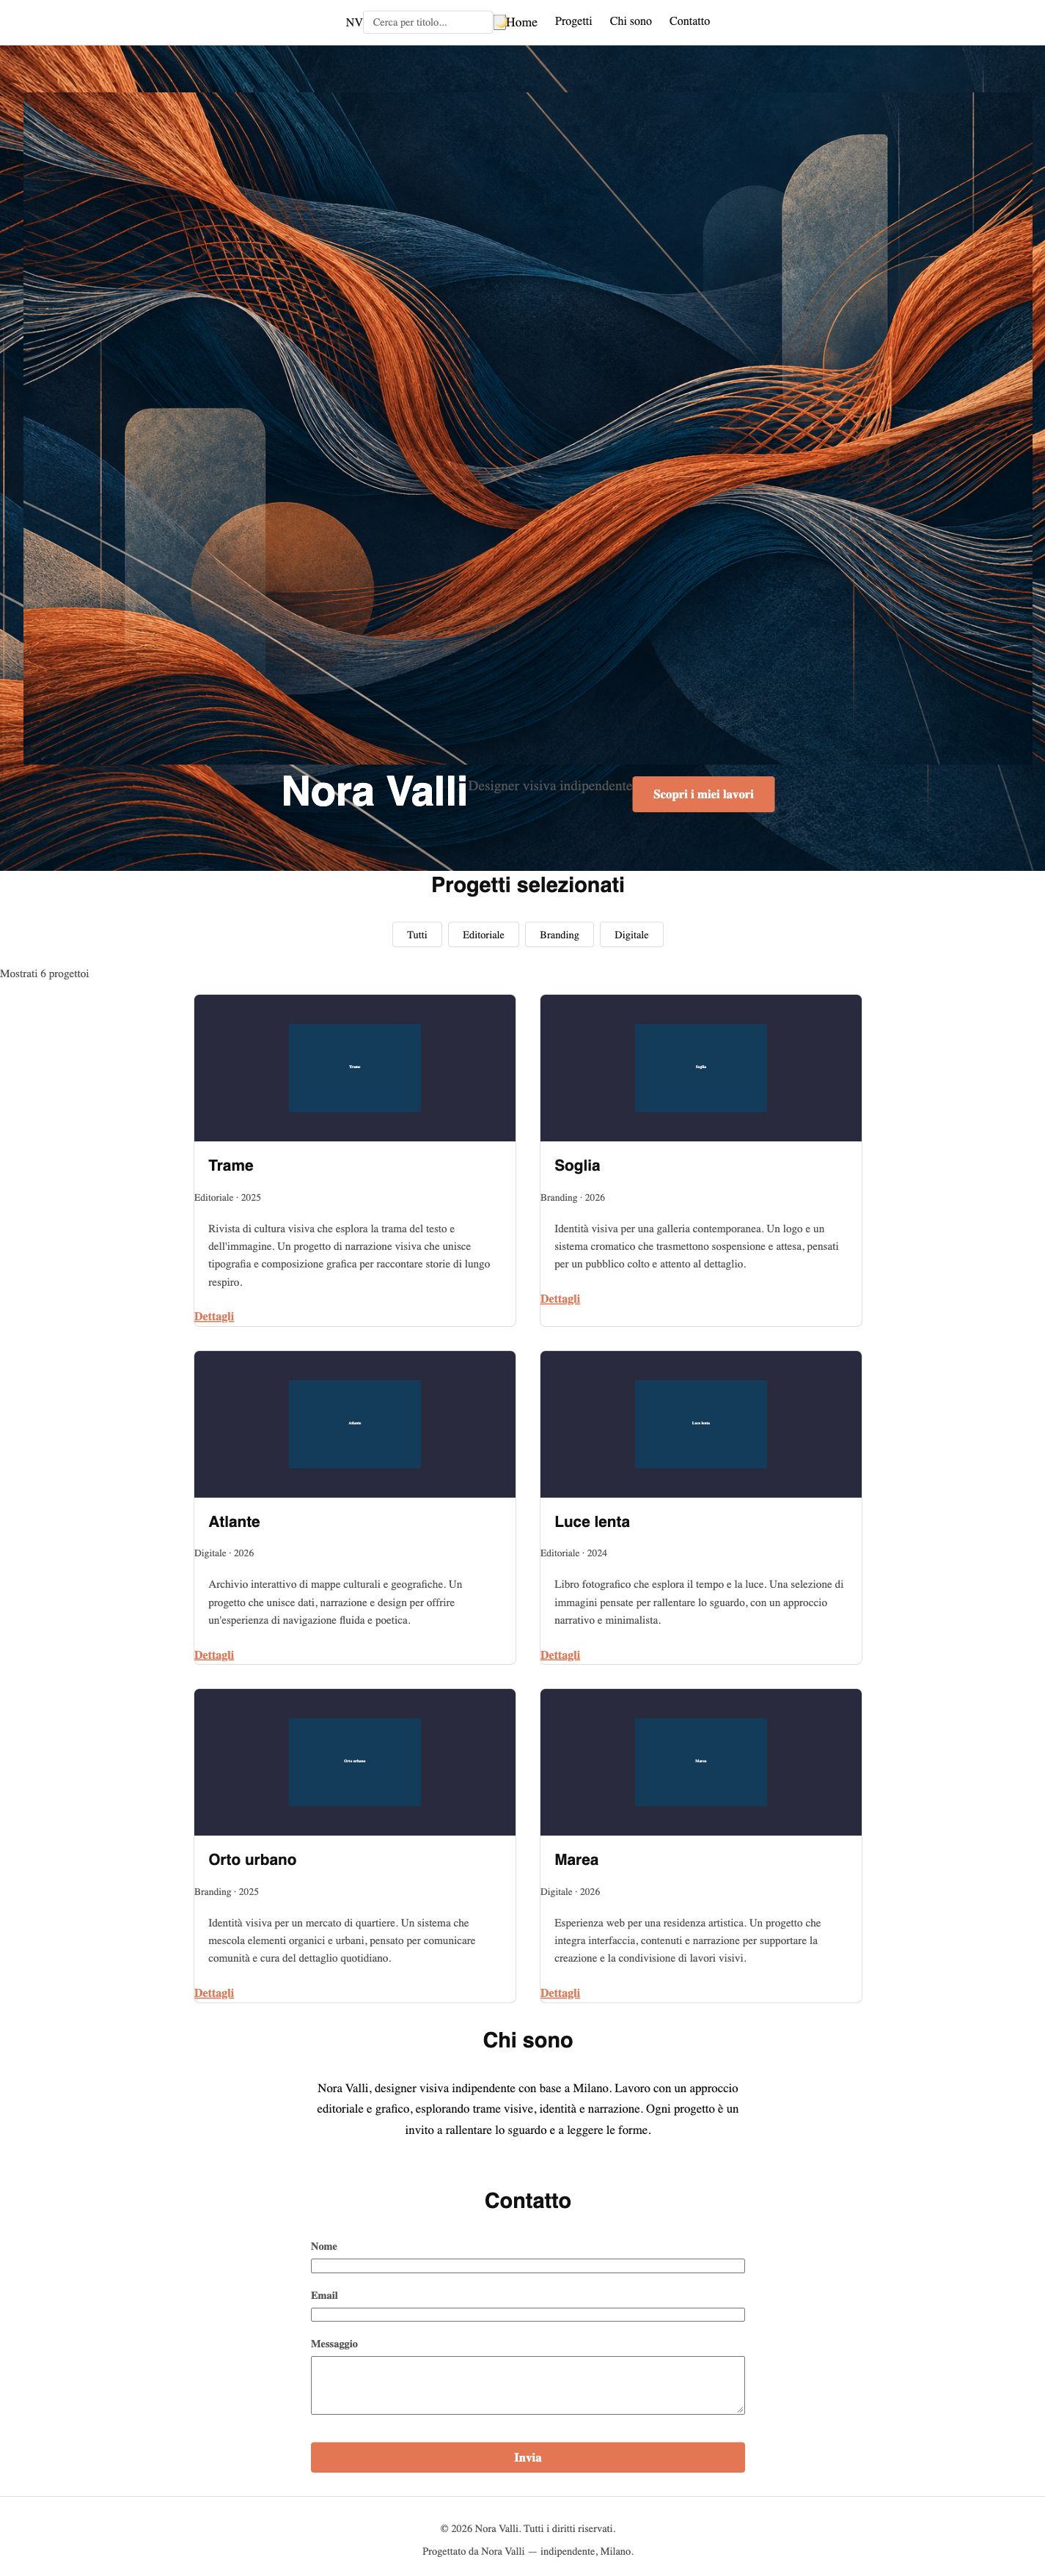
Nel giudizio che ho dato alla fine della prova, Qwen è il risultato estetico che preferisco, Ornith è molto buono, LFM non mi convince. Il suo 10/10 non modifica quella scelta. Il numero conta verifiche funzionali definite prima del recupero e precisate durante l’audit: non è un voto complessivo al web design.
Restano inoltre difetti fuori dal perimetro della suite. L’alternativa testuale finale dell’immagine LFM è generica. Gli attributi HTML di Qwen hanno bisogno di una revisione. Le frasi dei form e dei contatori richiedono attenzione editoriale. Un sito pronto per essere usato da altre persone avrebbe bisogno di controlli ulteriori.
Il tempo registrato e il lavoro che manca al conto
| Configurazione | Prima realizzazione | Recupero | Totale | Output registrato nel recupero |
|---|---|---|---|---|
| Qwen | 1656,4 s | 2470,1 s | 4126,6 s | almeno 7581 token |
| Ornith | 505,3 s | 48,2 s | 553,4 s | 873 token |
| LFM | 161,3 s | 2070,6 s | 2232,0 s | 139.532 token |
Le durate sono misurate dal programma che avvia e chiude ciascuna esecuzione, chiamato runner. Comprendono avvio, attese del server, lavoro dell’agente e pulizia finale. Queste durate non indicano il solo tempo della GPU e non comprendono tutto il lavoro di coordinamento e valutazione. I tempi delle richieste includono elaborazione del contesto, generazione e comunicazione locale, e si sovrappongono al tempo del runner: sommarli produrrebbe un doppio conteggio.
Qwen ha timeout e una richiesta interrotta senza conteggio finale dei token. I token registrati sono quindi un limite inferiore, sia nella baseline sia nel recupero. Nel recupero i nuovi input e le letture da cache risultano rispettivamente 849.146 e zero per Qwen, 18.149 e 76.388 per Ornith, 863.073 e 1.108.820 per LFM. Sono conteggi ripetuti per richiesta, non corpus di parole uniche. I tokenizer e i backend differiscono.
La misura API dei reasoning token separati è non disponibile, indicata come NA. Lo zero normalizzato nei record di Pi non dimostra assenza di ragionamento. Per LFM sono conservati 84 blocchi thinking emessi, il cui testo è stato ritokenizzato in 87.101 token: una misura derivata di una parte dell’output, da non sommare al totale e da non chiamare accesso al pensiero interno. Non esiste una misura affidabile dei secondi dedicati al reasoning.
Anche i token del coordinatore e il costo del generatore immagini non sono stati misurati. Non ricavo da questi numeri un costo economico, energetico o totale del sistema.
Dopo la prova ho disinstallato LFM: circa 13,59 GB di pesi e file di avvio rimossi. L’archivio dell’esperimento rimane intatto.
Che cosa rende verificabile questa prova
Alla fine la stessa suite congelata è stata rieseguita su tutte le 19 versioni conservate: tre baseline e sedici recuperi. I 190 verdetti individuali coincidono con i punteggi canonici. Questa rivalutazione controlla la coerenza degli artefatti dopo le correzioni del valutatore; non aggiunge repliche di inferenza.
Il protocollo di recupero è stato scritto dopo aver visto le baseline. Gli adattamenti successivi sono registrati nelle rettifiche. L’ordine non era randomizzato; i bug iniziali erano diversi; gli aiuti sono diventati molto differenti, soprattutto per LFM. Cache, backend e attività del sistema non erano identici o isolati. Il coordinatore operativo era un’AI e non un giudice umano indipendente. Il giudizio estetico successivo è il mio.
Con una traiettoria per checkpoint e un solo portfolio, i dati descrivono un caso. Non consentono una graduatoria universale, una stima statistica della probabilità di riuscita o una spiegazione causale dell’effetto del thinking. I test erano noti e il feedback li riguardava: raggiungere dieci su dieci misura la correzione di quel compito.
Quello che porto nel mio lavoro è un criterio concreto: verificare i gesti promessi, osservare la pagina anche dopo il punteggio e contare l’assistenza necessaria per arrivarci. La decisione di usare un risultato resta aperta al giudizio di chi lo deve usare.
Dati, fonti e provenienza
- Dati per iterazione, CSV, risultati JSON e riepilogo JSON.
- Protocollo di recupero, da leggere insieme alle rettifiche, ai ruoli e al giudizio estetico.
- Indice delle evidenze e azioni, URL e viewport delle catture editoriali. Le verifiche storiche sono nel pacchetto dei materiali; non sono nuove inferenze. Alcuni segni periferici appartengono al browser o alle estensioni.
- Qwen, repository alla revisione provata, Ornith, stessa identificazione fissata, LFM, scheda della quantizzazione.
Il pacchetto pubblico raccoglie dati, documenti di metodo, verifiche e immagini selezionate. Il manifest SHA256 permette di controllare i file scaricati. Percorsi e URL locali sono stati rimossi dalle copie dei documenti; i raster originali sono conservati senza ritocchi. Il giudizio estetico successivo resta distinto dai punteggi funzionali.