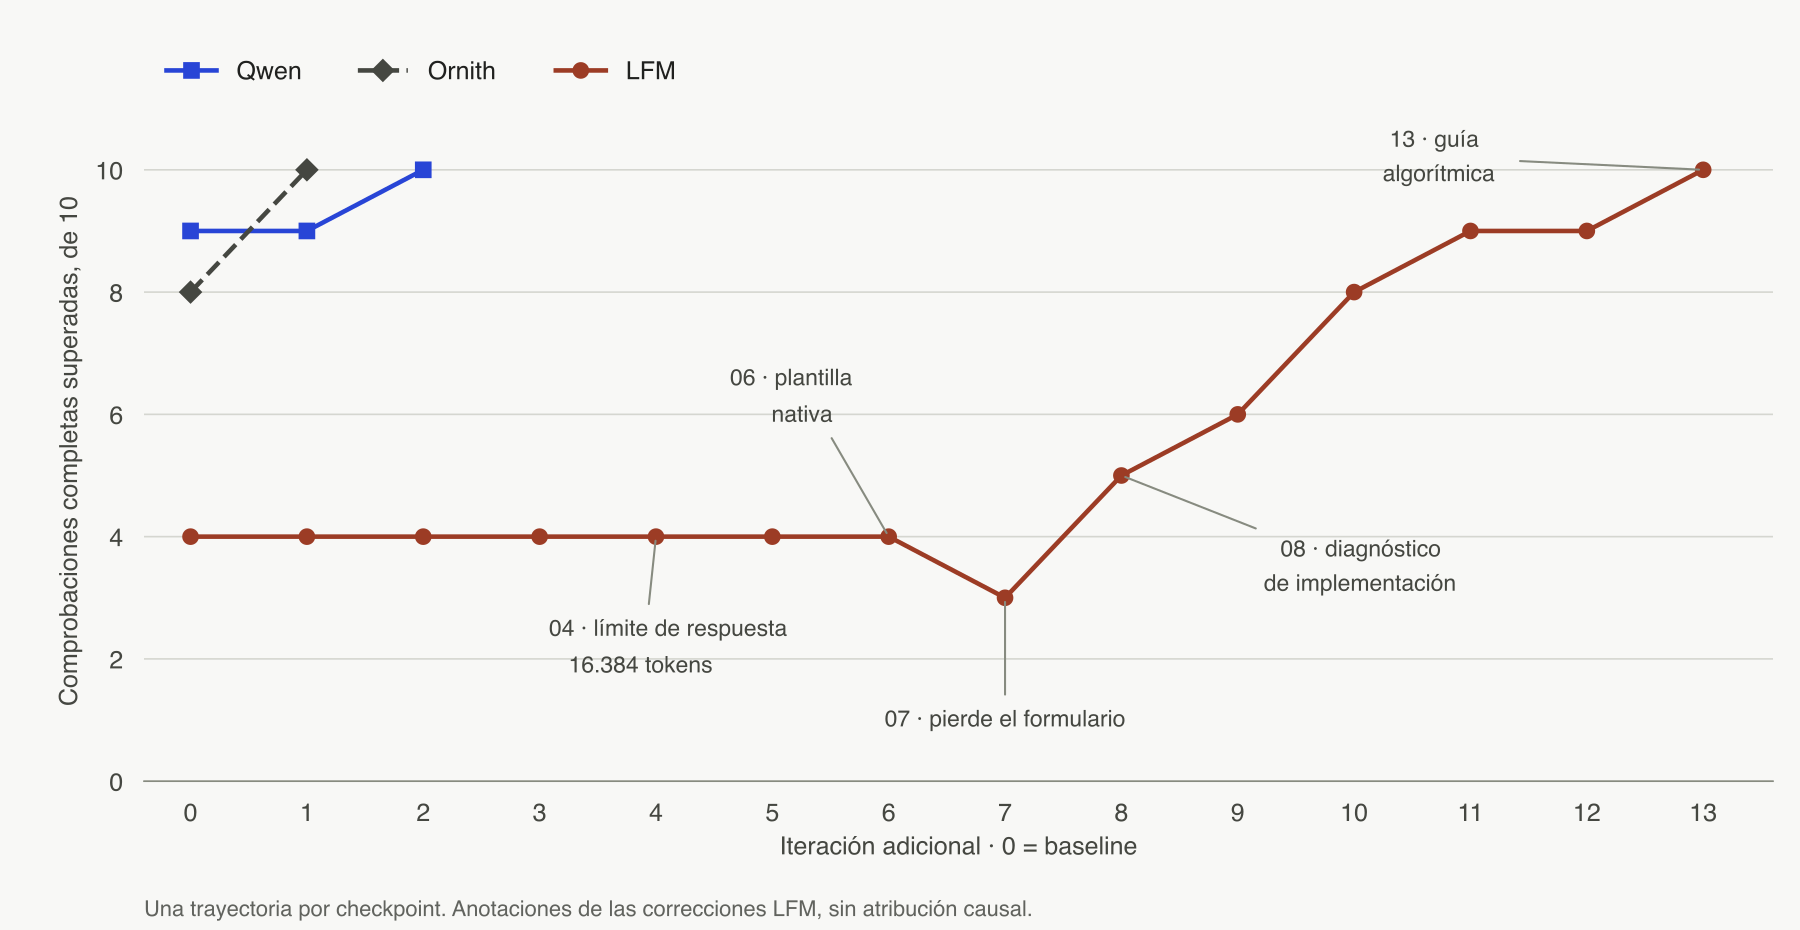
Pedí a tres modelos locales que construyeran el mismo portfolio. Al final todos superaron diez comprobaciones funcionales. Mi juicio sobre los sitios siguió siendo muy distinto: Qwen, el mejor estéticamente; Ornith, muy bueno; LFM, suspenso. Después de la prueba desinstalé LFM.
La distancia entre esas dos valoraciones explica por qué merece la pena mirar de cerca el trabajo. Un filtro puede funcionar en una página que no convence. Una composición lograda puede ocultar cuatro fichas imposibles de abrir. El tiempo para llegar a un resultado depende también de cuánta ayuda estemos dispuestos a dar.
Lo que sigue es el relato de una prueba realizada en mi Mac el 23 y 24 de octubre de 2026: una tarea y un recorrido documentado para cada configuración. Se conservaron archivos, pasos fallidos y correcciones. Las imágenes muestran qué cambió; los registros verifican lo que una captura no puede demostrar.
Un portfolio inventado, requisitos concretos
Nora Valli es una diseñadora imaginaria. También los trabajos son inventados: Trame y Luce lenta para editorial, Soglia y Orto urbano para branding, Atlante y Marea para digital. El brief fijaba nombres, categorías y años. Los modelos podían escribir las descripciones.
El encargo exigía tres archivos funcionales, HTML, CSS y JavaScript, sin frameworks, CDN ni fuentes remotas. Búsqueda y filtros debían combinarse, el contador seguir los resultados y el estado vacío aparecer cuando correspondiera. Cada proyecto debía abrir un detalle coherente, con cierre, Escape y gestión del foco. También se requerían tema persistente, presentación, formulario de demostración y composición sin desbordamiento a 390 y 1440 píxeles.
Para la primera versión, cada modelo podía pedir una imagen al mismo generador externo. Elegía el prompt y dónde colocar el archivo recibido. Ese servicio producía los píxeles: atribuirlos al modelo local confundiría dos trabajos distintos. Los tres archivos de imagen permanecieron iguales durante las correcciones; sus huellas digitales lo confirman.
Un asistente de IA coordinaba la prueba: preparó herramientas y comprobaciones, escribió comentarios y, en las fases avanzadas de LFM, aportó diagnósticos e indicaciones algorítmicas. Los modelos locales escribían y modificaban los archivos mediante herramientas controladas; no tenían navegador ni shell y no veían a los competidores. No se aplicaron correcciones manuales a los portfolios.
Para acceder a los archivos se usó Pi, un agente de programación que conecta las respuestas de los modelos con herramientas de lectura y escritura. Los modelos se ejecutaban con MLX, un framework de cálculo para Apple Silicon, mediante los dos backends de la ficha técnica. Este software organiza y ejecuta la prueba; las páginas se verificaban por separado en el navegador.
El Mac y el entorno de prueba
| Componente | Configuración del equipo utilizado |
|---|---|
| Ordenador | MacBook Pro de 16 pulgadas, 2026; identificador Mac17,8 |
| Procesador | Apple M5 Pro |
| CPU | 18 núcleos: 6 supernúcleos y 12 de rendimiento |
| GPU | 20 núcleos |
| RAM | 48 GB de memoria unificada; el sistema registra 51.539.607.552 bytes, equivalentes a 48 GiB |
| Ancho de banda de memoria | 307 GB/s nominales según Apple; no medidos en esta prueba |
| Neural Engine | 16 núcleos según Apple; el benchmark no mide su uso |
| Sistema operativo | macOS 27.0.1, build 26A434 |
| Alimentación | Conectado a la red eléctrica en la lectura inicial |
| Agente | Pi 1.2.0 |
| Runtime | Node 26.11.1; Python 3.15.0 para los scripts de la prueba |
| Navegador de verificación | Chrome 155.0.8059.85 |
| Backend Qwen | mlx-vlm 0.6.15, MLX 0.32.1 |
| Backend Ornith y LFM | mlx-lm 0.32.2, MLX 0.32.4 |
Chip, memoria, alimentación, sistema y GPU están documentados en los registros. El modelo preciso de Mac y el detalle de núcleos CPU se añadieron en un inventario local posterior, también el 24 de octubre: no se incluyen números de serie ni UUID. El identificador corresponde al MacBook Pro de 16 pulgadas de 2026; los nombres de los núcleos y valores nominales proceden de las especificaciones de Apple.
Los modelos se ejecutaron uno cada vez. El Mac también realizaba otras tareas: la carga del sistema no estaba aislada. No se midieron la capacidad física del SSD, el consumo energético ni el rendimiento térmico. El ancho de banda nominal no debe interpretarse como velocidad de generación observada.
| Nombre usado en el relato | Checkpoint utilizado | Revisión |
|---|---|---|
| Qwen | orcarouter/Qwen3.8-27B-Uncensored-MLX, variante de 4 bits | 34c32b5b1b2c24181e121a5cba3df8924fa66bce |
| Ornith | ornith-ai/Ornith-1.5-35B-A3B-MLX-4bit | 19504d912fa8fc7622bf6b1de3db5d5d890b1f02 |
| LFM | LiquidAI/LFM2.5-24B-A2B-MLX-4bit | 667408d494bde191c2cb9dd4f4549827816b9275 |
Estas versiones precisas de los modelos, llamadas checkpoints, identifican las configuraciones probadas. No representan de forma intercambiable familias enteras. Se verificó su identidad en las fichas de repositorio de las revisiones indicadas. Se conserva completo el nombre comunitario de Qwen: esta prueba no evaluó las capacidades sugeridas por «uncensored».
Tres direcciones visuales, antes de las puntuaciones
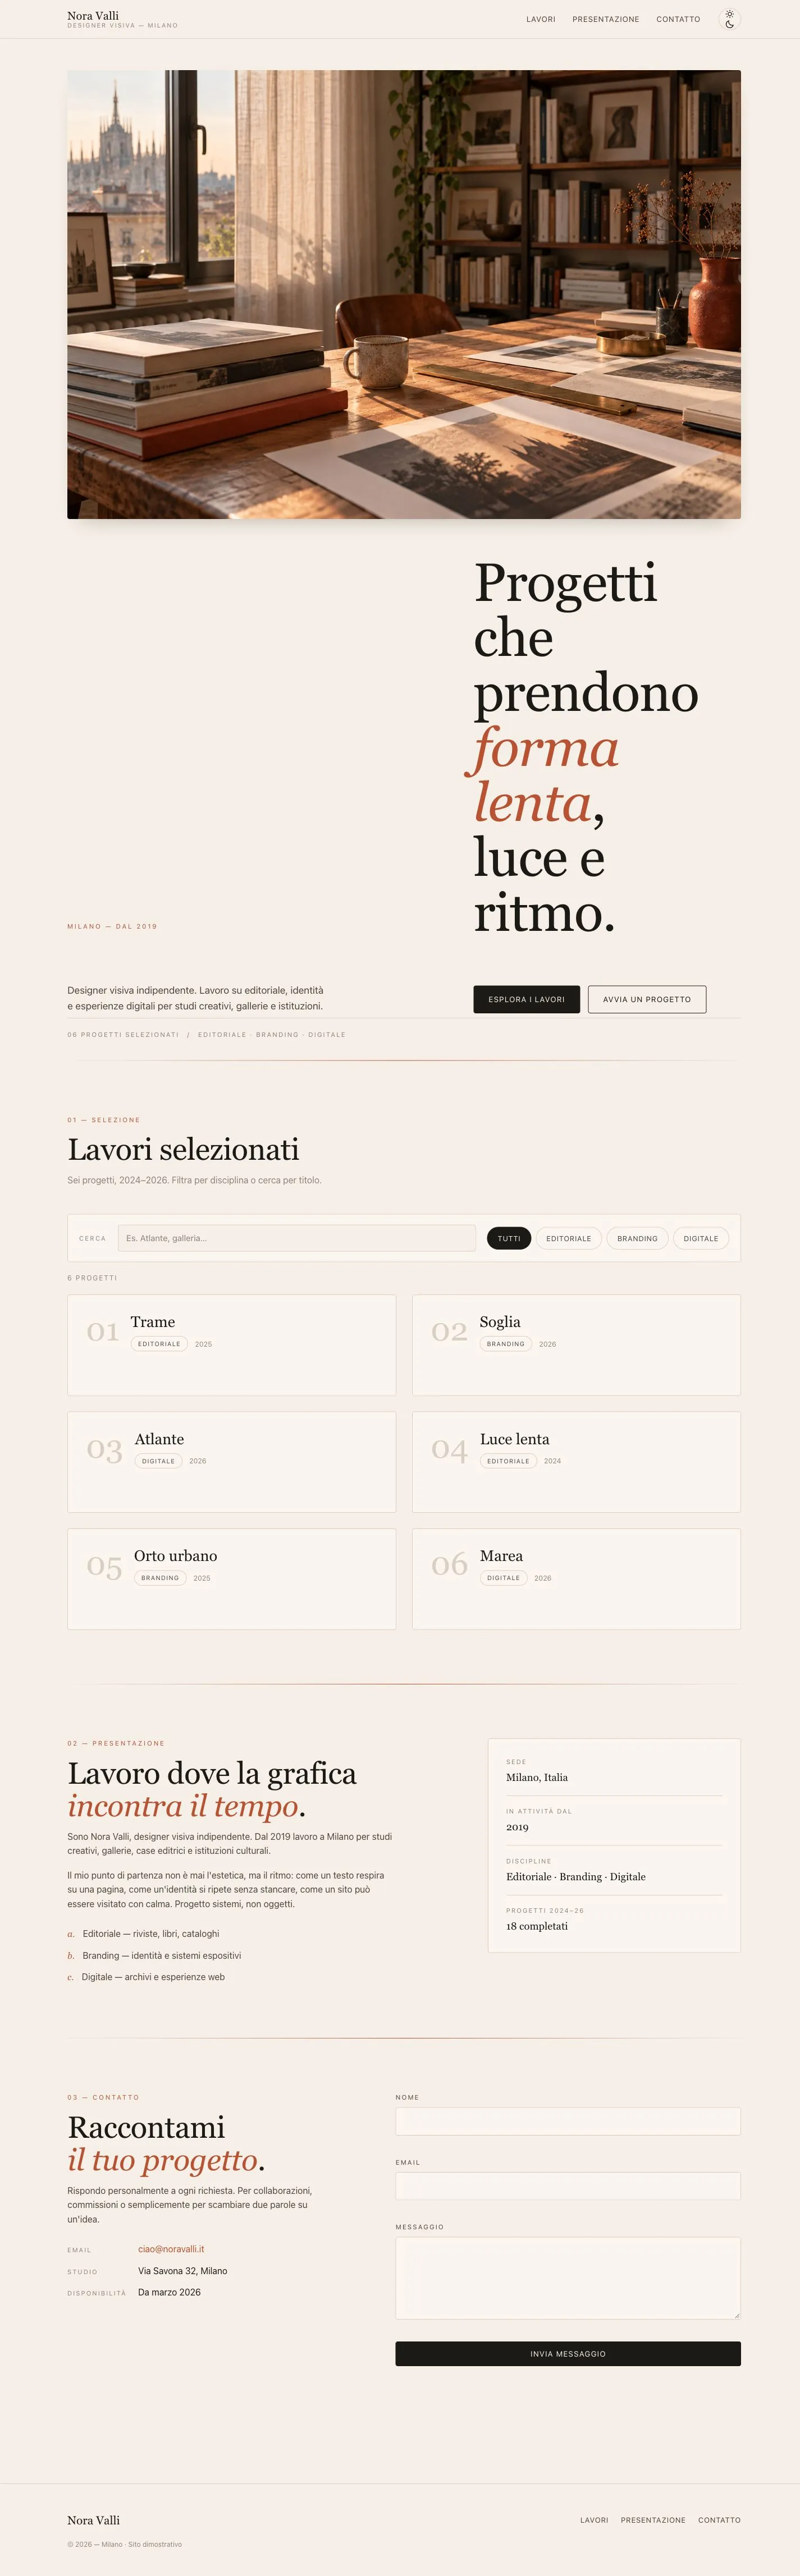
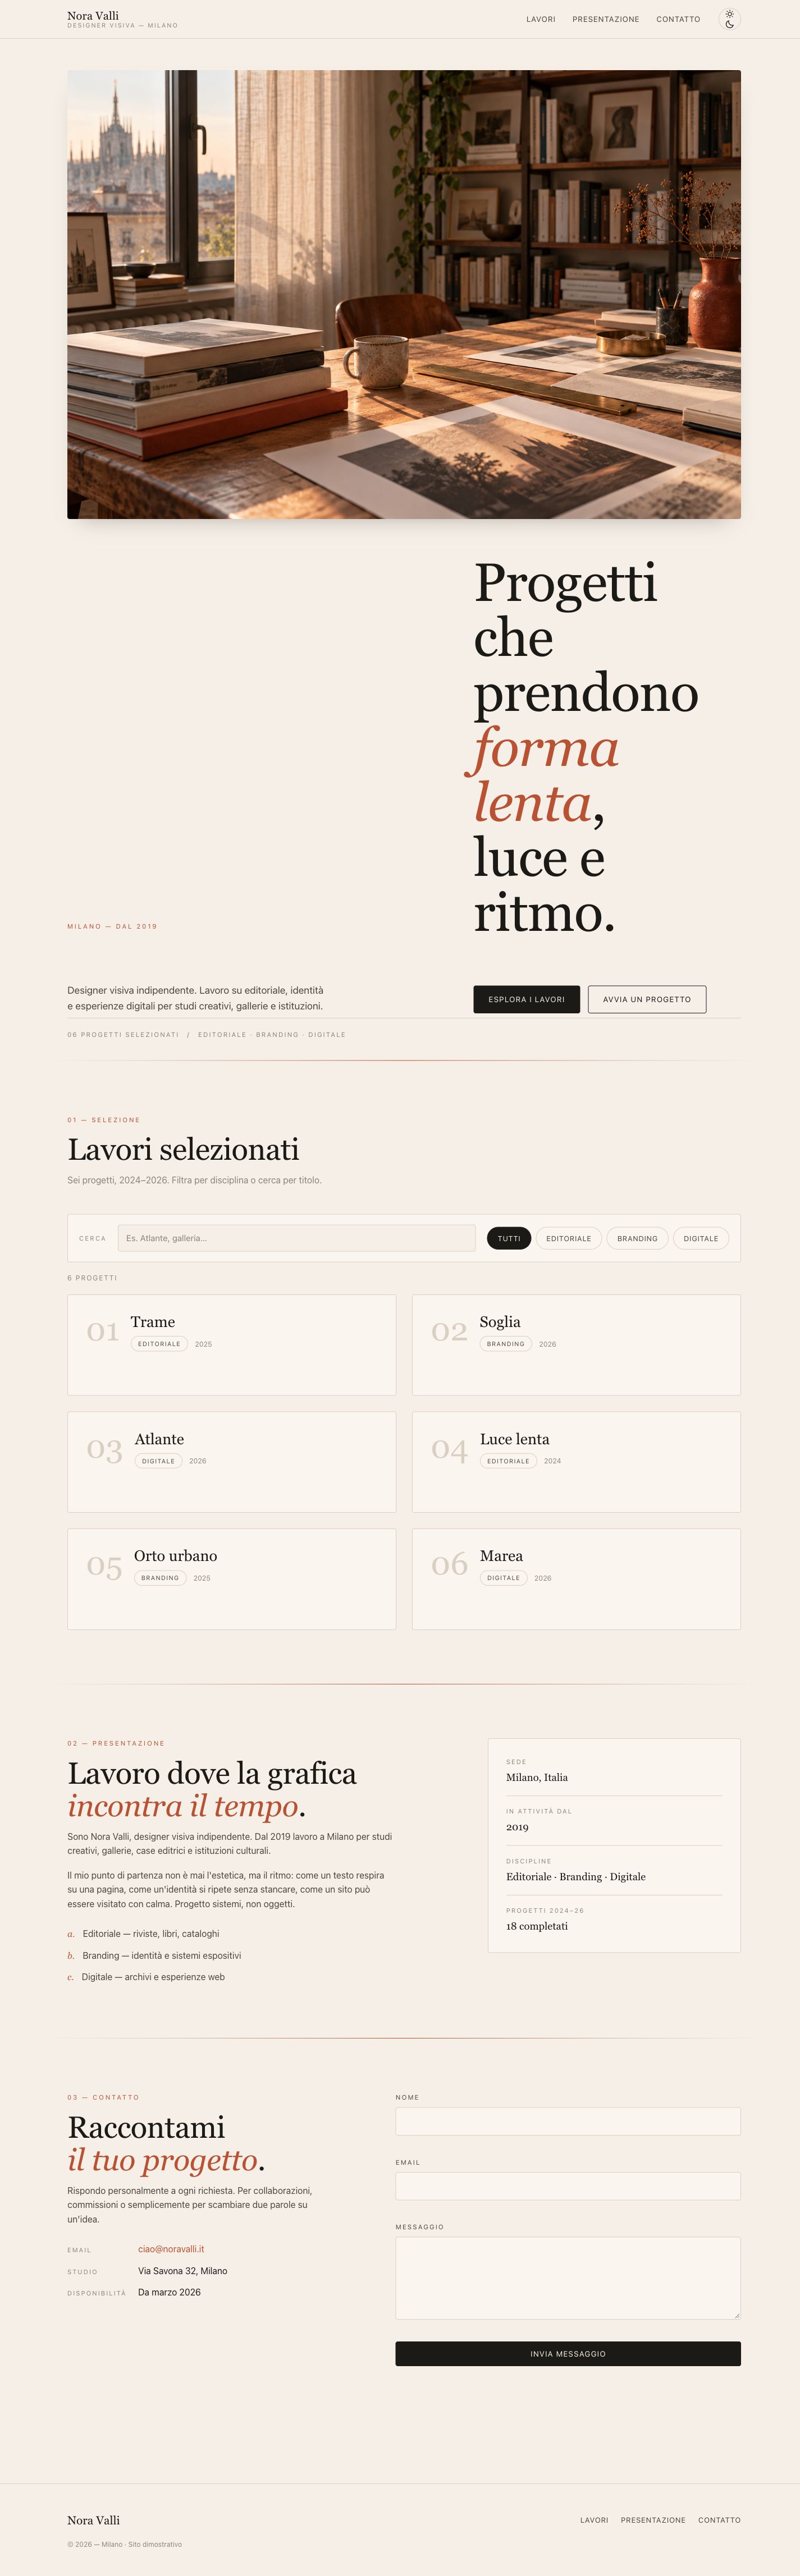
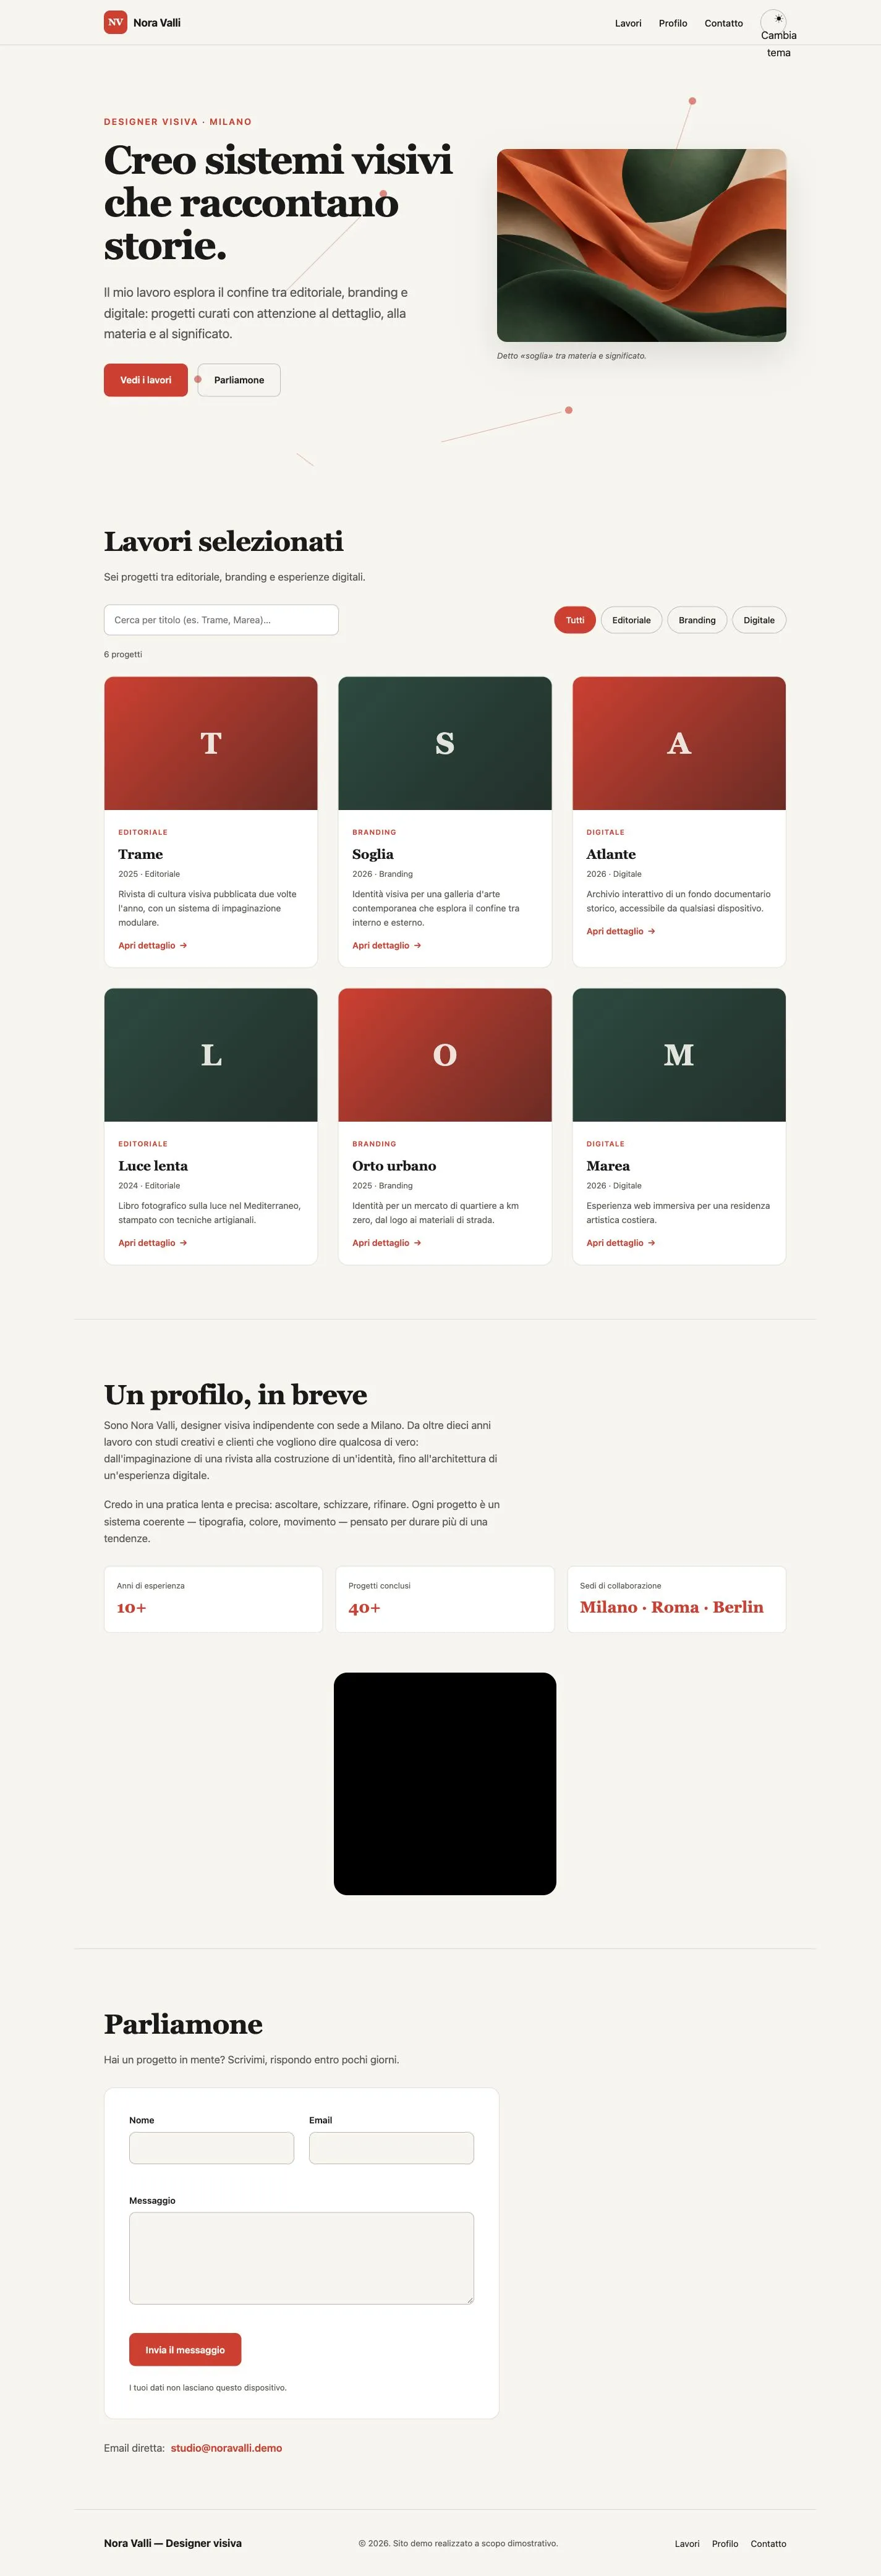
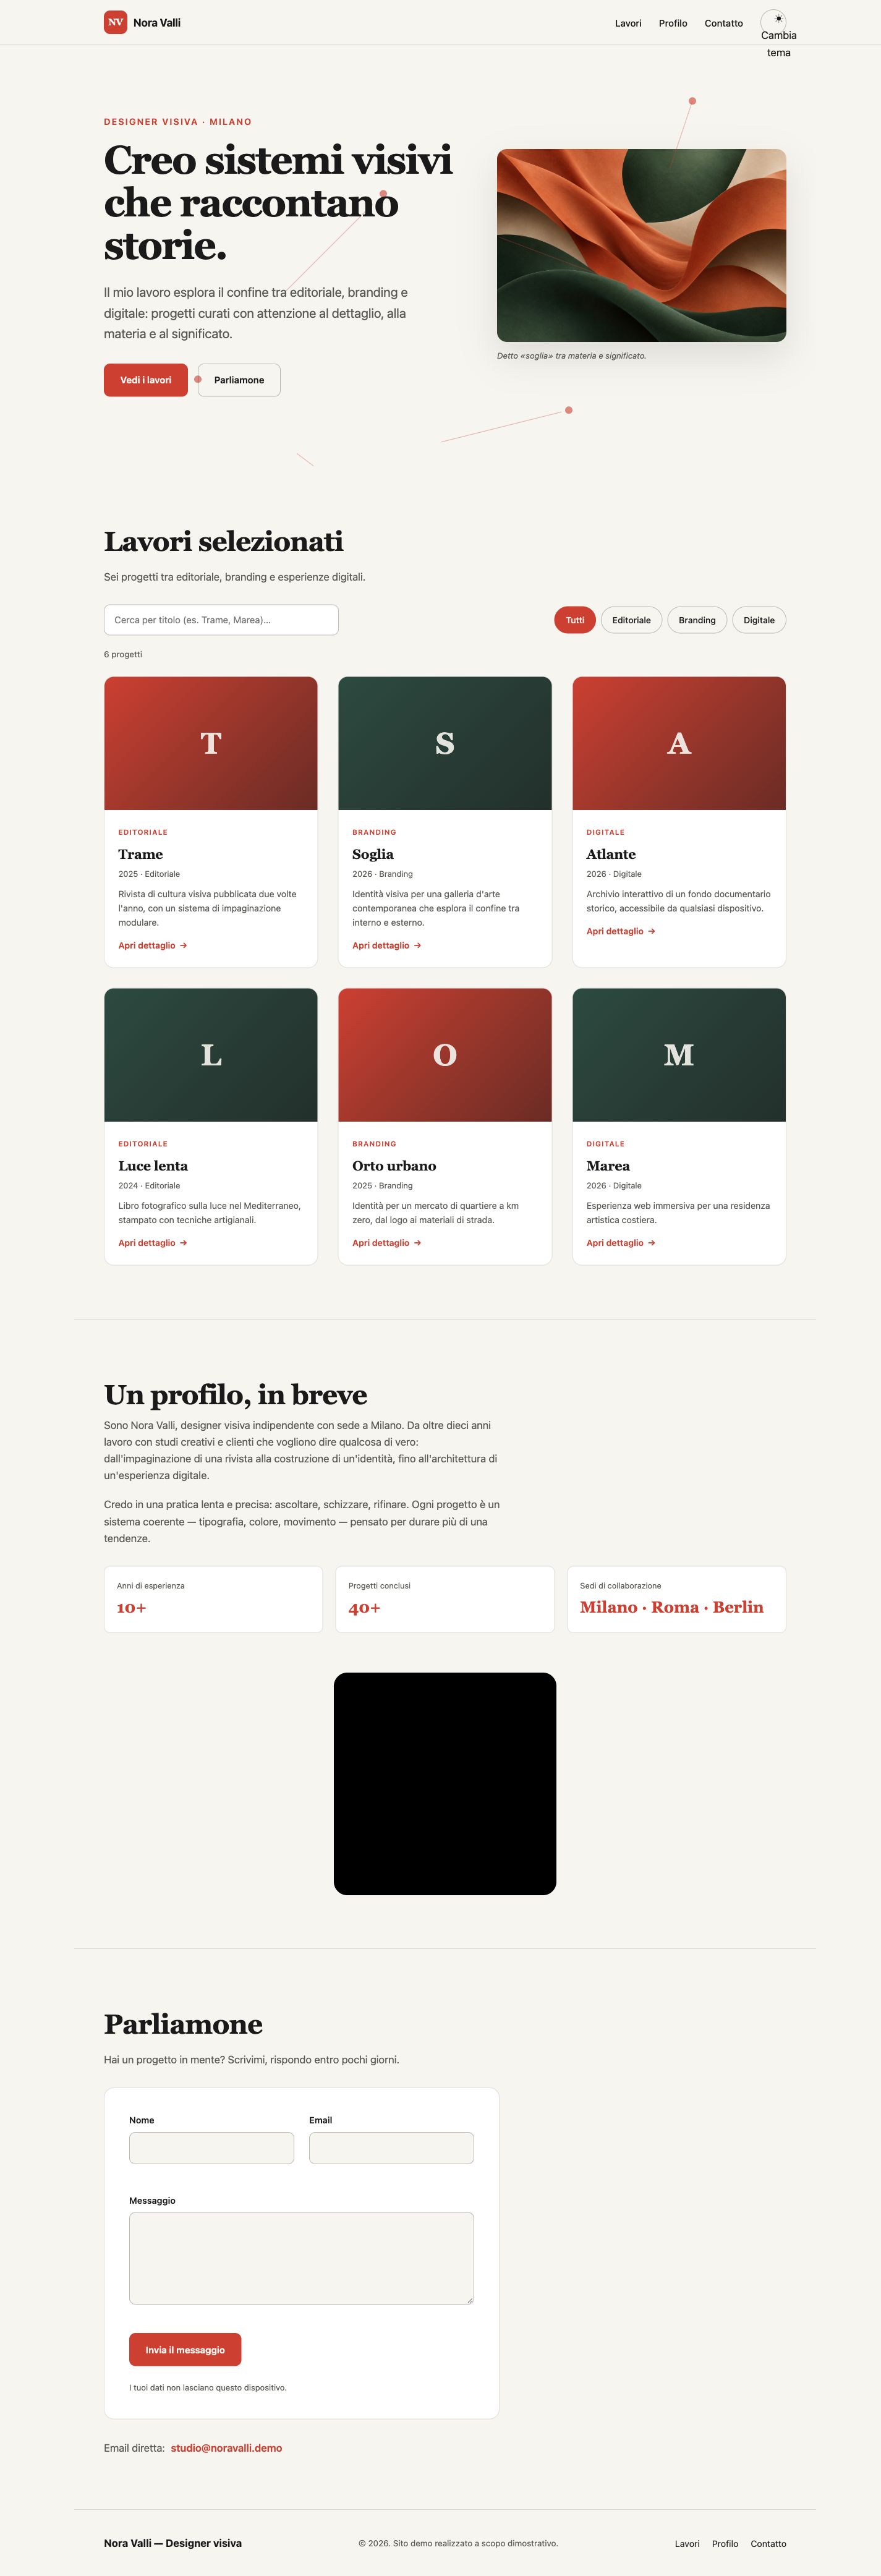
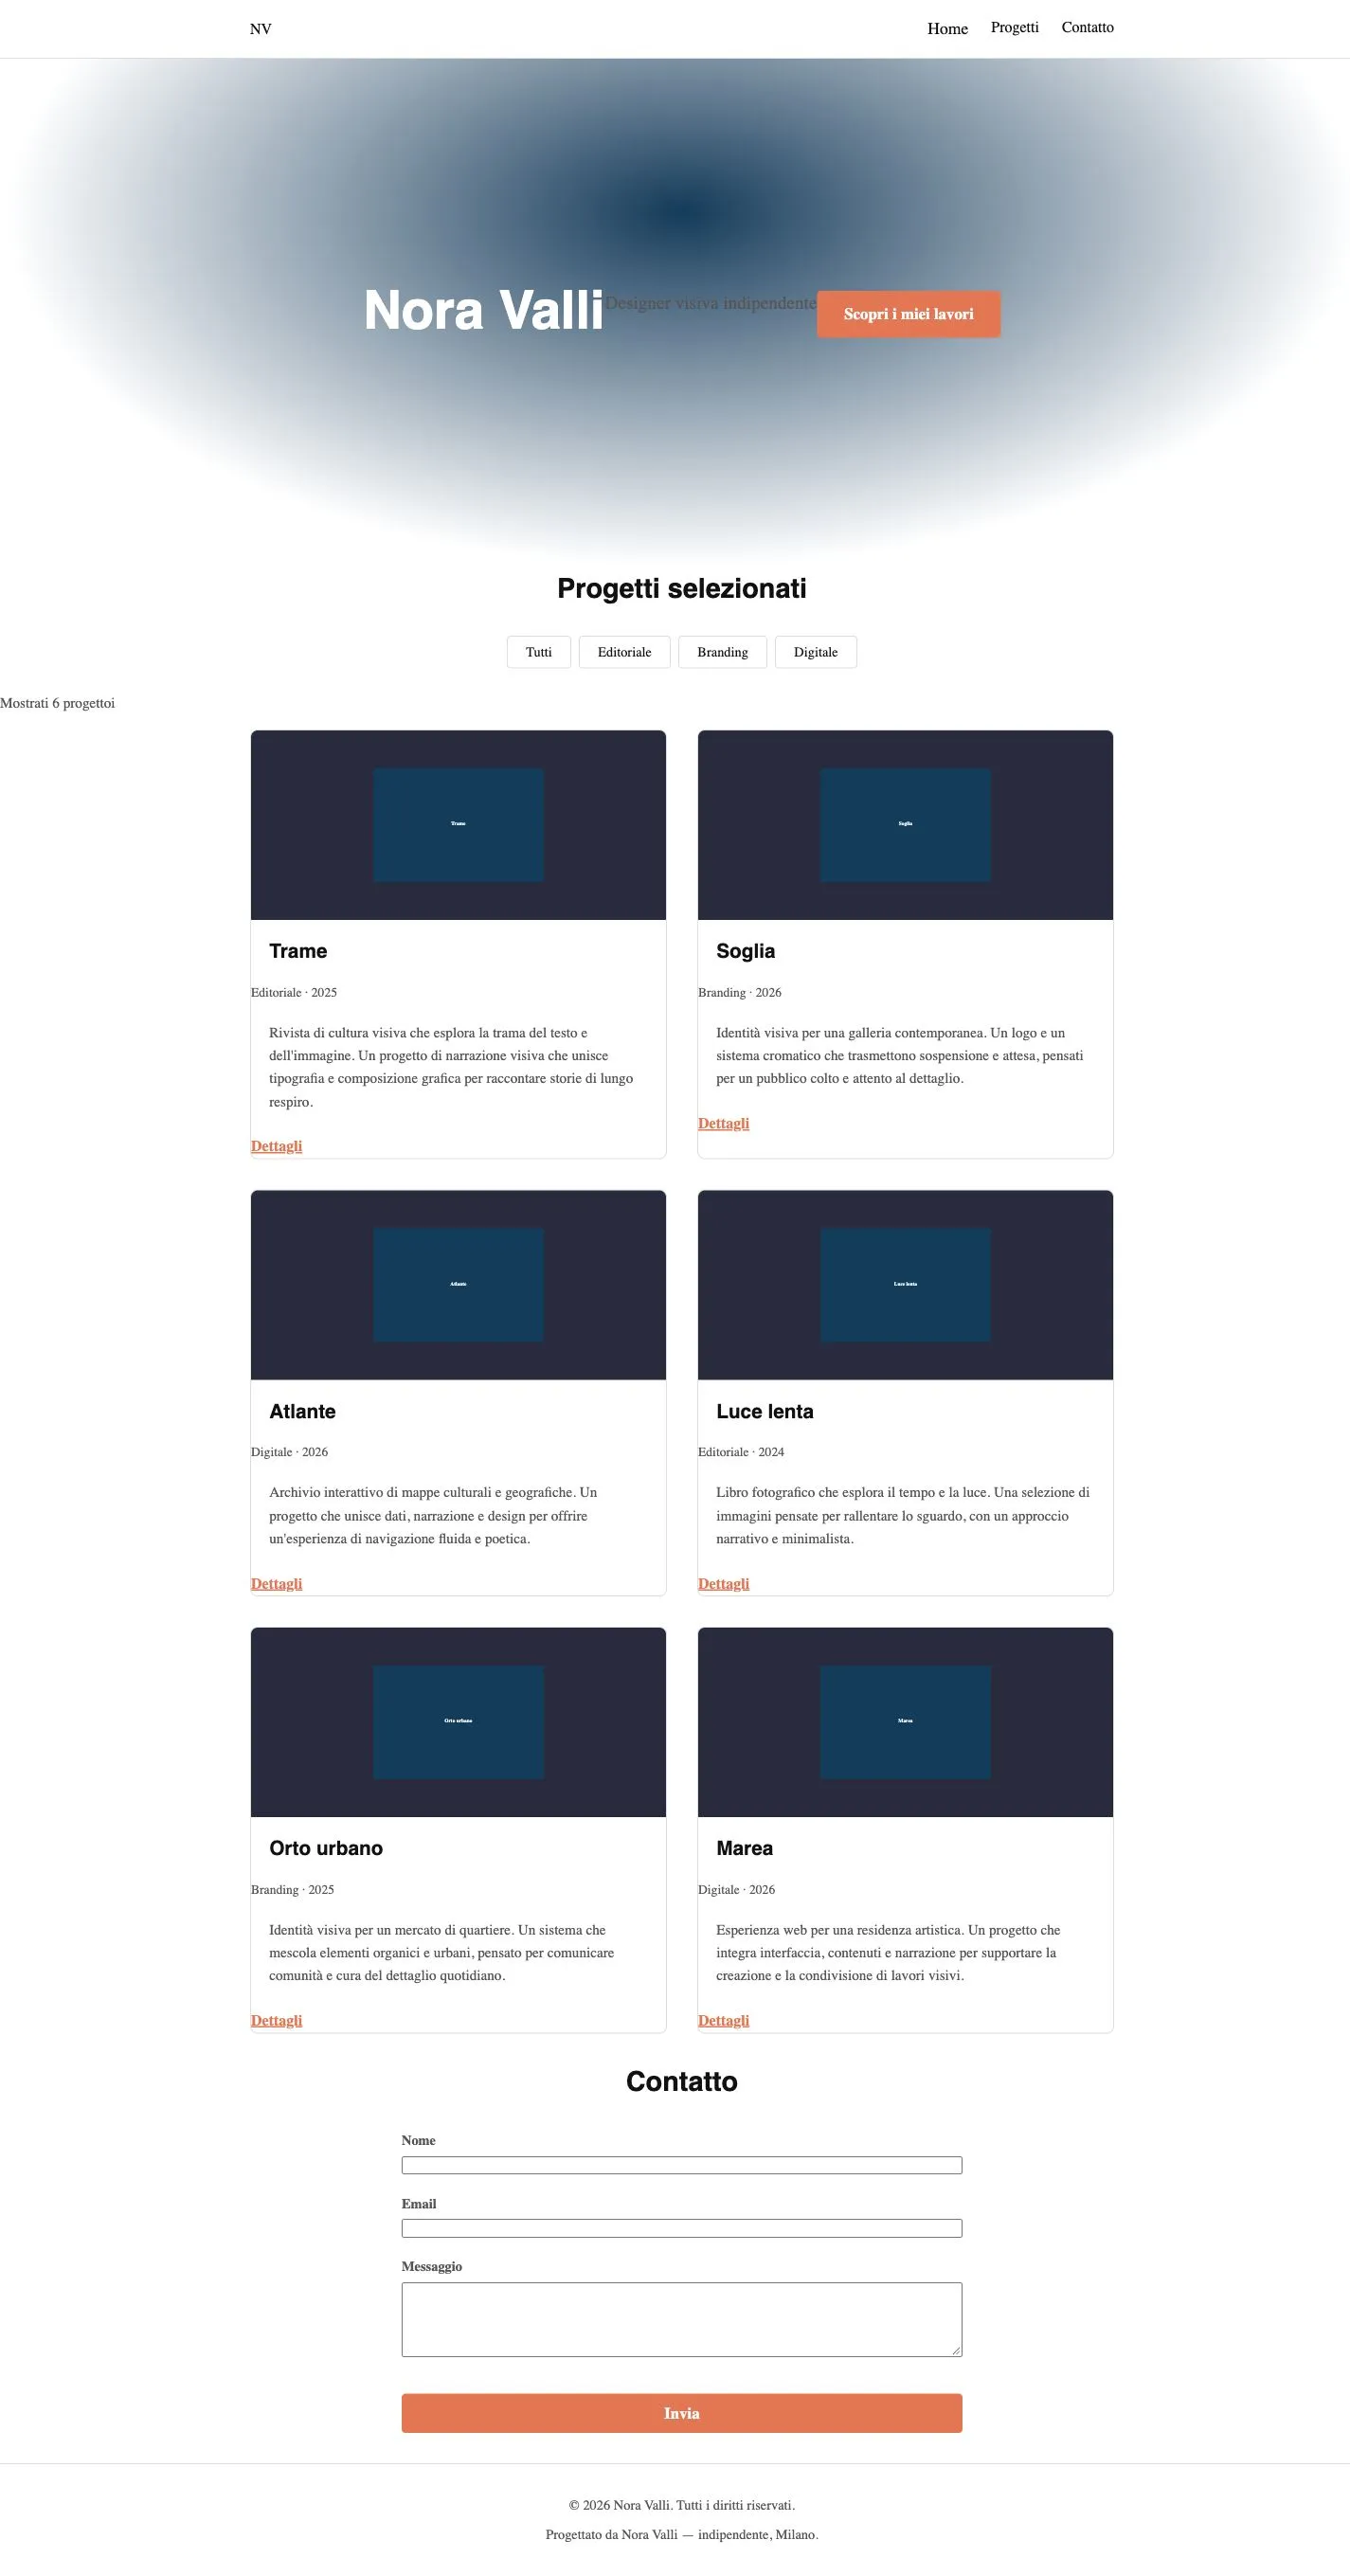
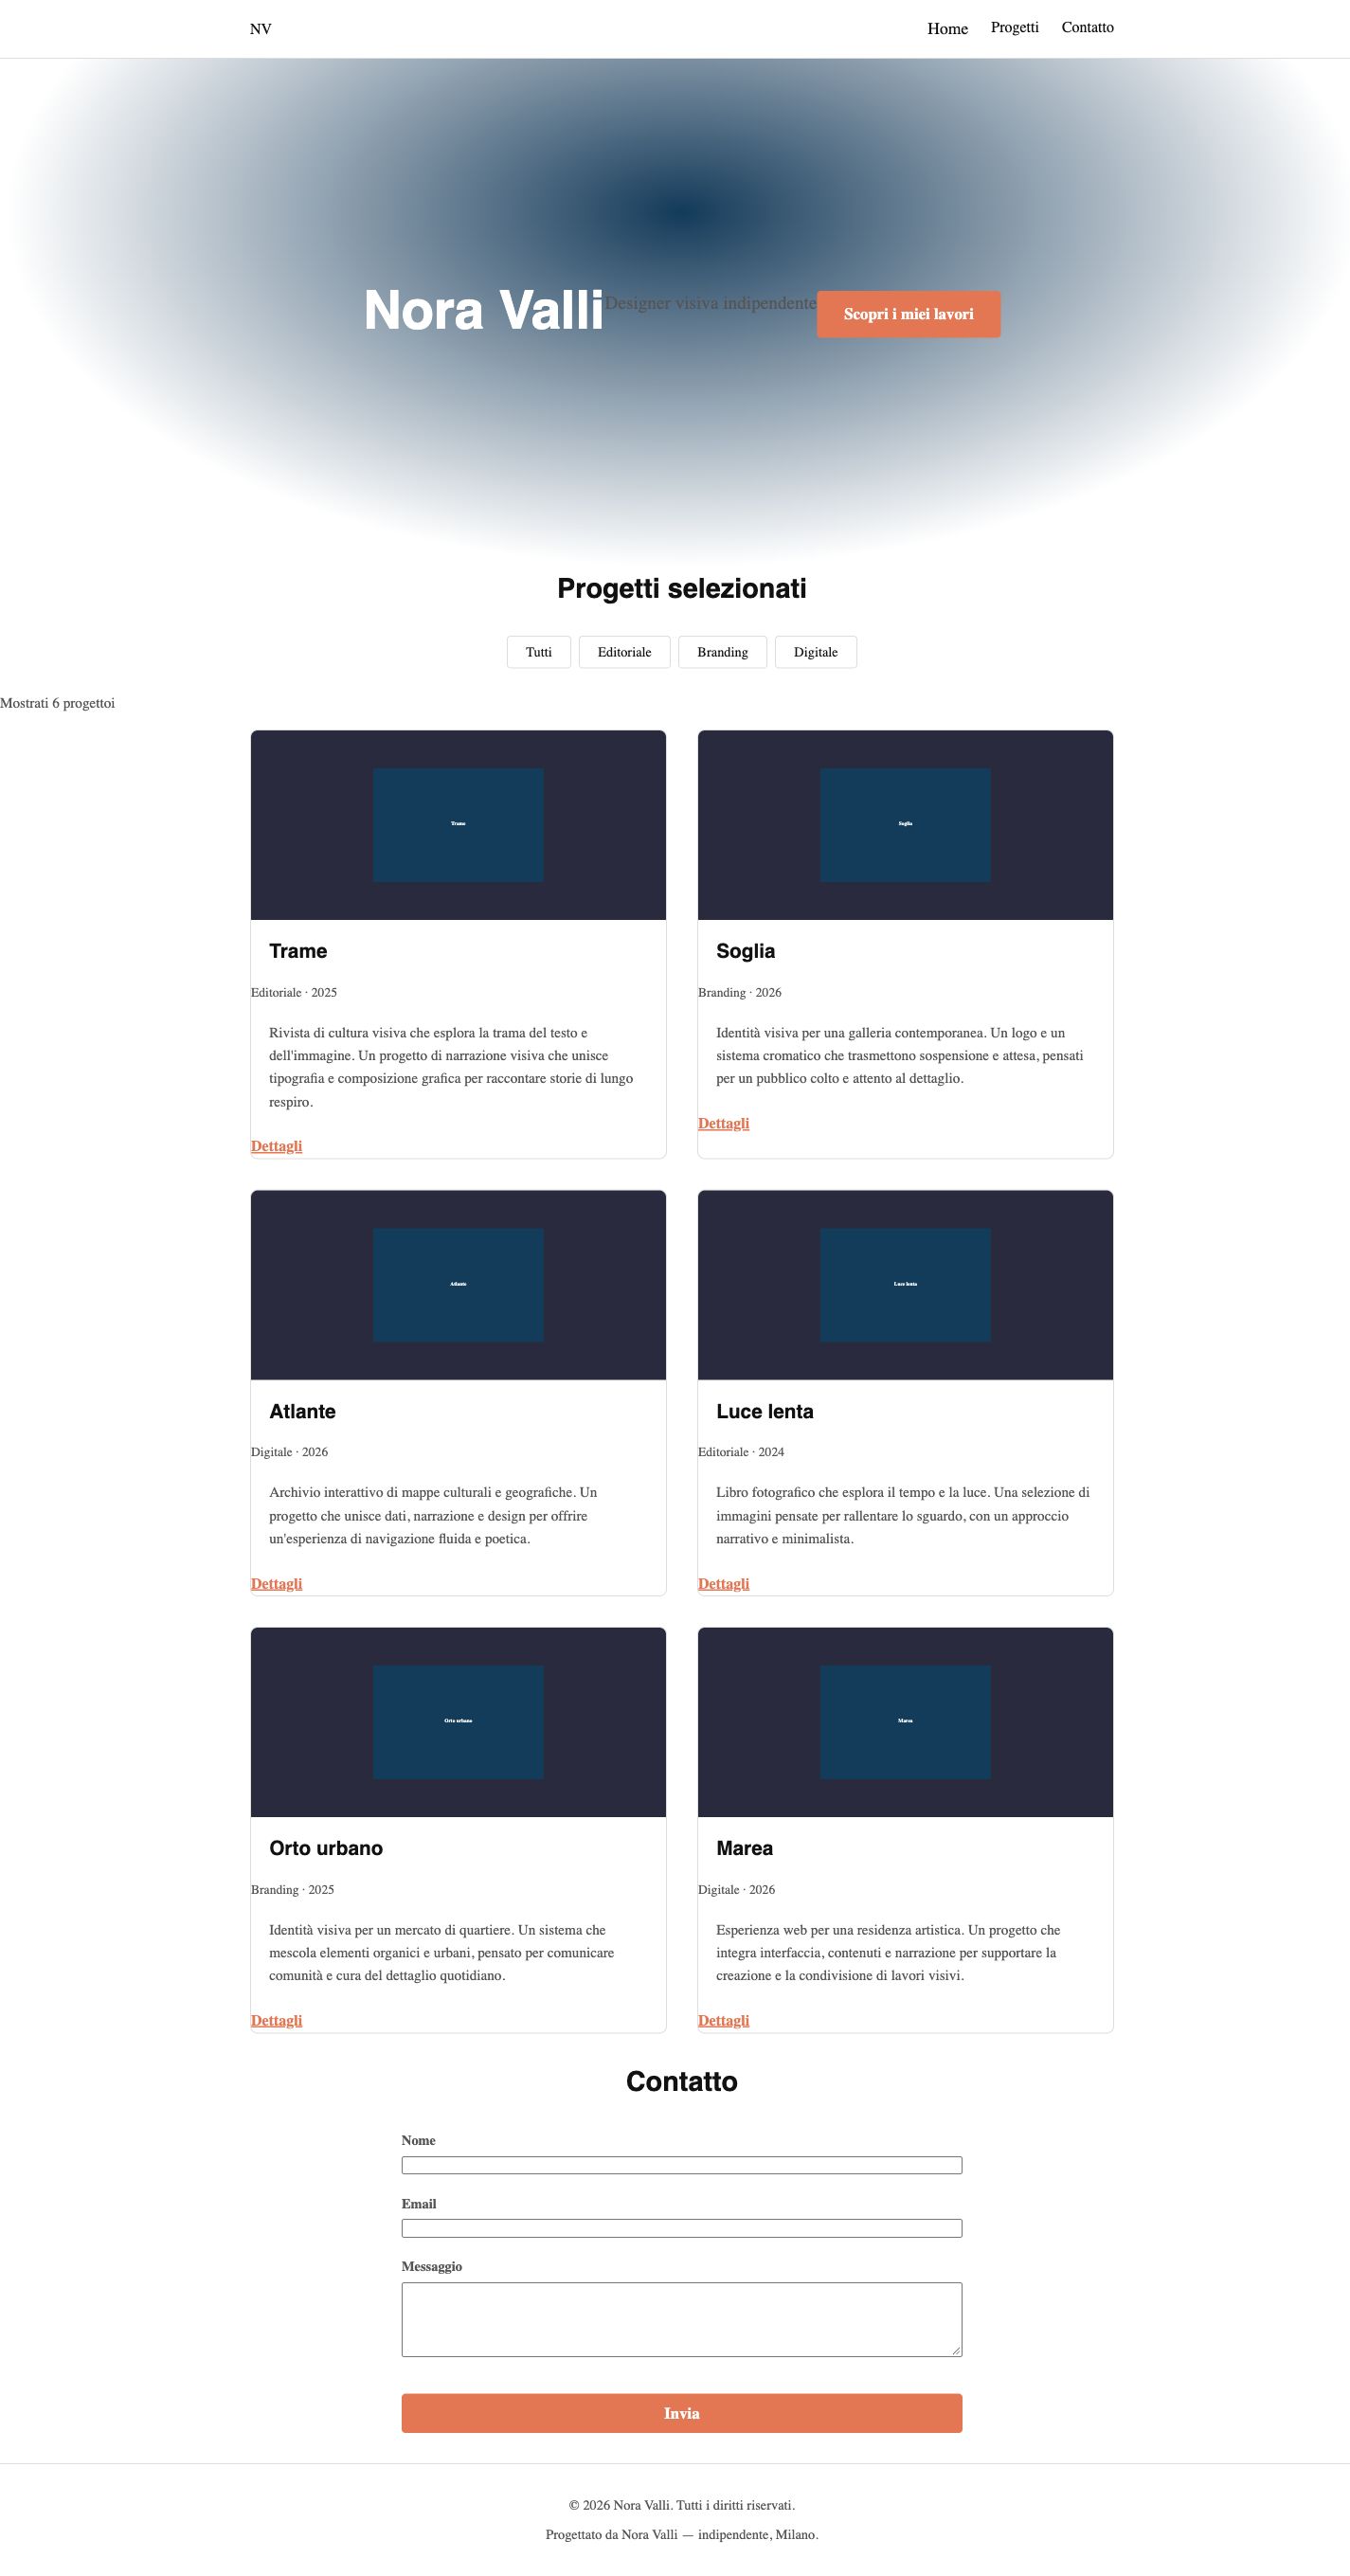
Qwen construye una página clara, con una imagen amplia del estudio, títulos con serifas, cursivas de color tierra y mucho espacio. Ornith coloca título e imagen juntos, usa acentos rojos y verdes y organiza los trabajos en tarjetas con grandes iniciales. LFM presenta una gran franja azul degradada, con una relación poco resuelta entre título, texto y control principal. El archivo generado existe, pero no está integrado en la versión inicial; aparecerá durante las correcciones.
Mi orden de preferencia es Qwen, después Ornith y después LFM. Es un juicio personal declarado, posterior a la prueba. Para observar sus posibles razones conviene comparar proporciones, jerarquías e integración de la imagen; el número de comprobaciones superadas responde a otra pregunta.
Todas las capturas siguientes son reproducciones editoriales posteriores de los artefactos conservados, sin modificarlos ni ejecutar nuevas inferencias. La baseline es la primera versión, también llamada iteración 0. El viewport de escritorio es 1440×900; la captura de página completa puede superar los 900 píxeles de alto. Cada imagen enlaza con su original ampliable.
Detrás de una buena primera impresión
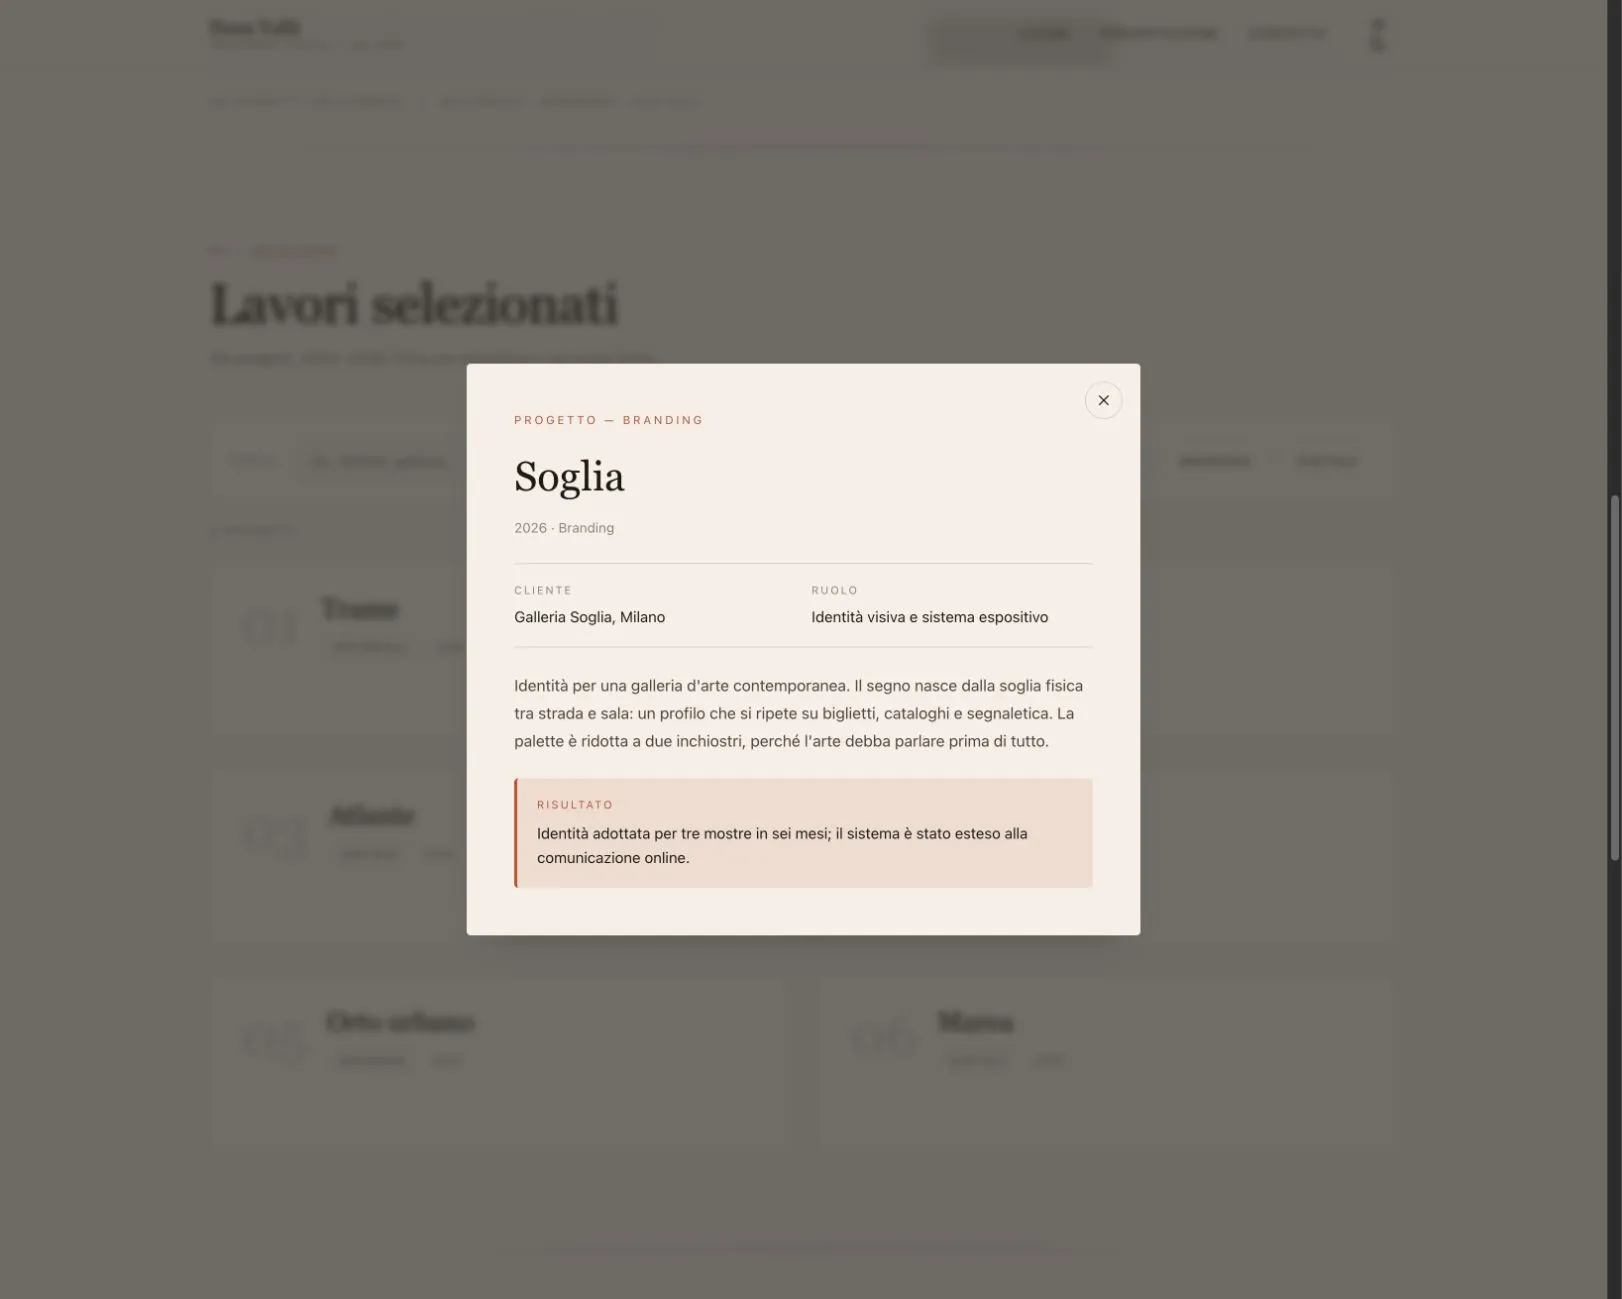
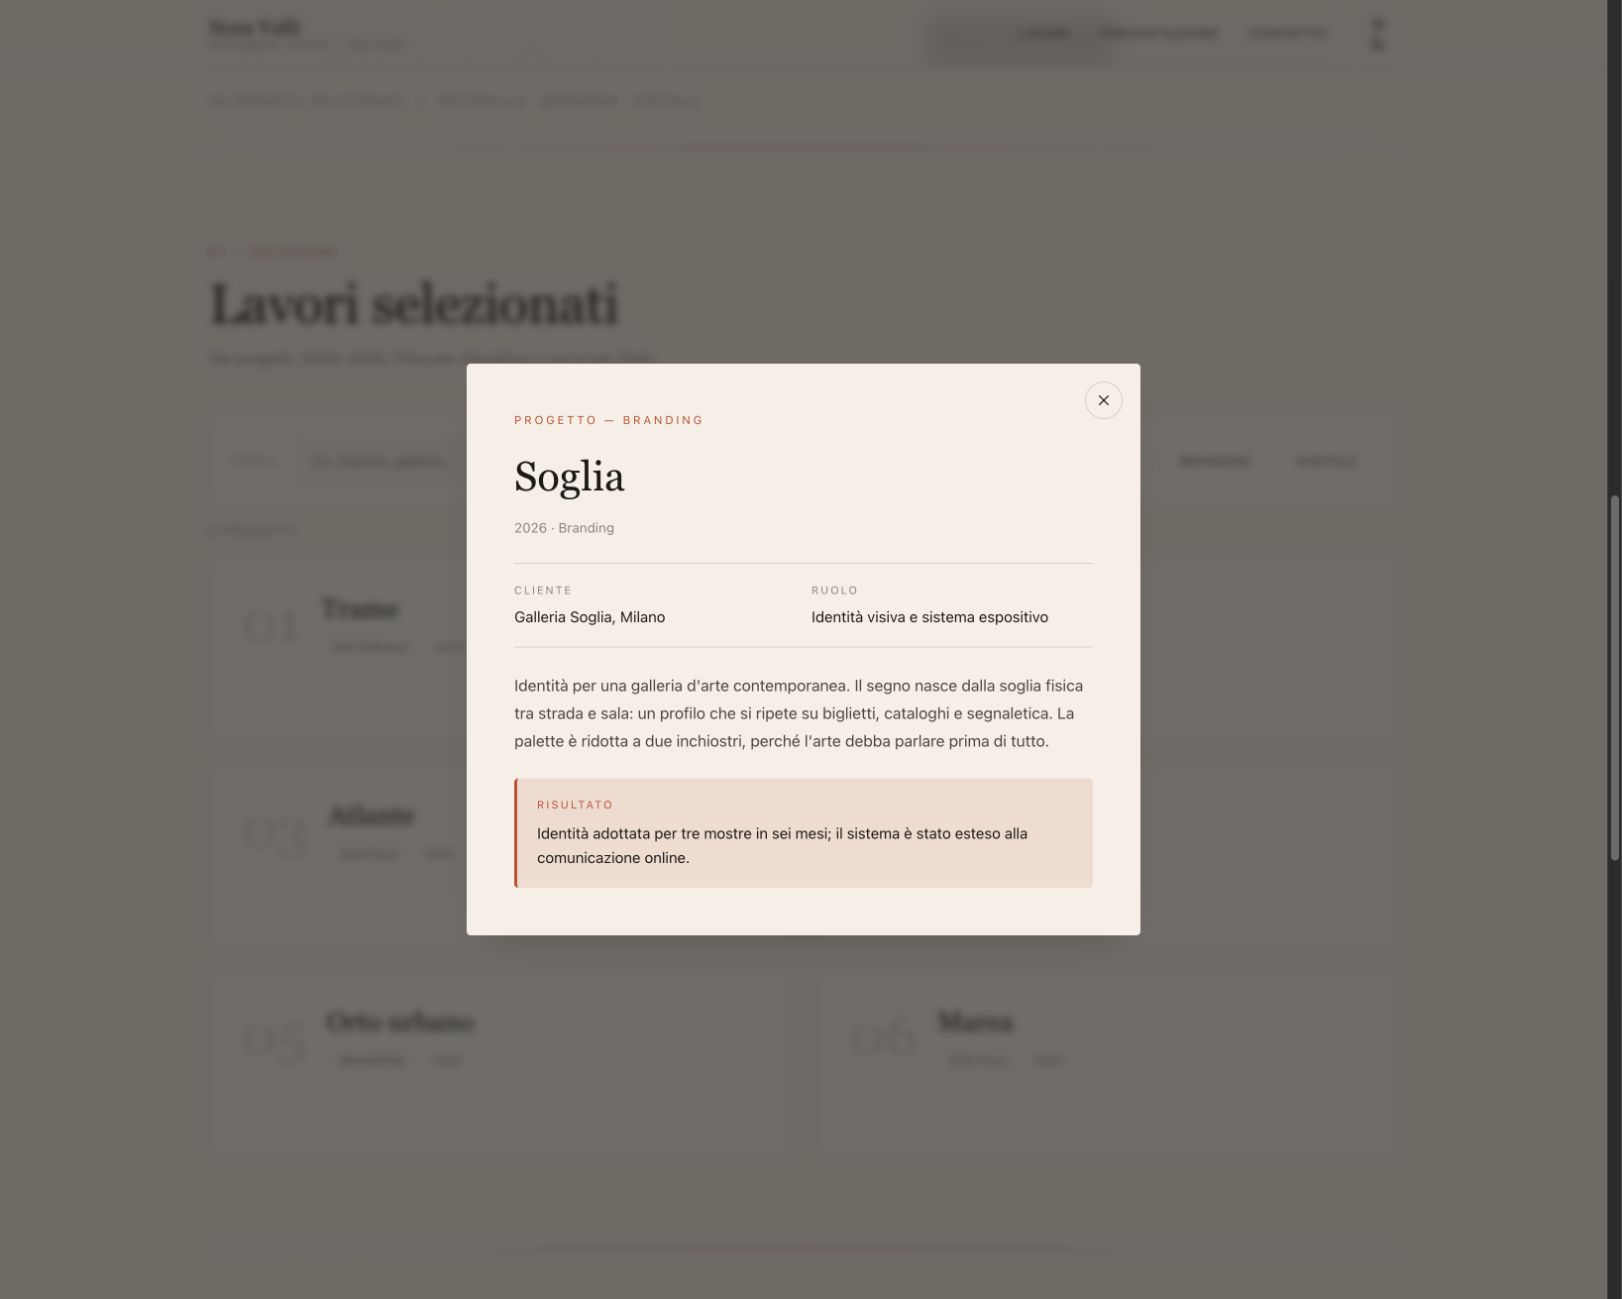
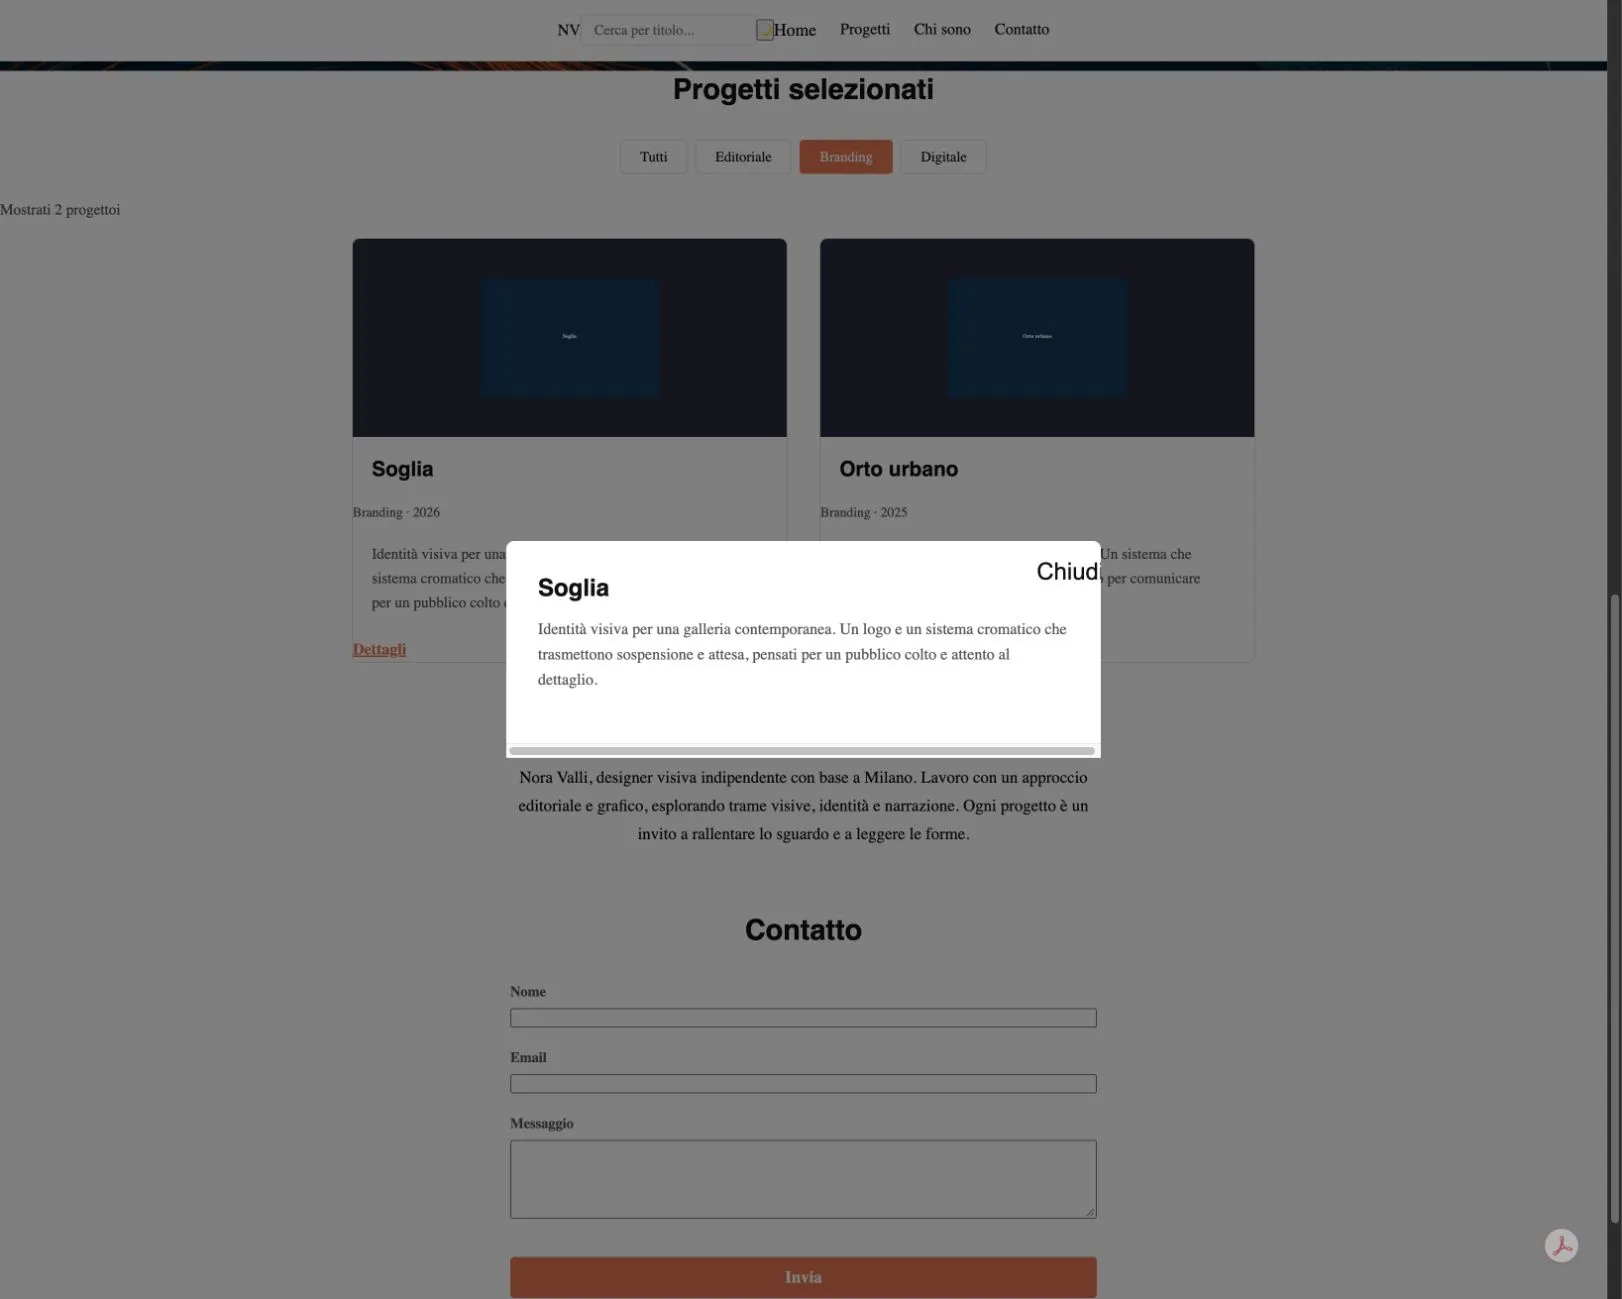
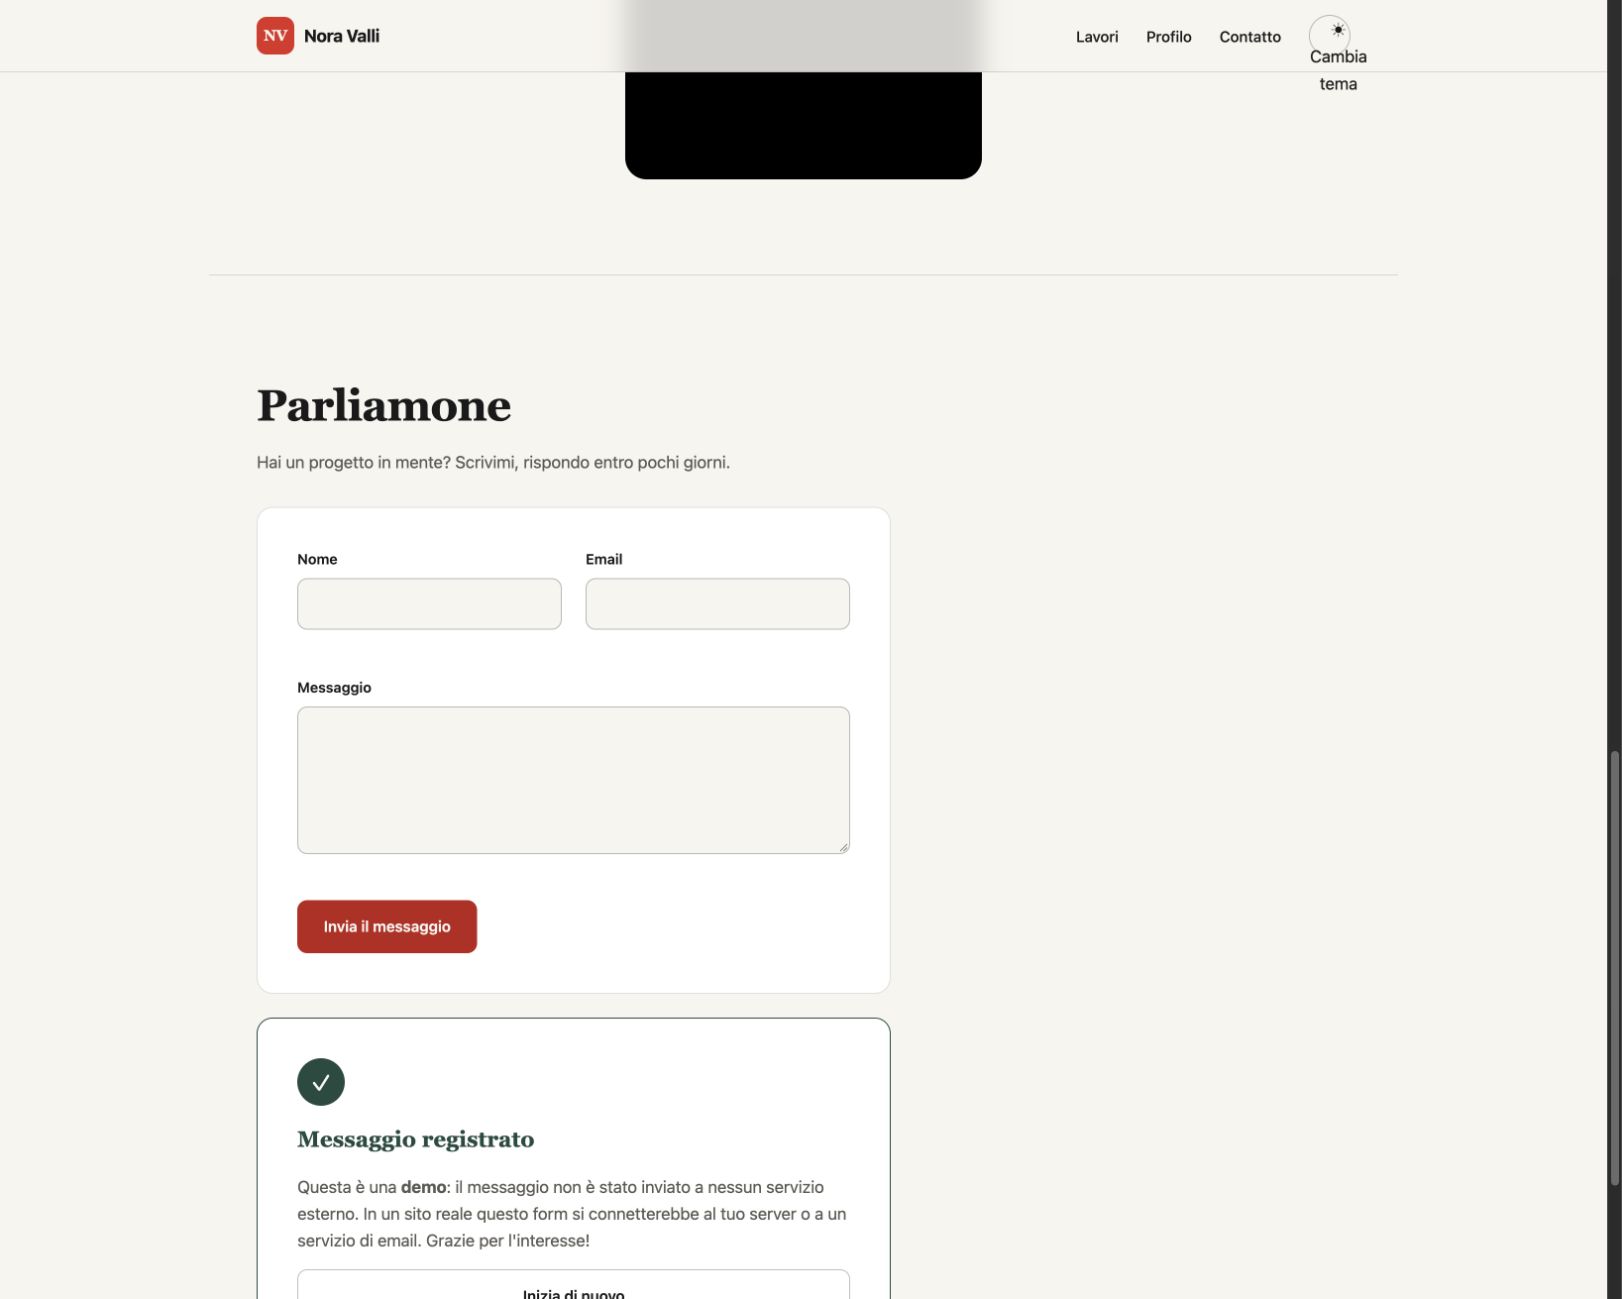
Qwen partía de nueve comprobaciones completas y una parcial. El problema estaba en los detalles de los proyectos: cuatro de seis diálogos no funcionaban. Pulsar Soglia dejaba la página a la vista sin abrir el contenido solicitado.
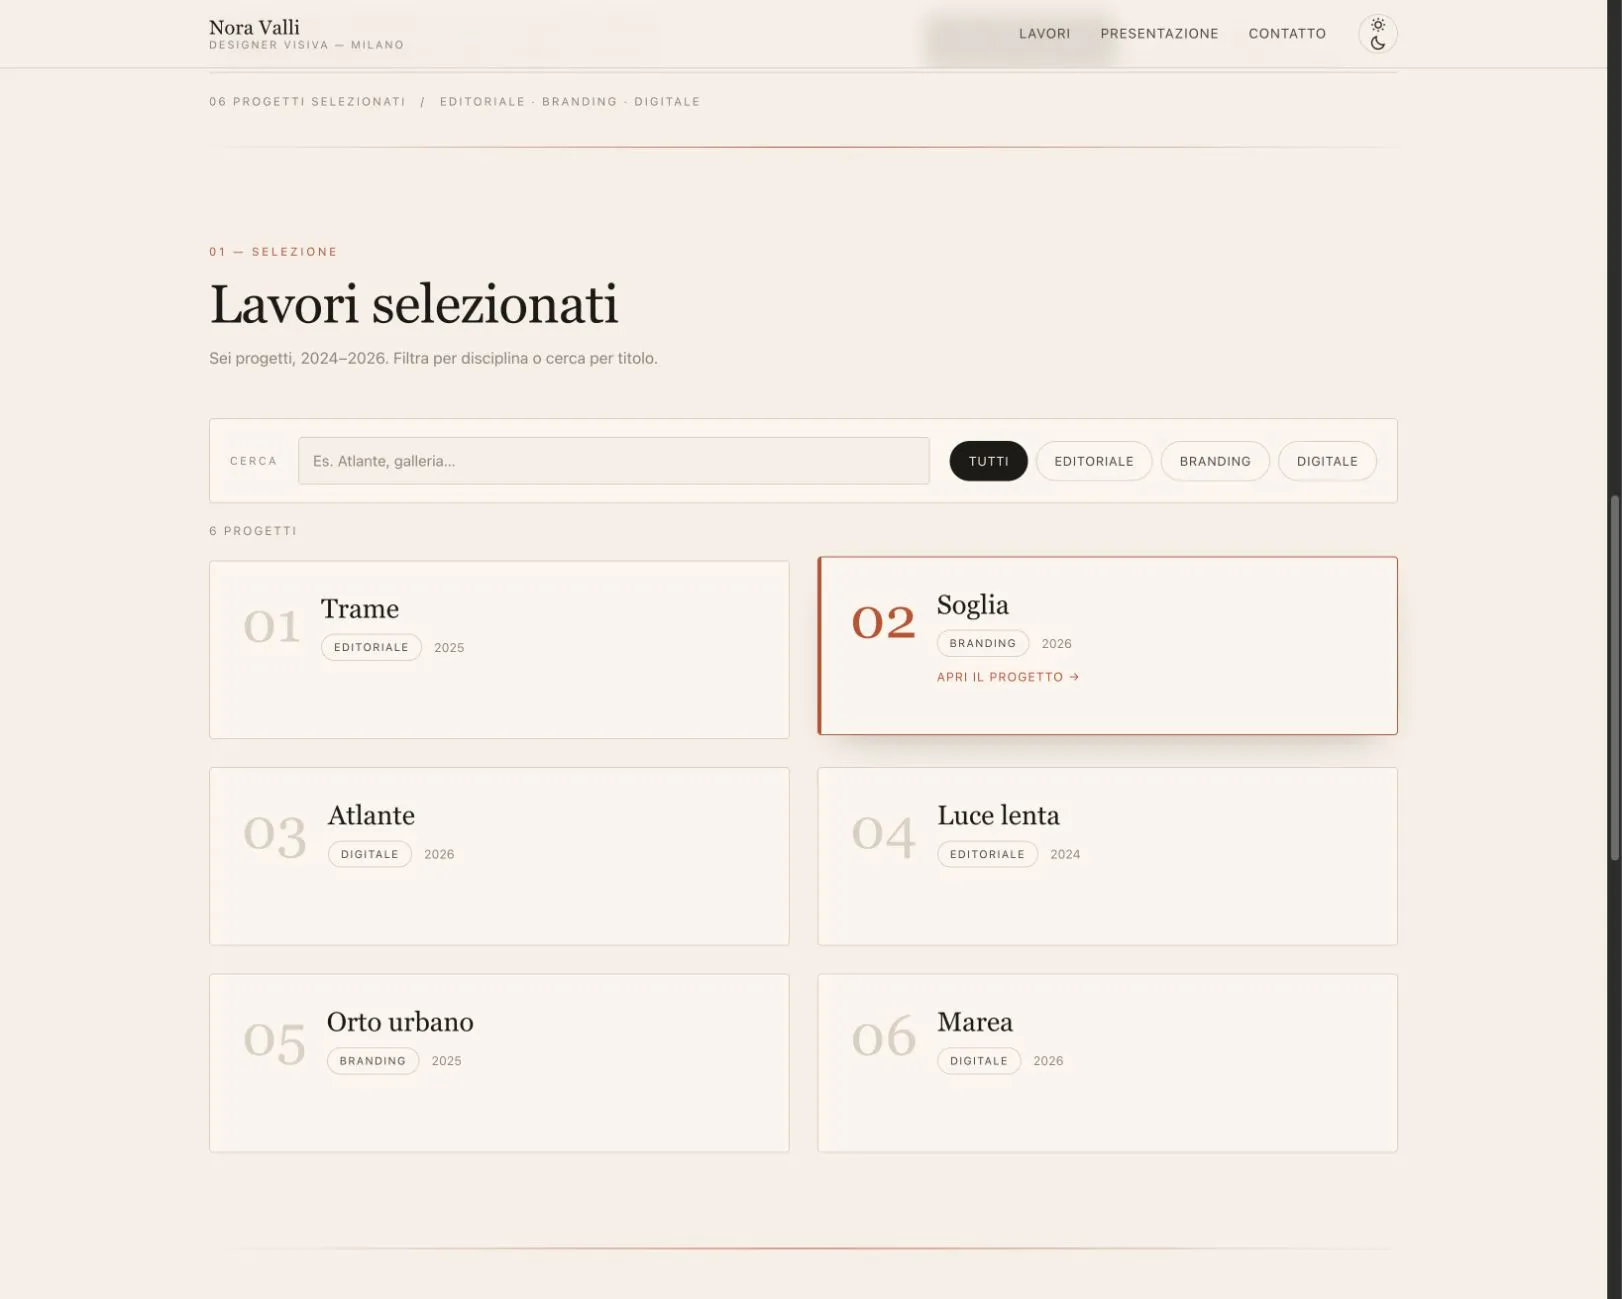
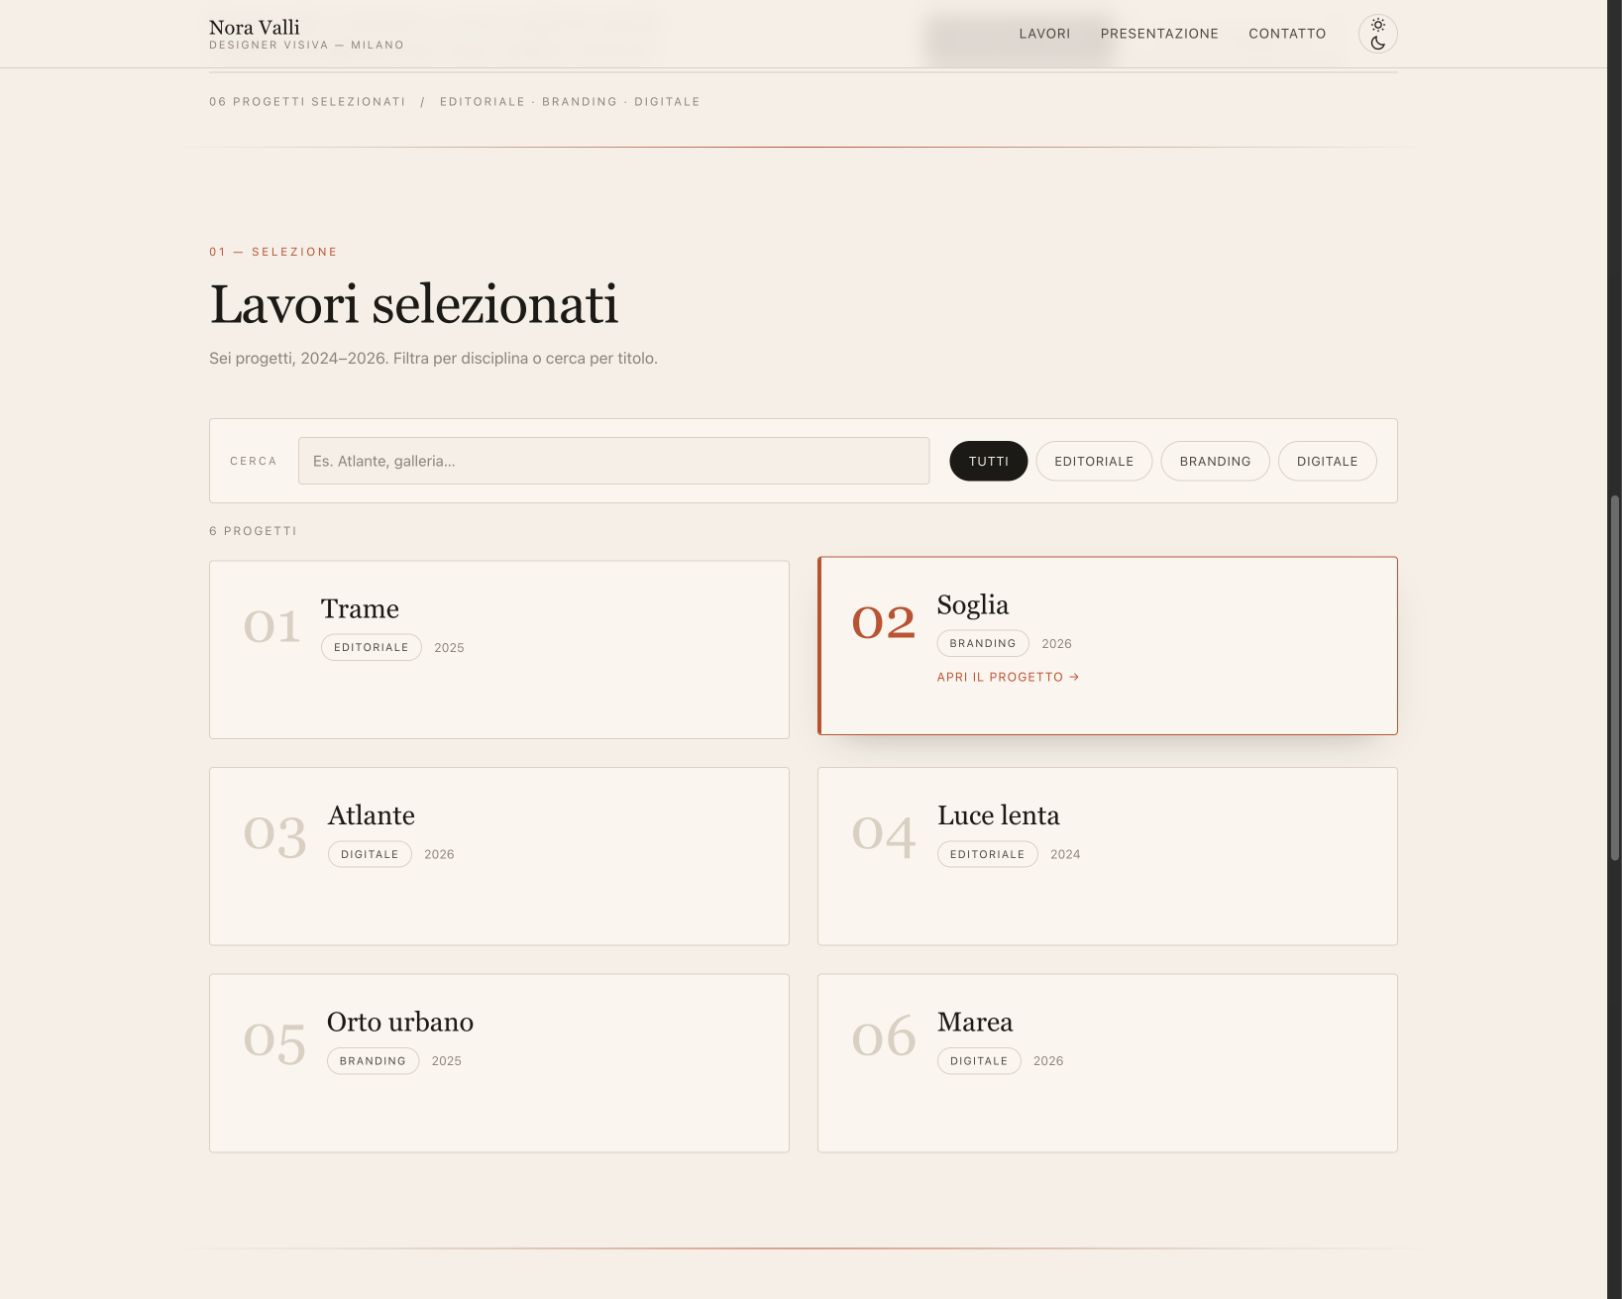
Tras dos iteraciones adicionales, la misma acción abre un detalle con título, año, función y descripción. La solución incorpora un fallback JavaScript: recupera los datos incluso cuando los atributos HTML originales que contienen JSON están truncados. El comportamiento requerido pasa; el marcado mal formado sigue pendiente antes de un uso real.
Ornith partía de ocho comprobaciones completas. El filtro Branding cambiaba de aspecto, pero mantenía visibles los seis trabajos. El control comunicaba una selección que la colección no respetaba.
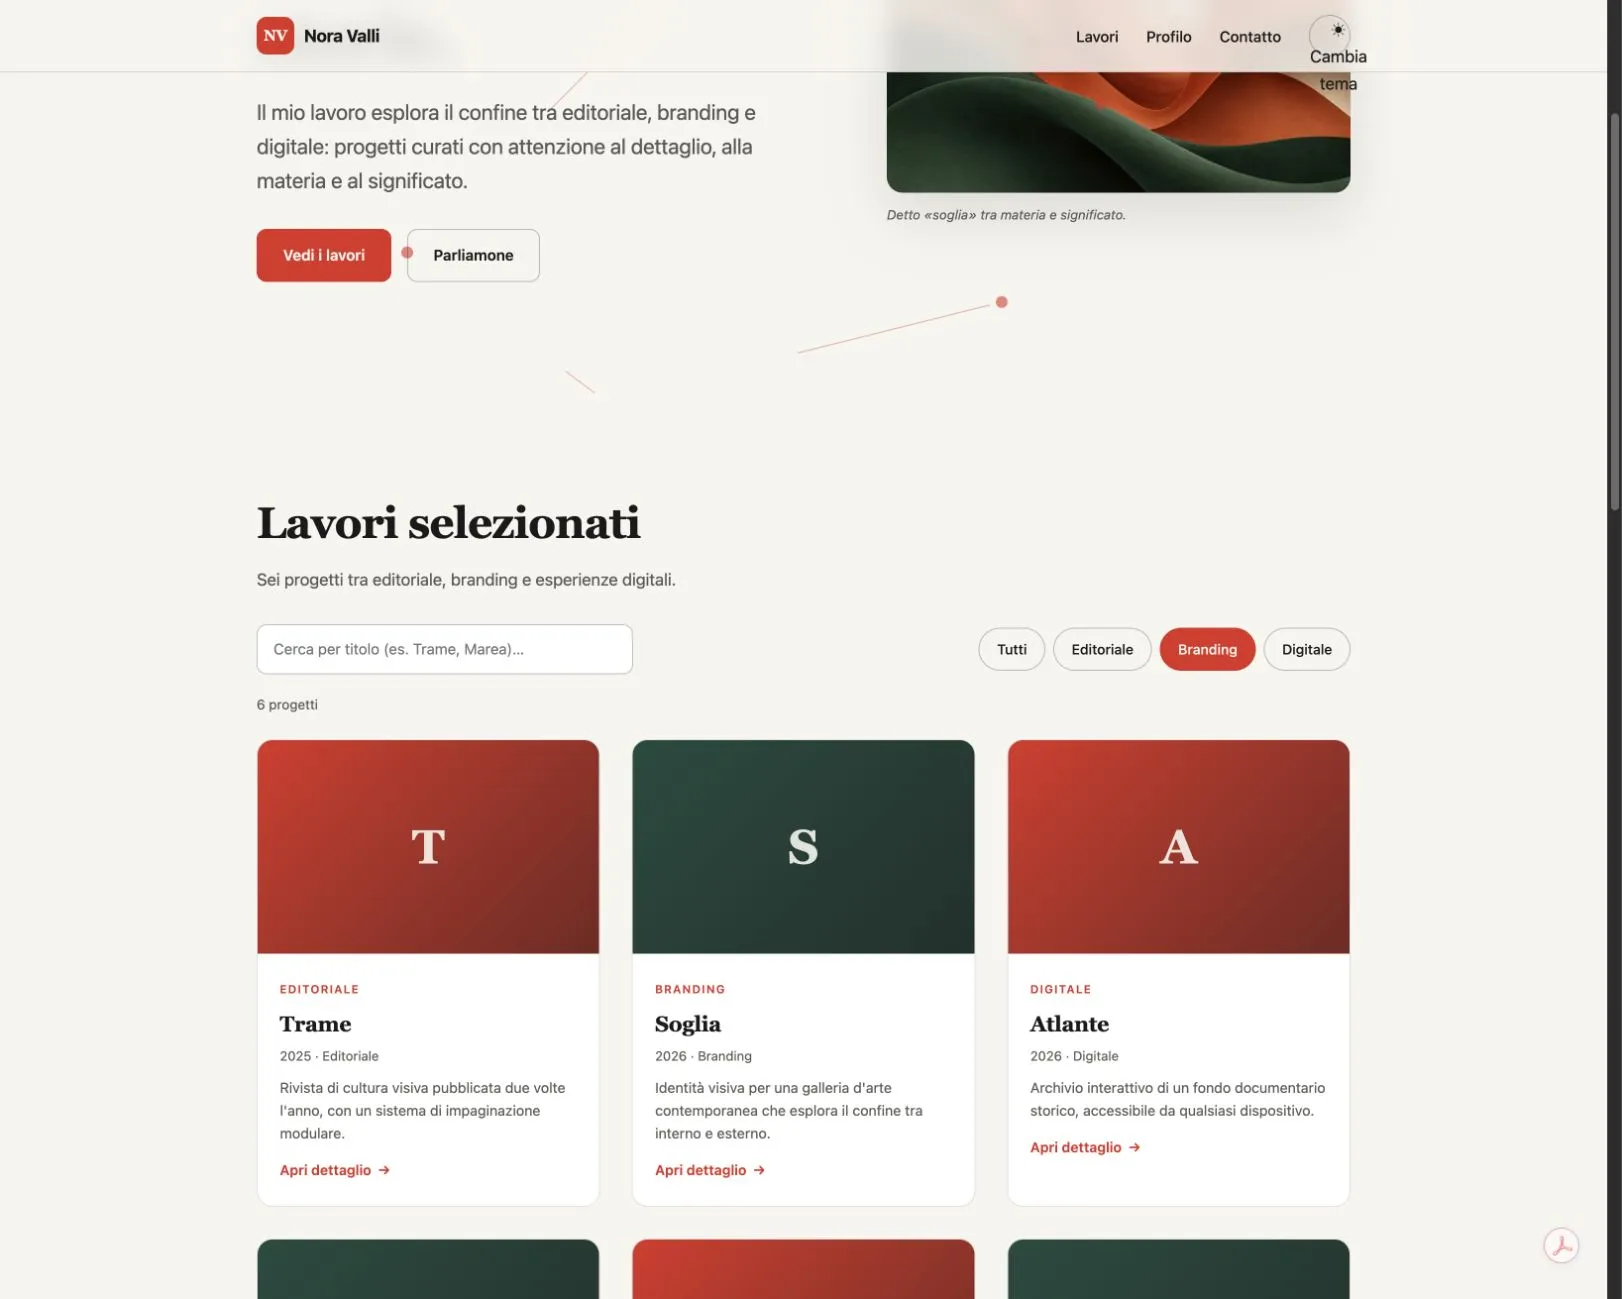
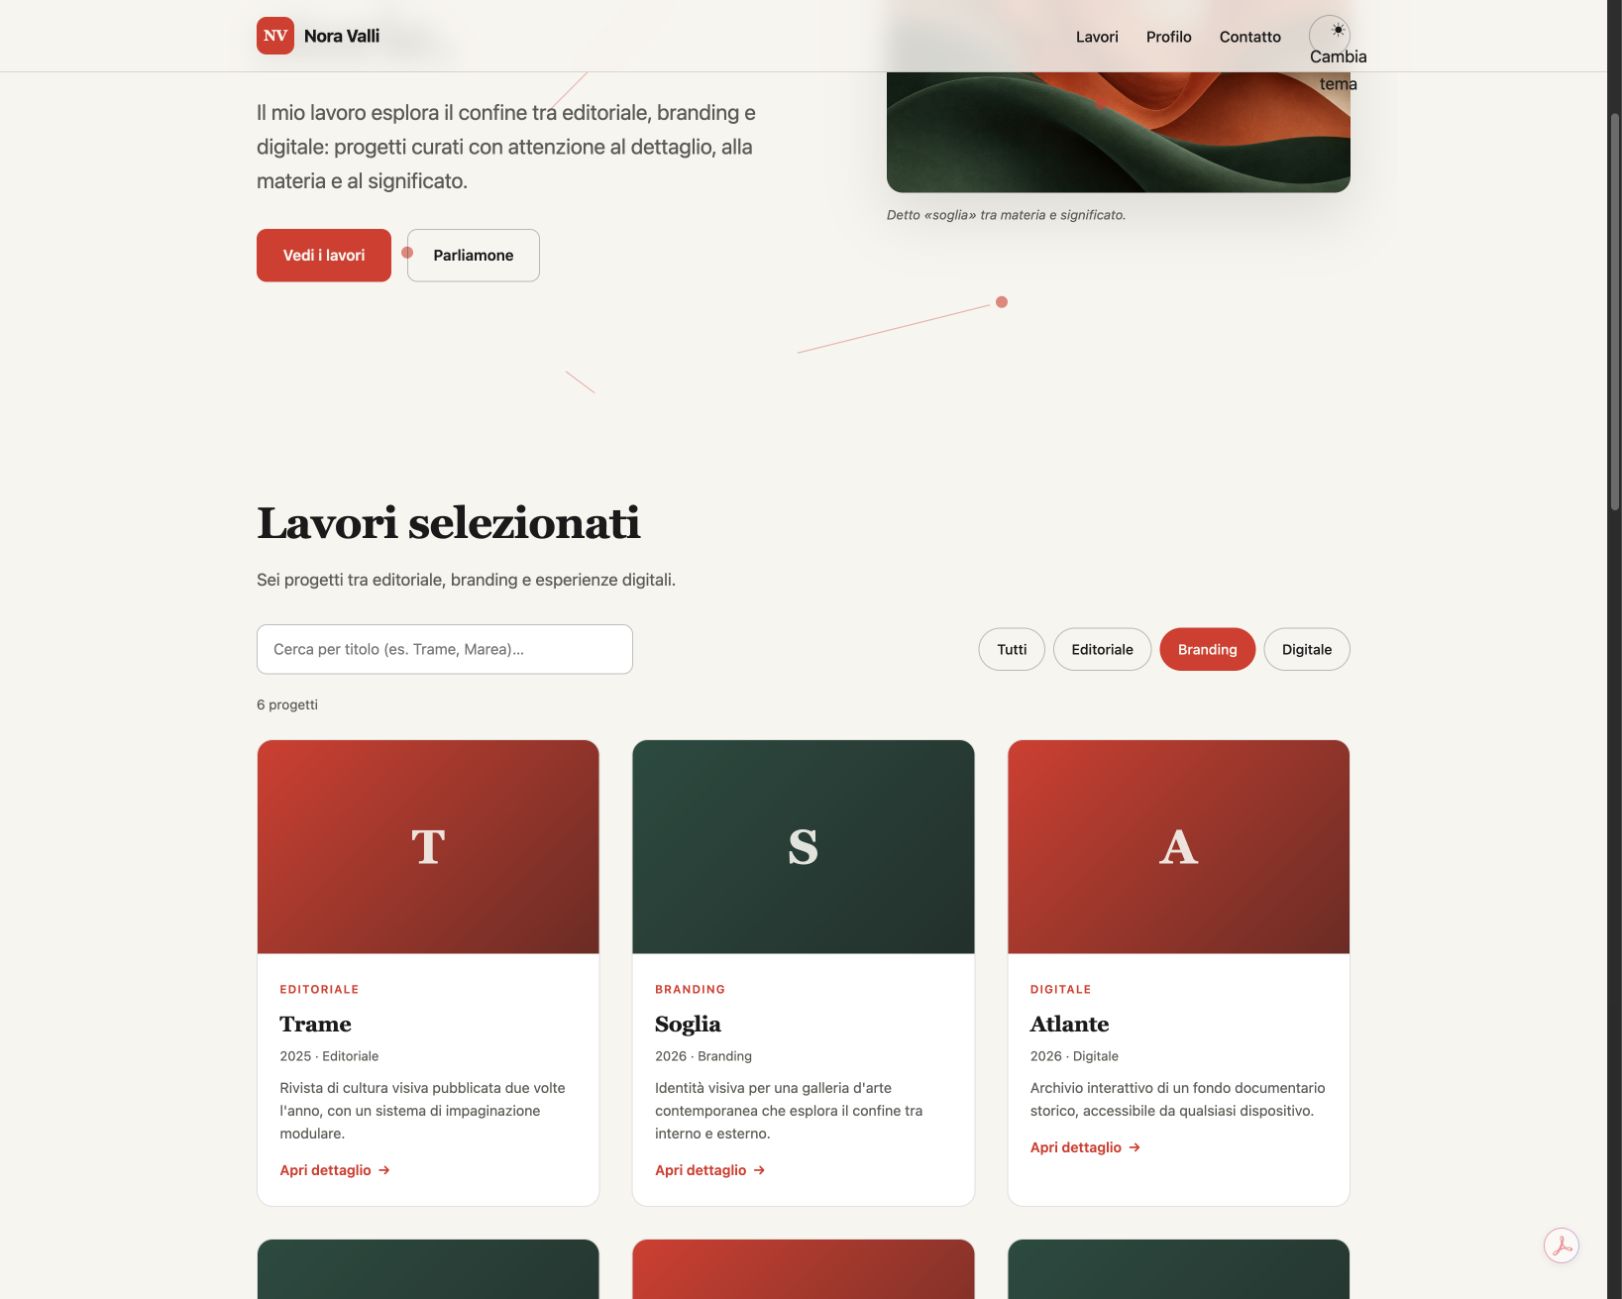
En su única ronda de corrección, Ornith corrige referencias a variables del filtro. Quedan Soglia y Orto urbano, como se pedía. La errata «2 progettoi trovatoi» sigue ahí: la comprobación verifica cantidad y estado, no certifica cada palabra de la interfaz.
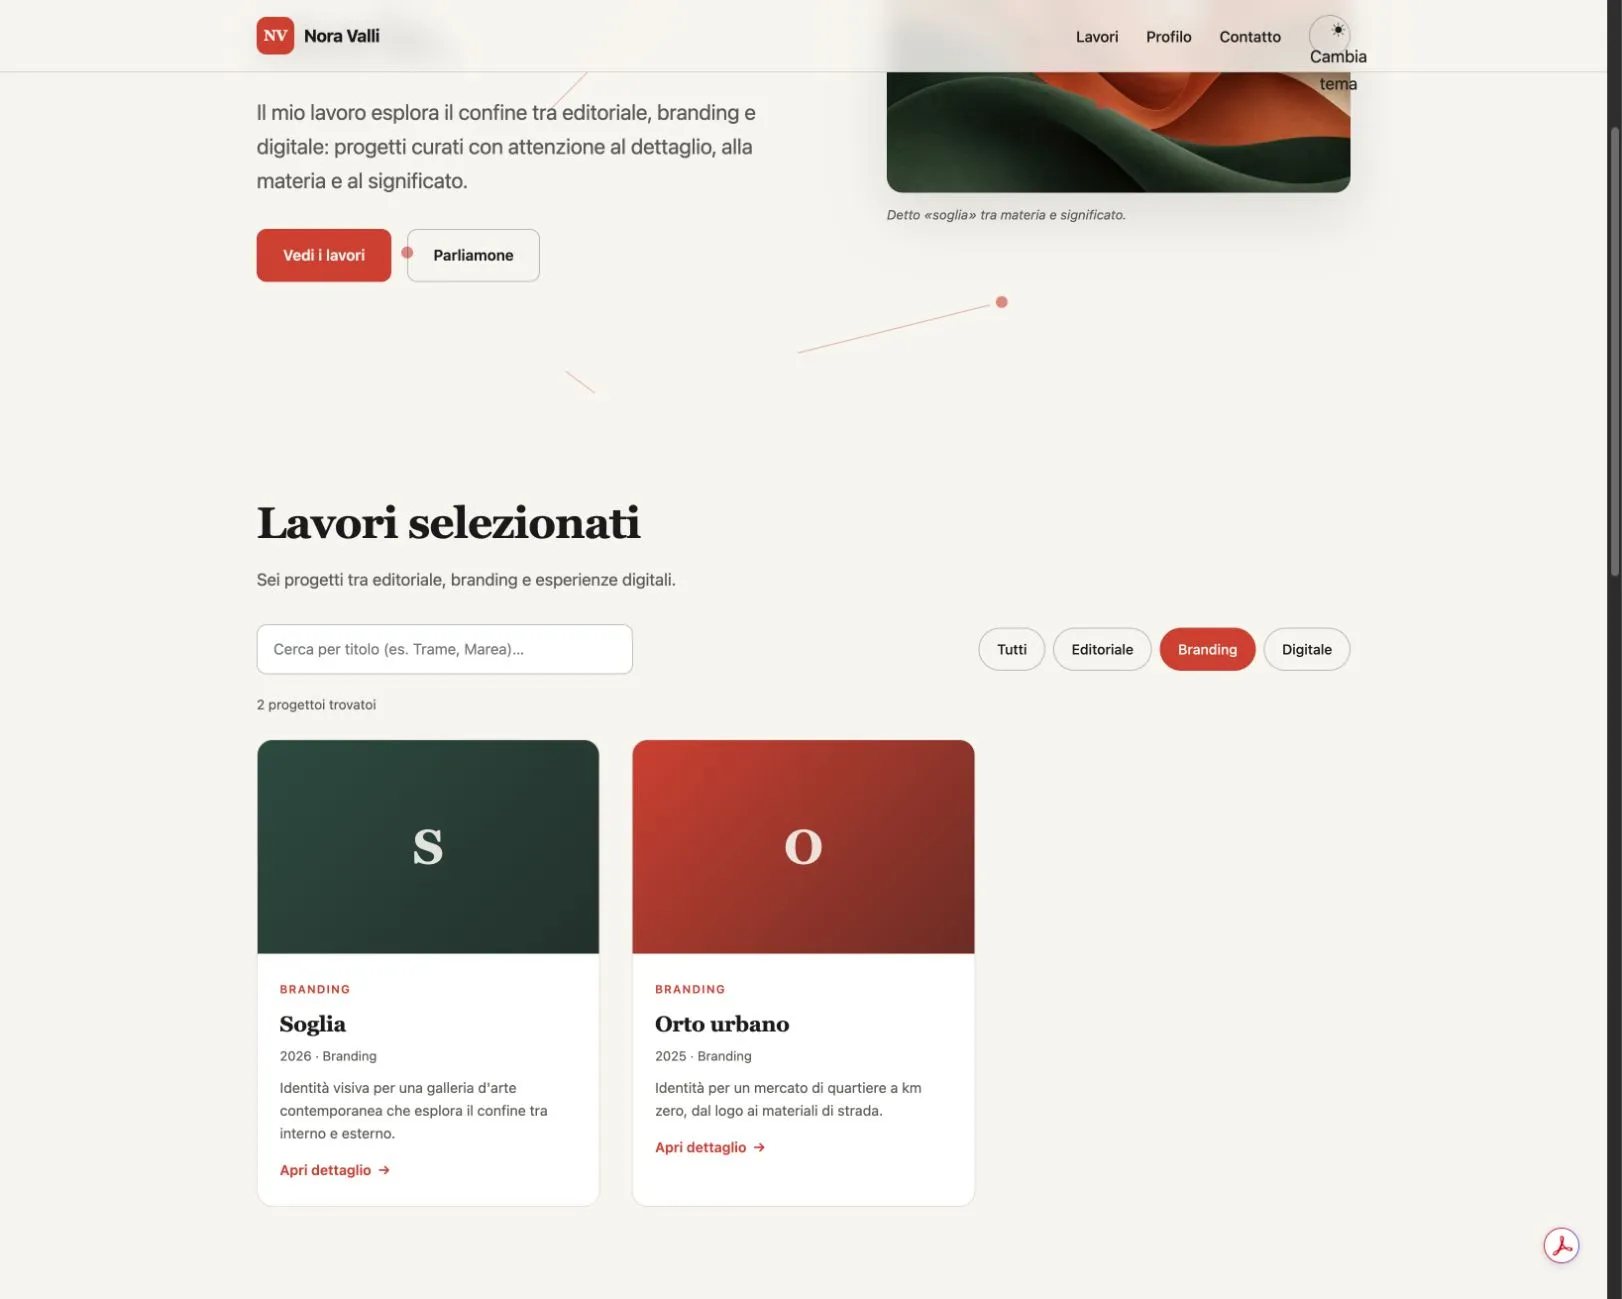
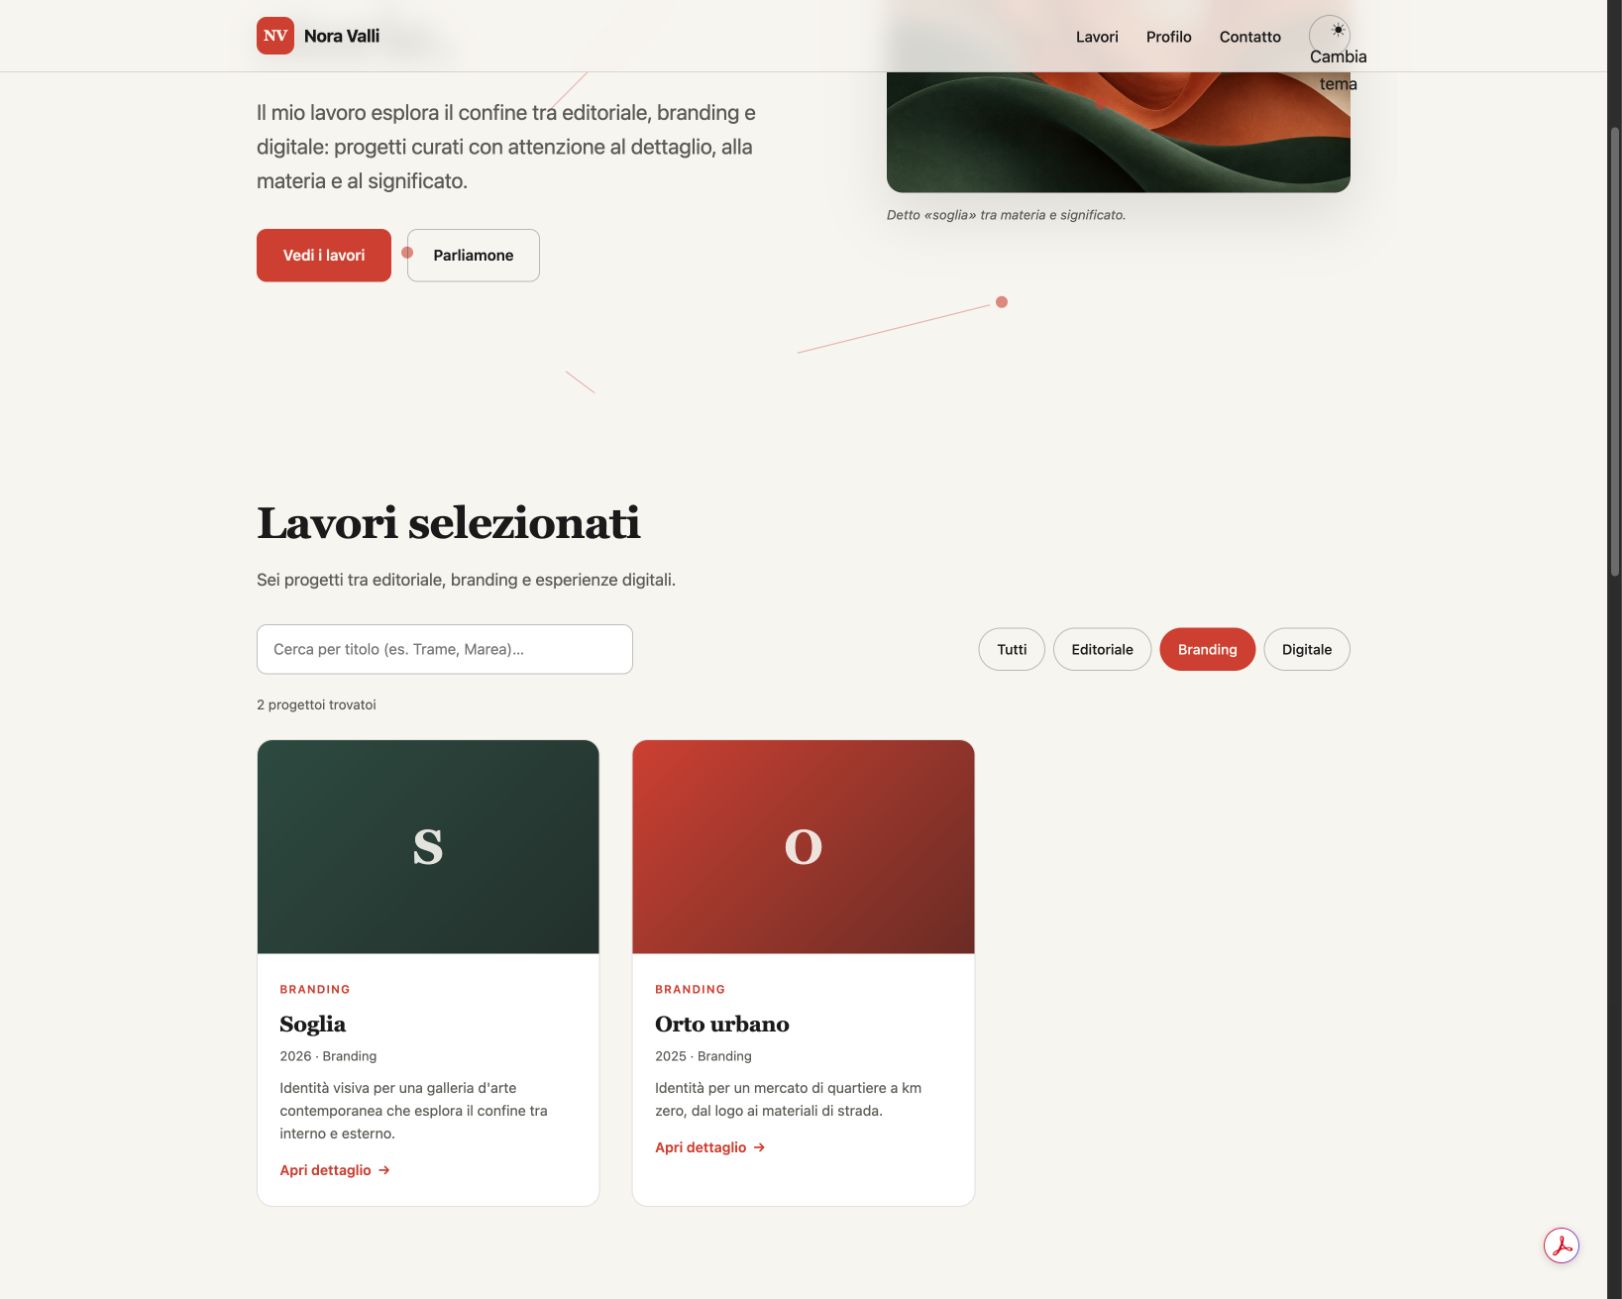
Las pruebas completas combinan filtro y búsqueda. La secuencia esperada pasa de seis resultados a dos, después a uno y a cero, y vuelve a seis al restablecer. Si buscar «Soglia» sigue mostrando ese proyecto en Editoriale, el filtro y la consulta trabajan por separado: una captura de un filtro correcto no verifica su combinación.
Una iteración puede corregir, repetir o empeorar
Aquí, una iteración adicional significa una nueva ejecución de Pi, con nueva sesión y prompt, que parte de los archivos anteriores y termina con todas las verificaciones externas. Una llamada a herramienta o una respuesta del modelo no es una nueva iteración.
| Configuración | Inicio | Recorrido de las comprobaciones completas | Iteraciones adicionales |
|---|---|---|---|
| Qwen | 9, más una parcial | 9 → 9 → 10 | 2 |
| Ornith | 8 | 8 → 10 | 1 |
| LFM | 4 | 4 → 4 → 4 → 4 → 4 → 4 → 4 → 3 → 5 → 6 → 8 → 9 → 9 → 10 | 13 |
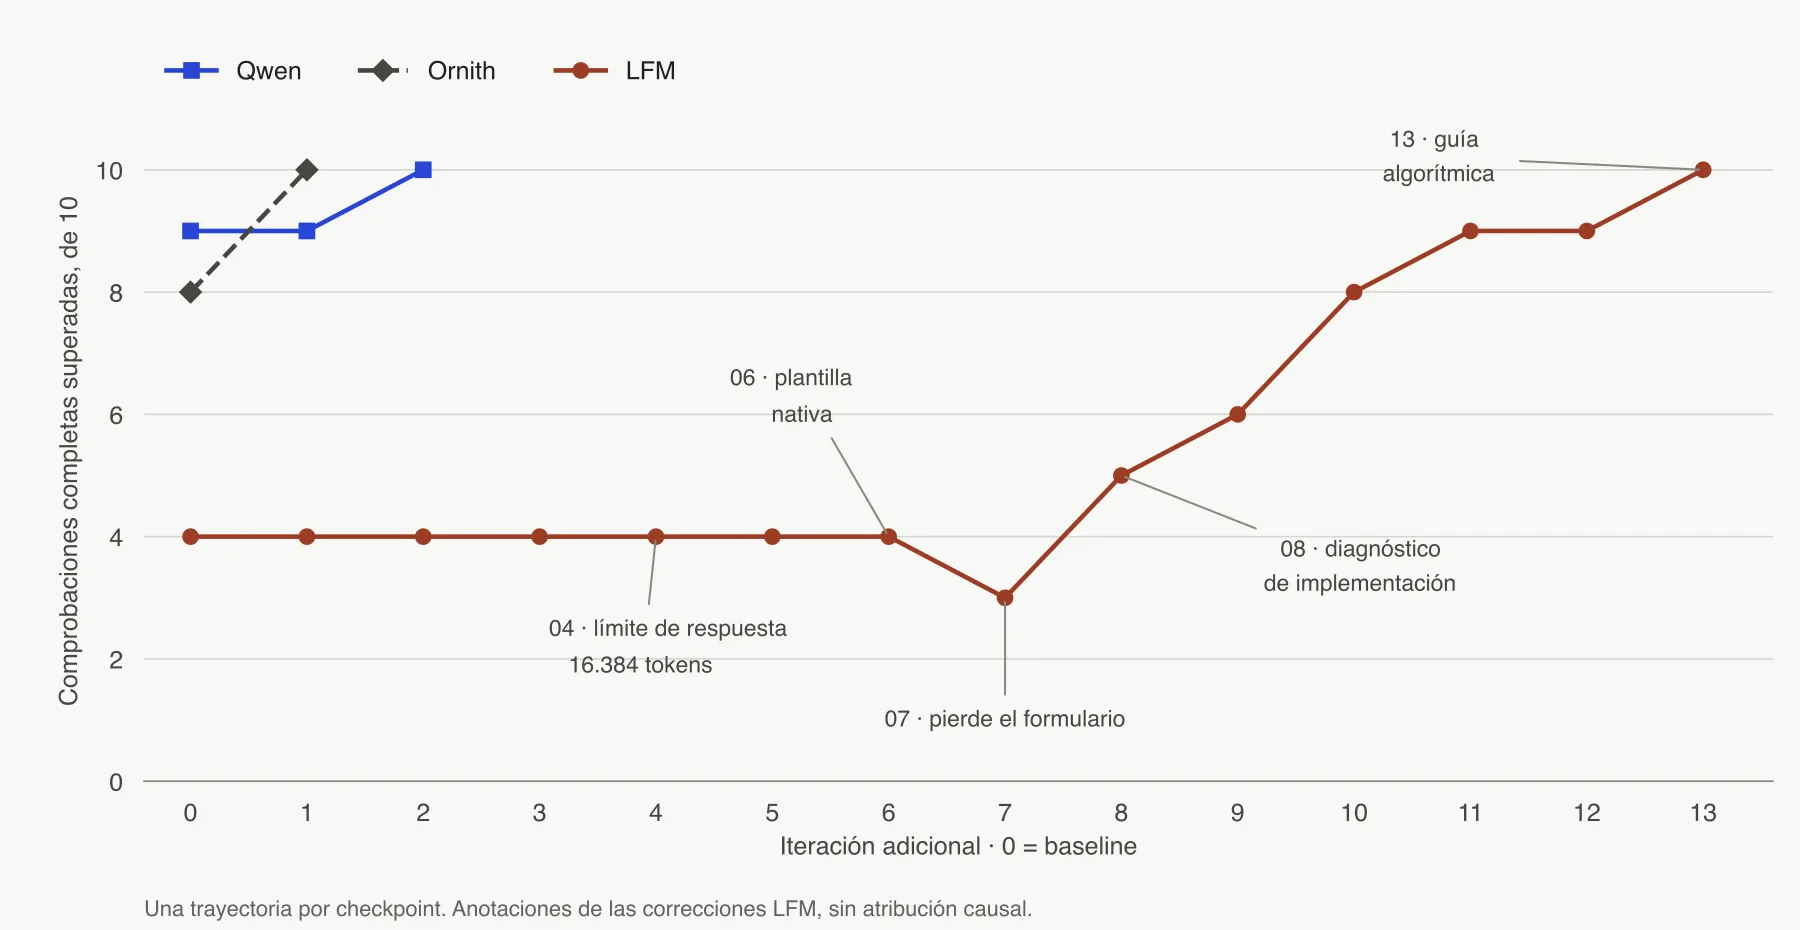
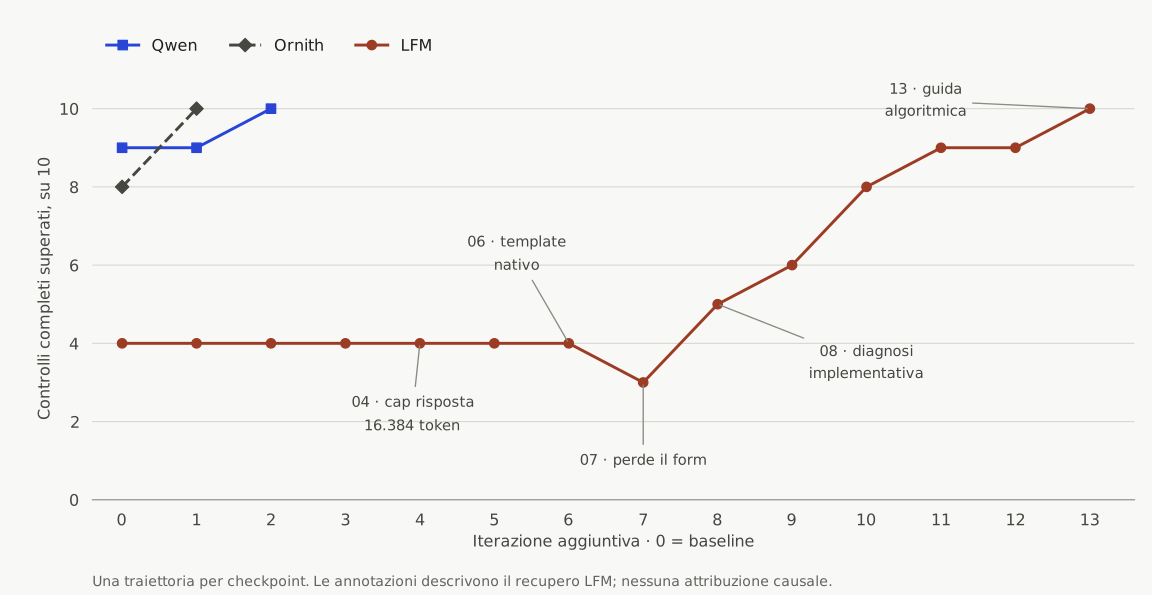
Cada flecha de LFM corresponde a una ejecución conservada, incluidos los intentos sin mejora. La caída de cuatro a tres es la ronda 07: una reescritura pierde el gestor del formulario. El desbordamiento móvil es un problema distinto, ya presente, y no explica ese punto perdido.
En la primera corrección, Qwen utiliza las 24 llamadas a herramientas disponibles. La secuencia incluye lecturas de script.js, sustituciones y check_files repetidos, y luego más sustituciones y comprobaciones. La segunda ronda vuelve a alcanzar 24 llamadas, esta vez superando las diez verificaciones externas.
Es una repetición operativa observable en los registros. Qwen y Ornith ya tenían enable_thinking=false en las peticiones nativas. Estos pasos no permiten reconstruir un proceso mental interno ni demostrar un defecto general de Qwen. check_files verificaba archivos y sintaxis: el modelo podía repetirlo sin ver el diálogo aún cerrado en el navegador.
Ornith realiza ocho llamadas a herramientas y tres sustituciones en su única corrección. El runner registra unos 48 segundos. El defecto se resuelve rápido en esta trayectoria, pero la cantidad y dificultad de los problemas iniciales diferían de los competidores.
Cuánta ayuda recibió LFM
El tratamiento de LFM cambió durante el recorrido. Tras dos intentos sin progreso, el prompt se vuelve más concreto. Desde la ronda 04, el límite por respuesta sube de 8192 a 16384 tokens, manteniendo el máximo total de 24.000. Desde la ronda 06 también cambia el formato de mensajes o plantilla: se abandona un prefijo experimental que cerraba el bloque think y se usa el formato nativo, solicitando thinking.
Tras la regresión de la ronda 07, el coordinador limita las herramientas a pequeñas sustituciones, usa instrucciones breves en inglés y aporta diagnósticos de implementación. En la ronda 10 facilita también el texto italiano de confirmación del formulario. En la ronda 13 explica cómo enlazar al crear las tarjetas, usar el proyecto actual, activar la clase que abre el diálogo y mantener el foco en el botón de cierre.
Esa guía puede consultarse en el prompt original de la ronda 13, junto con el diff generado. El modelo escribe los parches, pero recibe una parte sustancial de la solución. El 10/10 final debe leerse como resultado de una corrección muy asistida.
Las comprobaciones que necesitan una secuencia
Un diálogo abierto es solo parte de la verificación. Hay que abrir los seis trabajos, comprobar contenidos coherentes, cerrar con botón y Escape y devolver el foco al enlace inicial. Se probaron Tab y Mayús+Tab en un diálogo representativo. Las comprobaciones y sus resultados están en los JSON de auditoría: una imagen del diálogo no demuestra por sí sola la contención del foco.
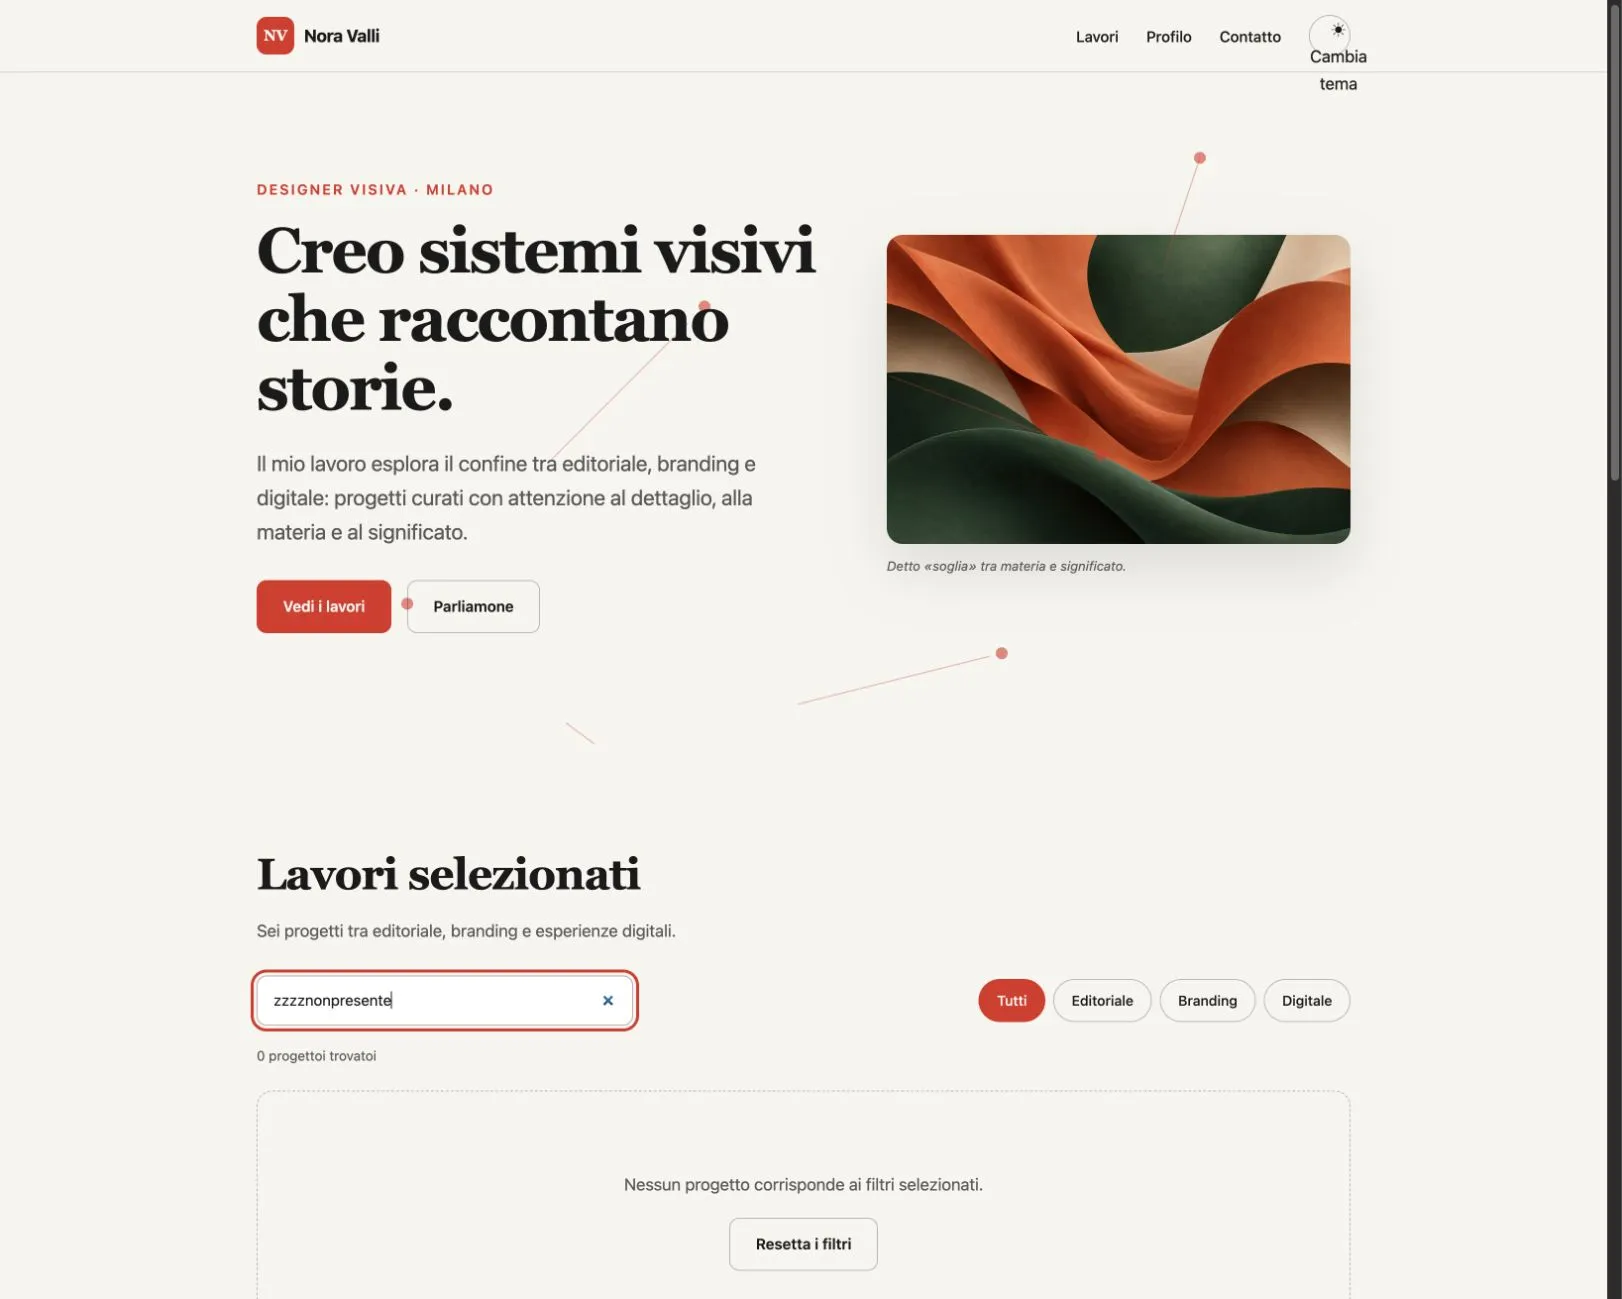
El estado vacío debe ser comprensible y reversible. En Ornith, una búsqueda sin coincidencias muestra cero, un mensaje y el restablecimiento. Aquí también permanecen visibles los defectos lingüísticos.
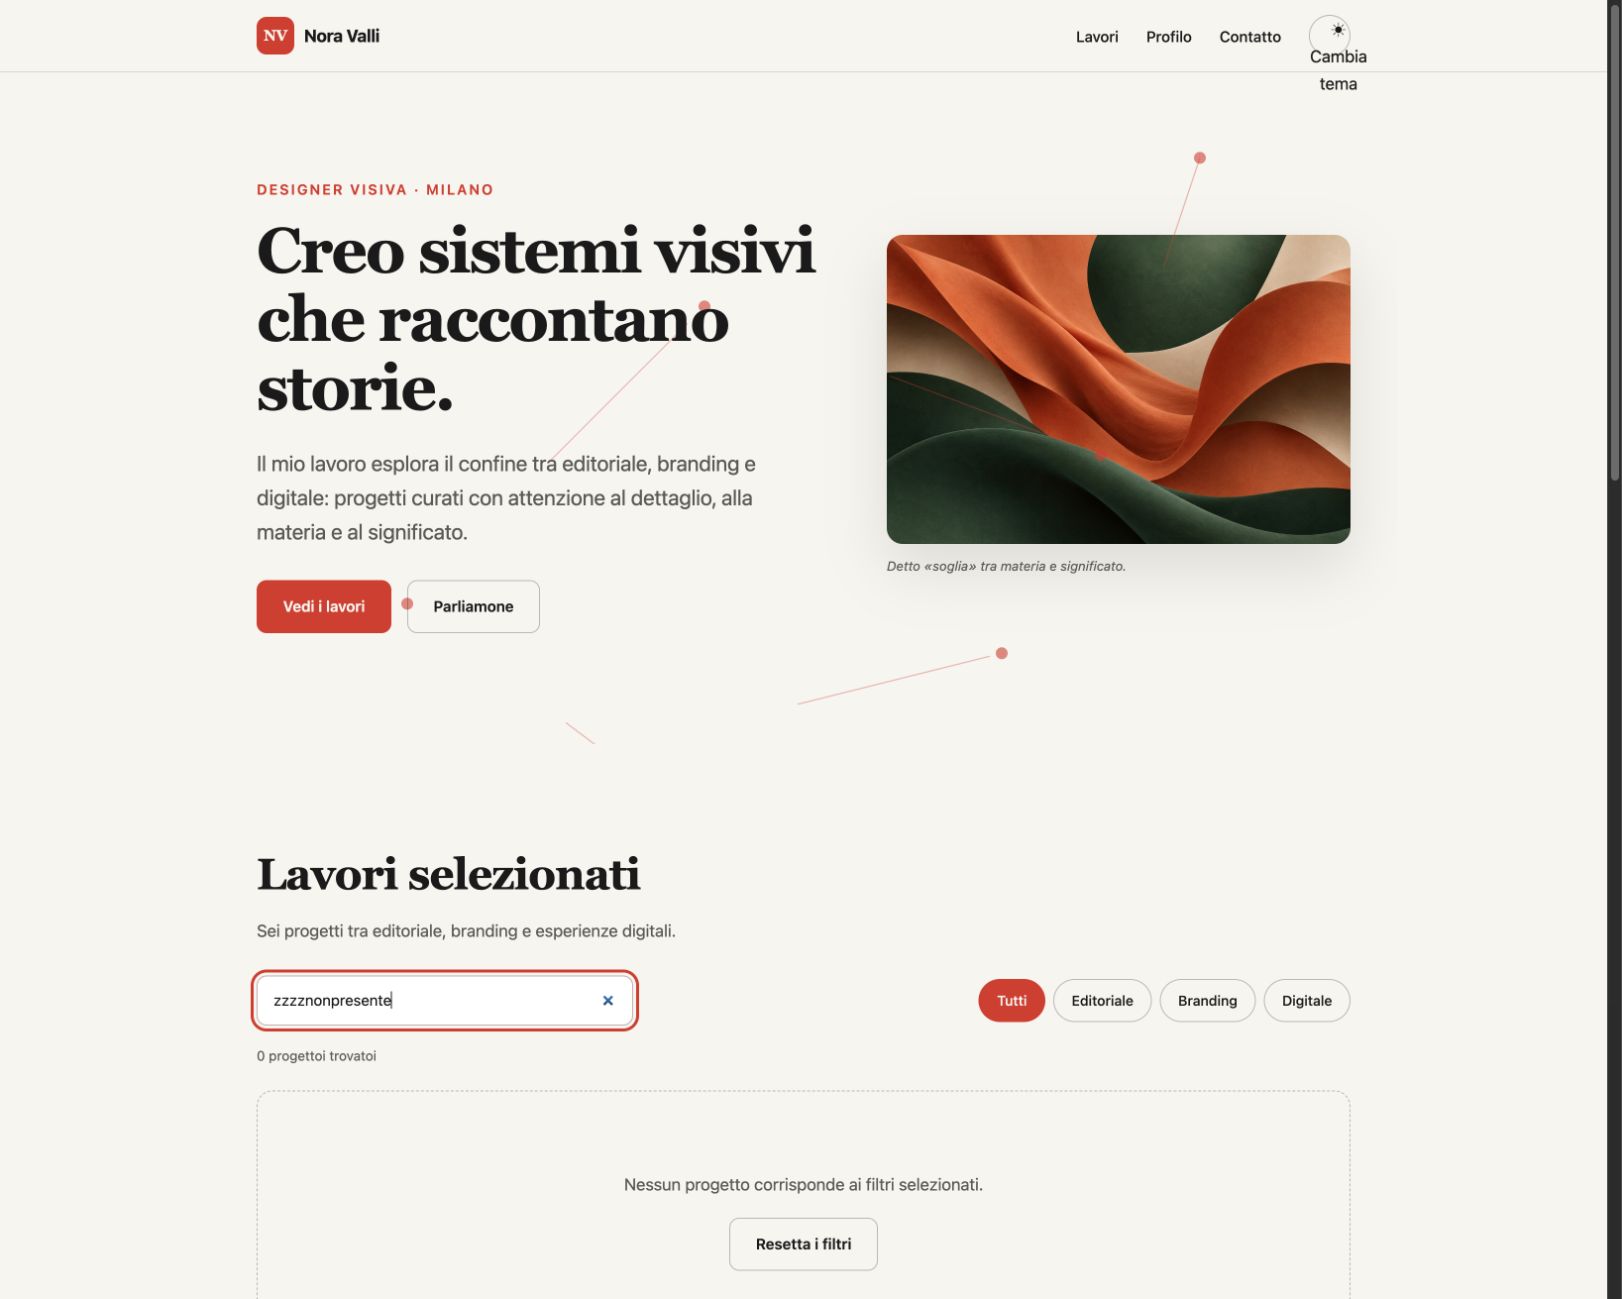
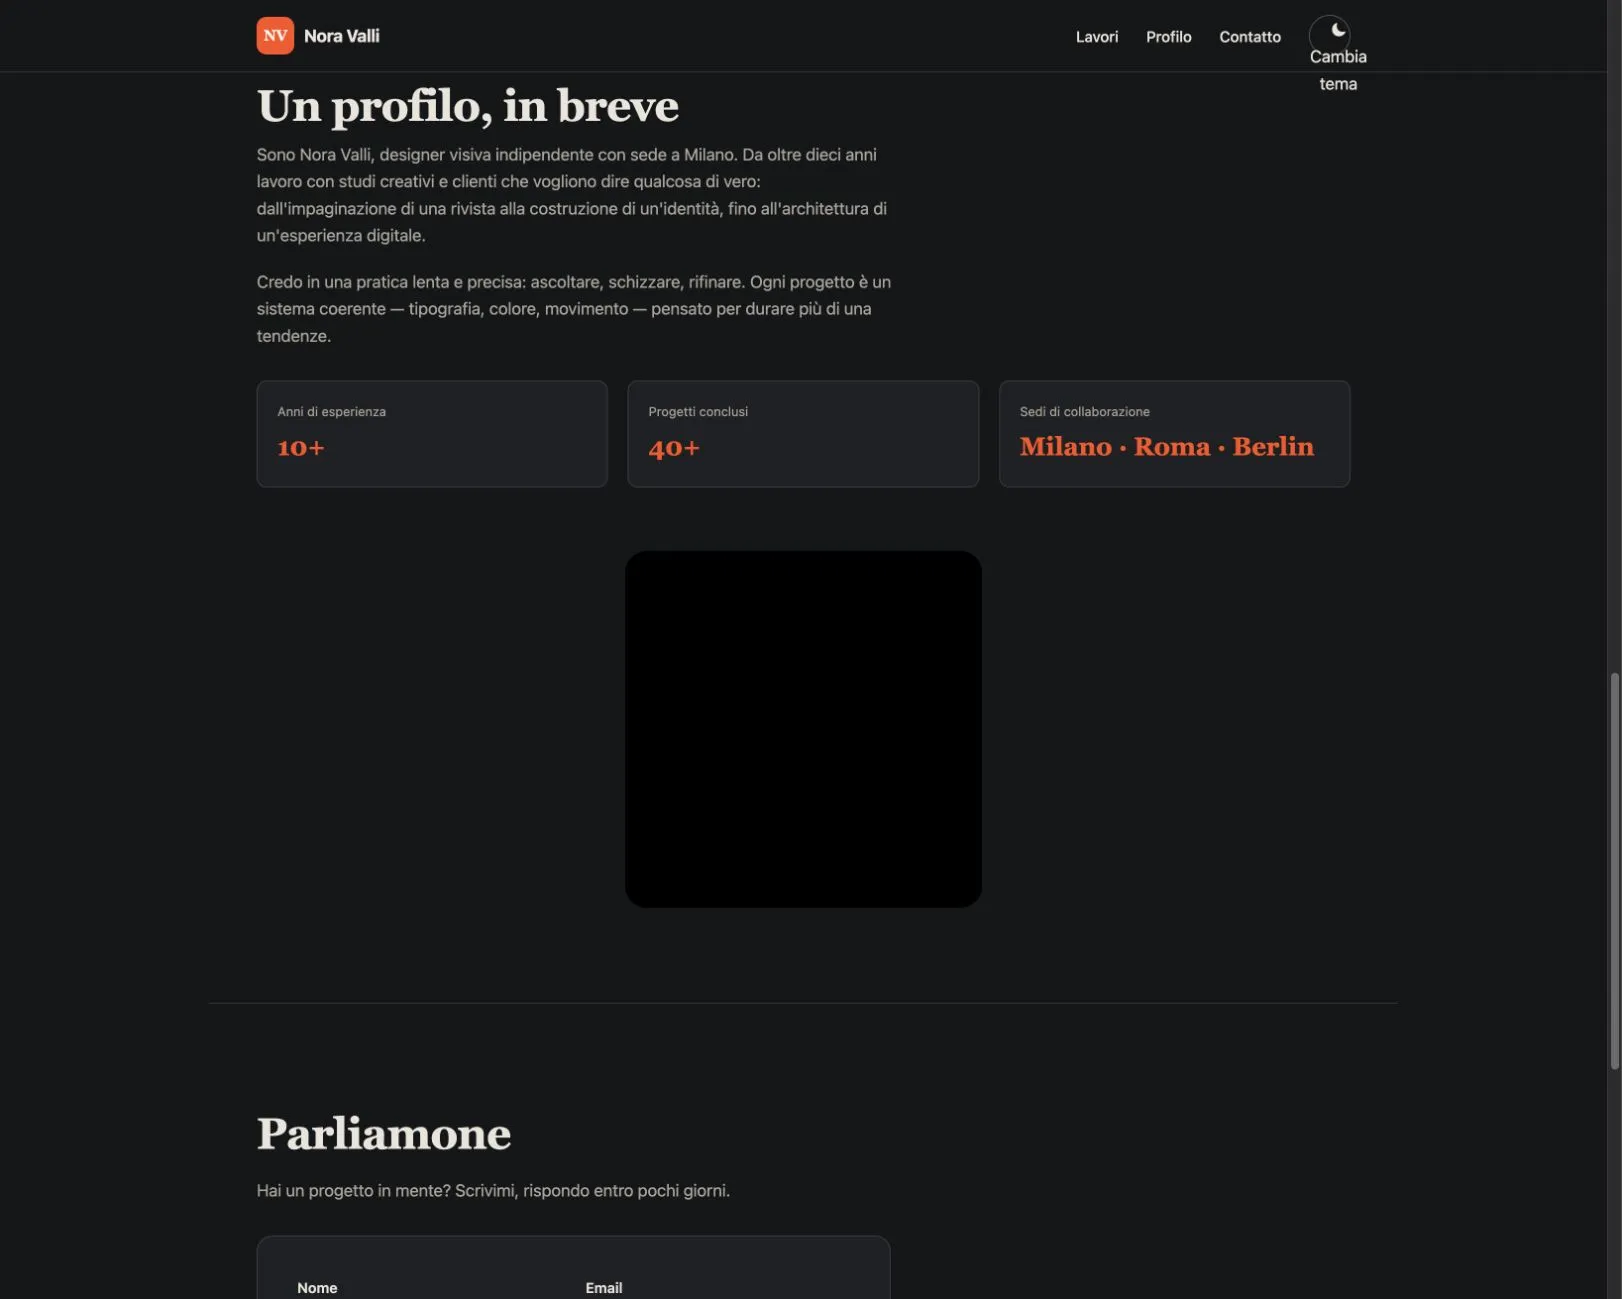
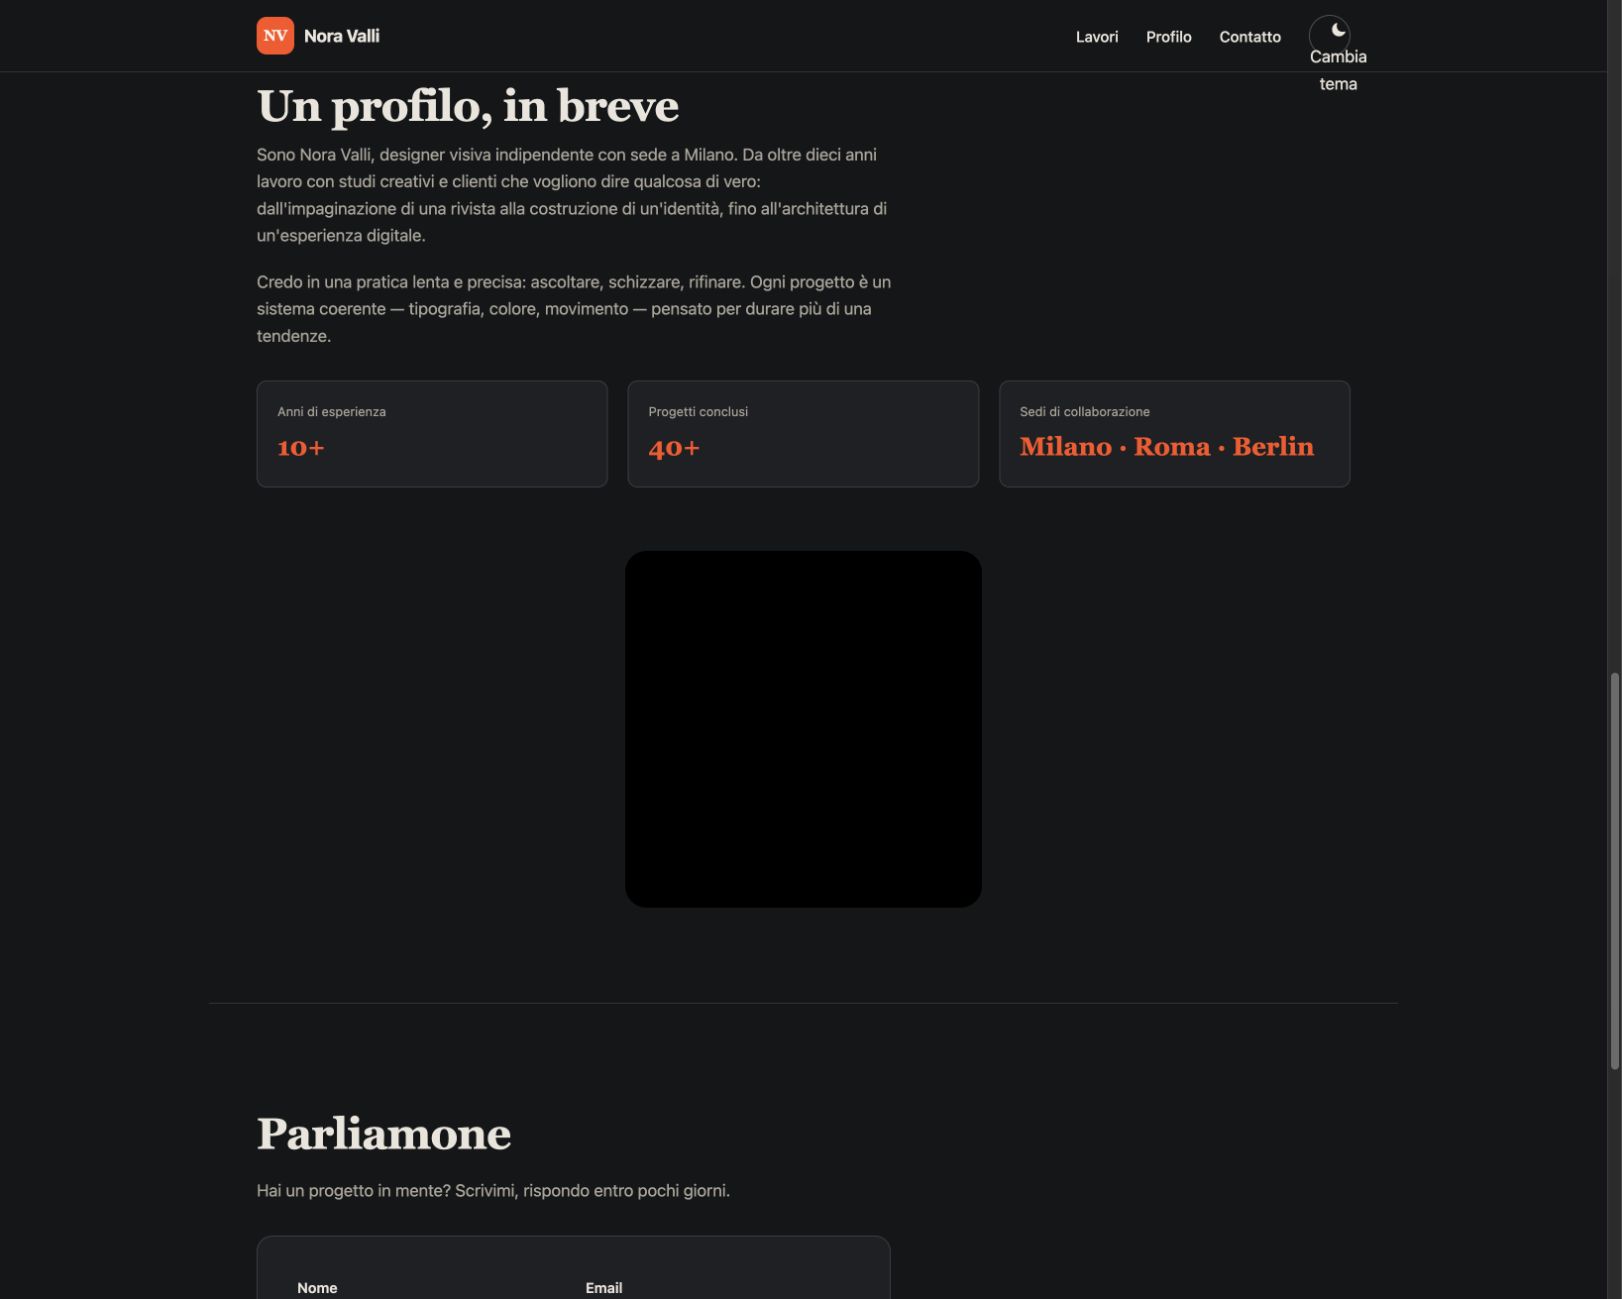
Una página oscura no prueba la persistencia del tema. Hay que cambiar, recargar y comparar el estado guardado. El evaluador leyó al principio el color demasiado pronto, al inicio de la transición de Ornith: un falso negativo corregido y documentado sin atribuir otro intento al modelo.
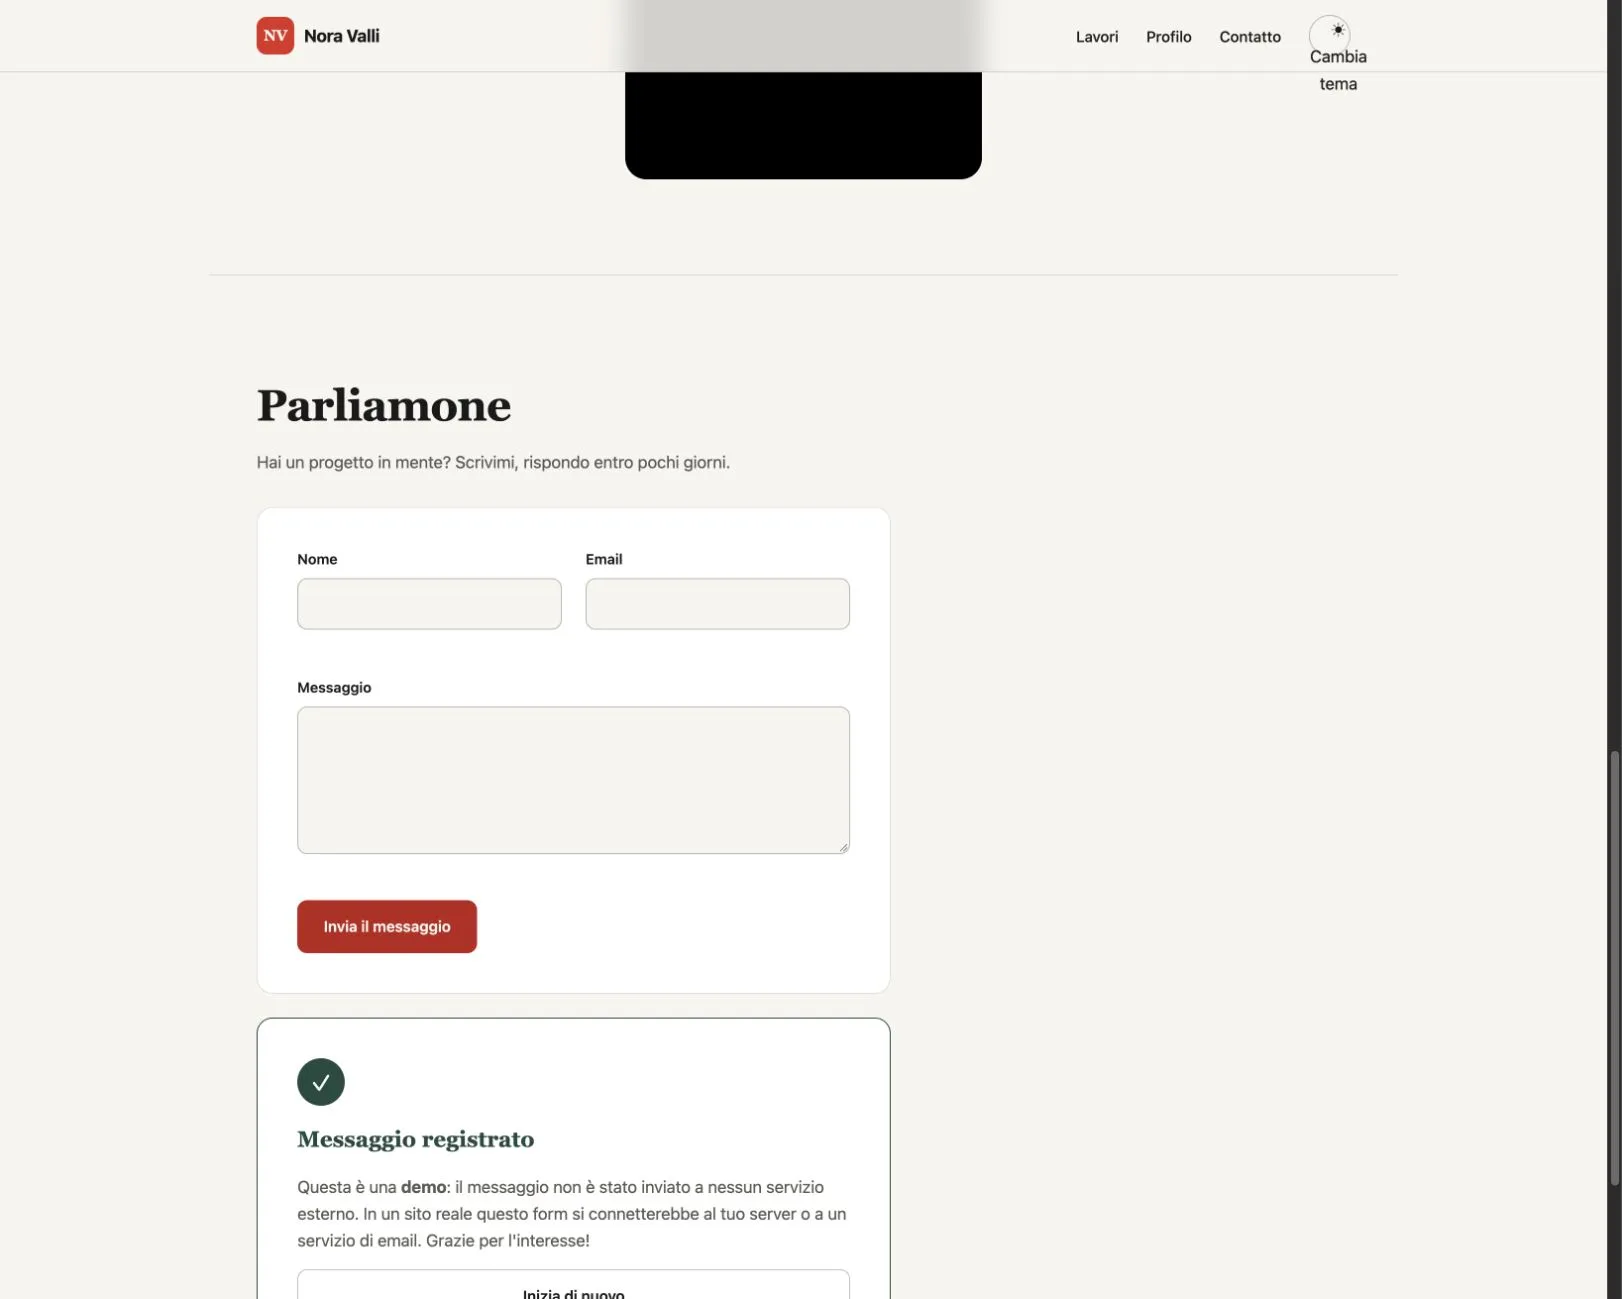
El formulario debía rechazar datos ausentes y correos inválidos, y confirmar localmente un envío de demostración. Se usaron datos sintéticos. La frase «no se ha enviado nada» es necesaria para el lector, pero la ausencia de transmisiones externas también se apoya en inspeccionar el código, no solo en la promesa escrita.
El teléfono revela otros problemas
Las cuatro imágenes siguientes tienen un viewport de 390×844. El navegador reserva 15 píxeles para la barra de desplazamiento, dejando 375 de contenido. En las versiones finales de los tres portfolios, scrollWidth y clientWidth coinciden en 375.
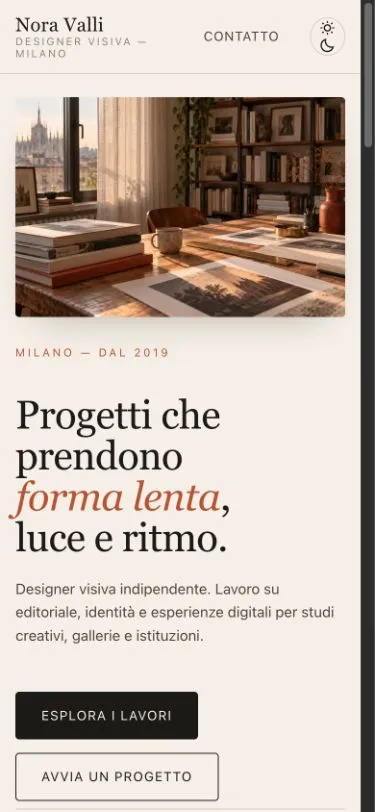
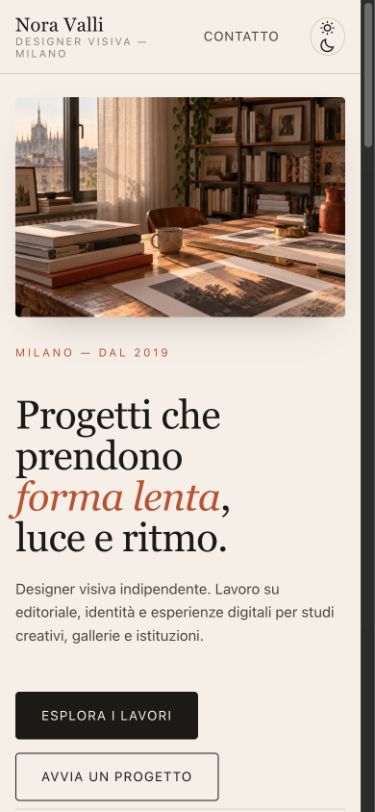
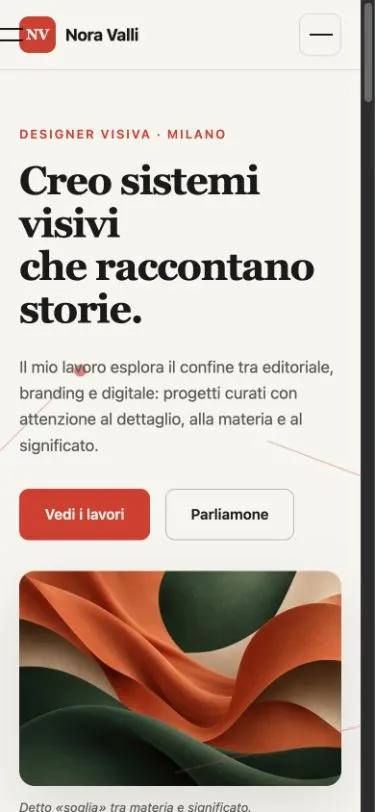
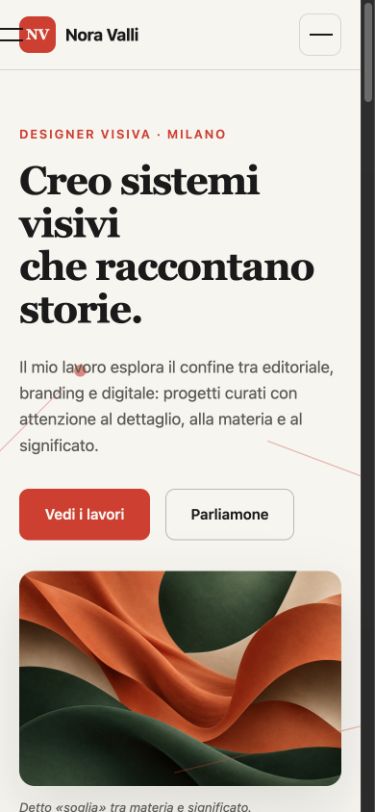
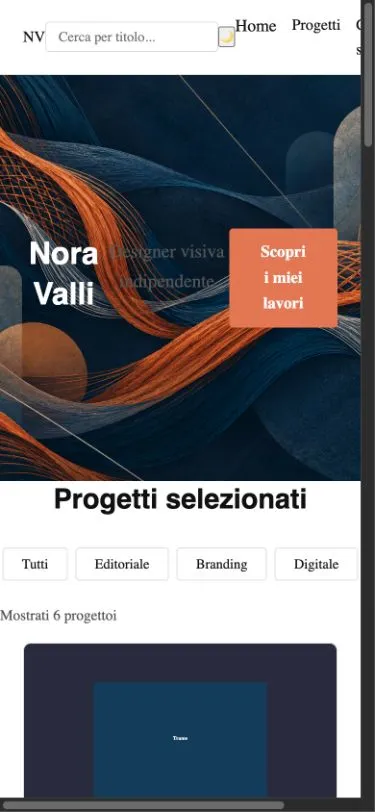
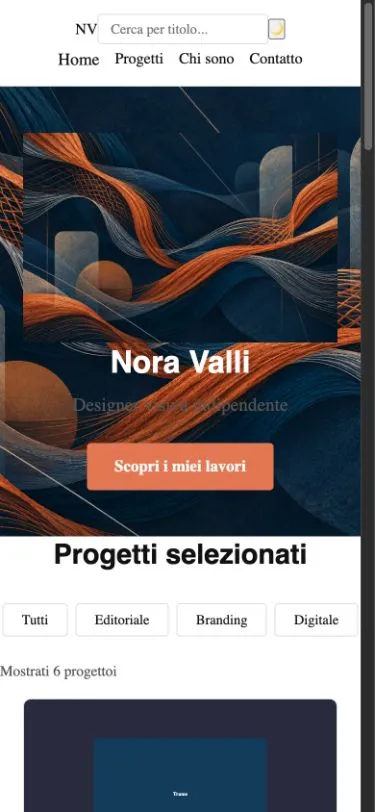
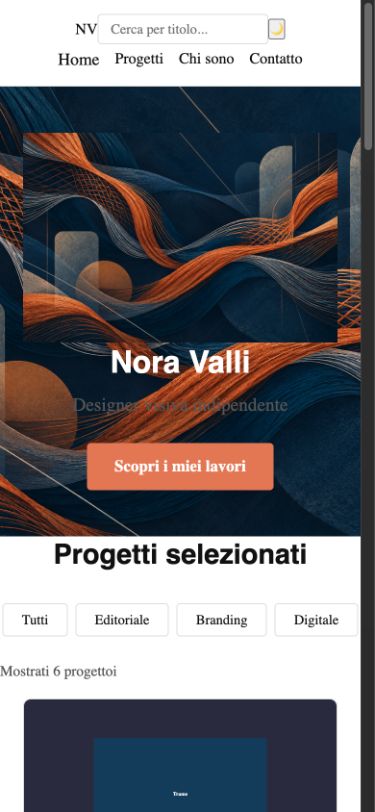
La ausencia de desbordamiento es una comprobación precisa y limitada. No mide la comodidad de cada gesto, la legibilidad de todos los textos ni el equilibrio de la composición. Para valorar esas cualidades hay que seguir usando y observando la página.
Todos llegan a diez, tres sitios distintos
Estas son las páginas finales, de nuevo desde viewports de escritorio de 1440×900. Las imágenes originales permanecieron idénticas durante las correcciones. El código cambió algunos comportamientos; la estructura visual sigue distinguiendo tres resultados.
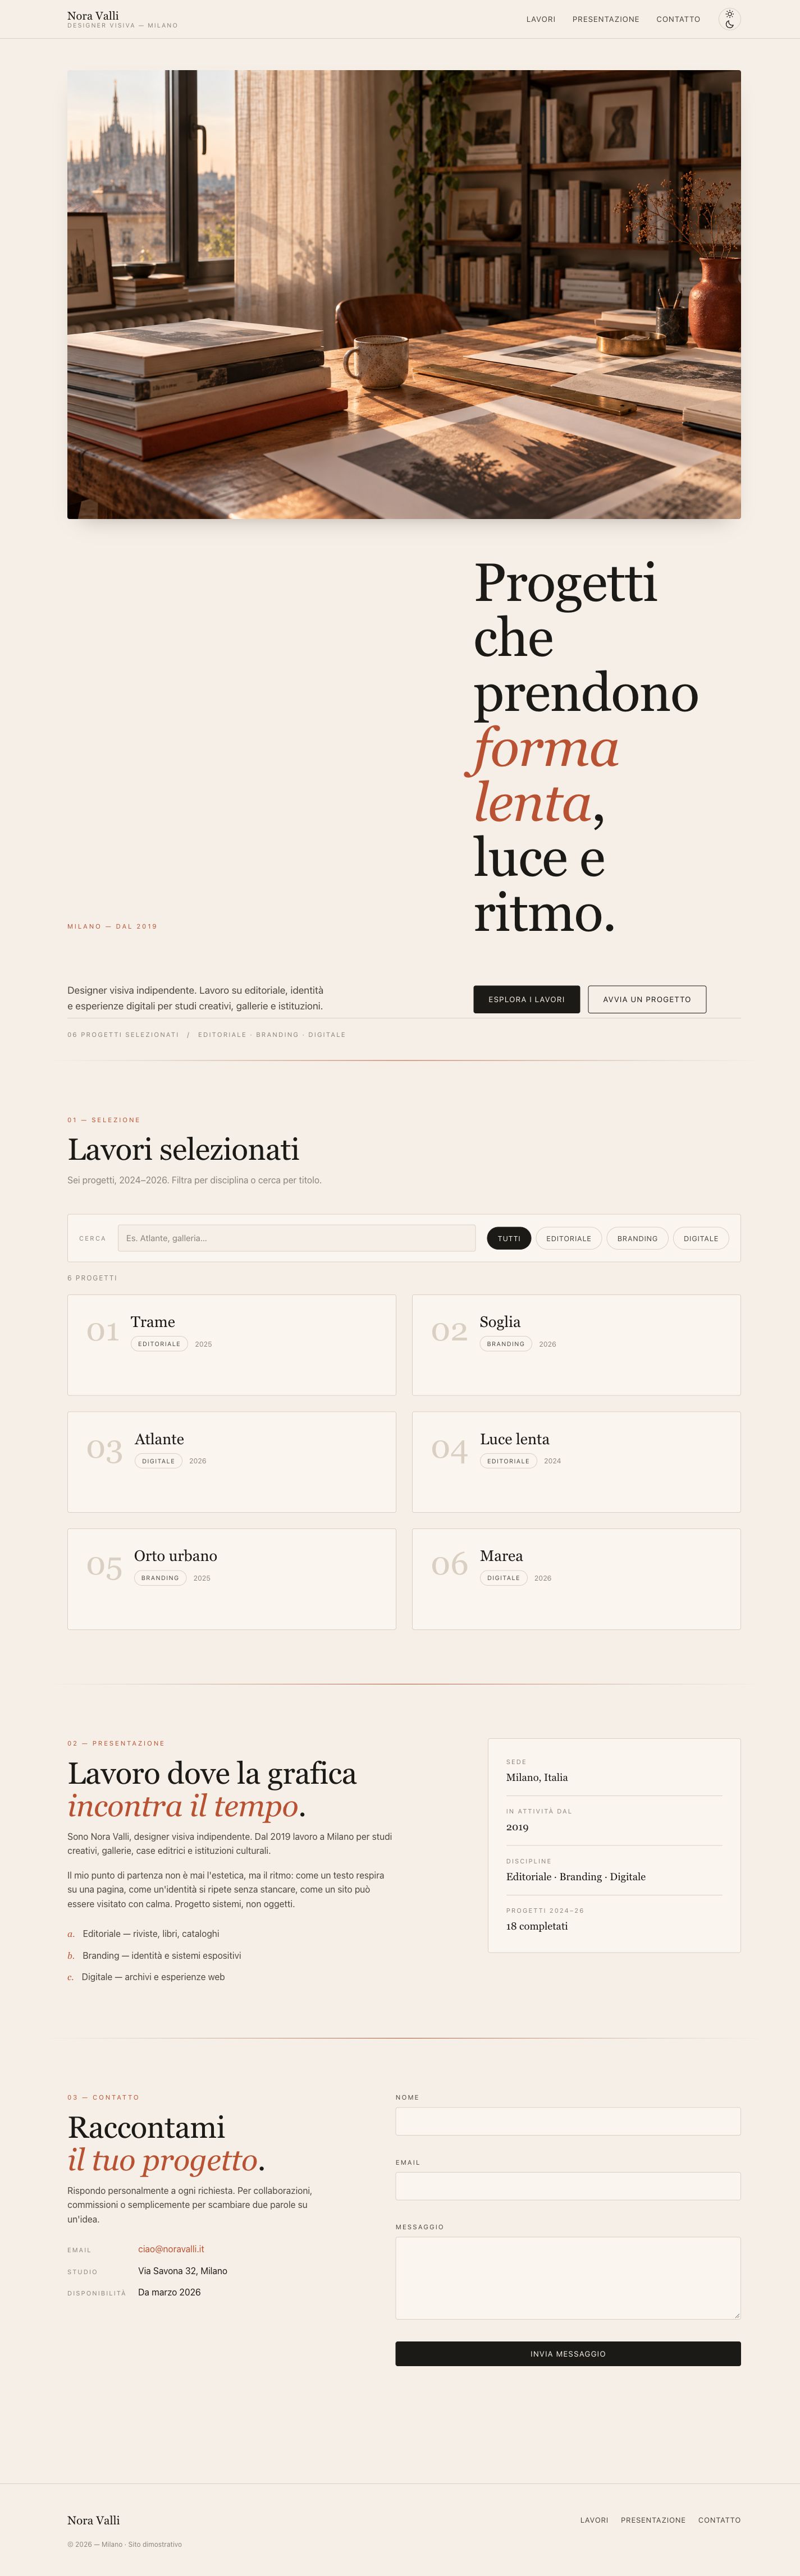
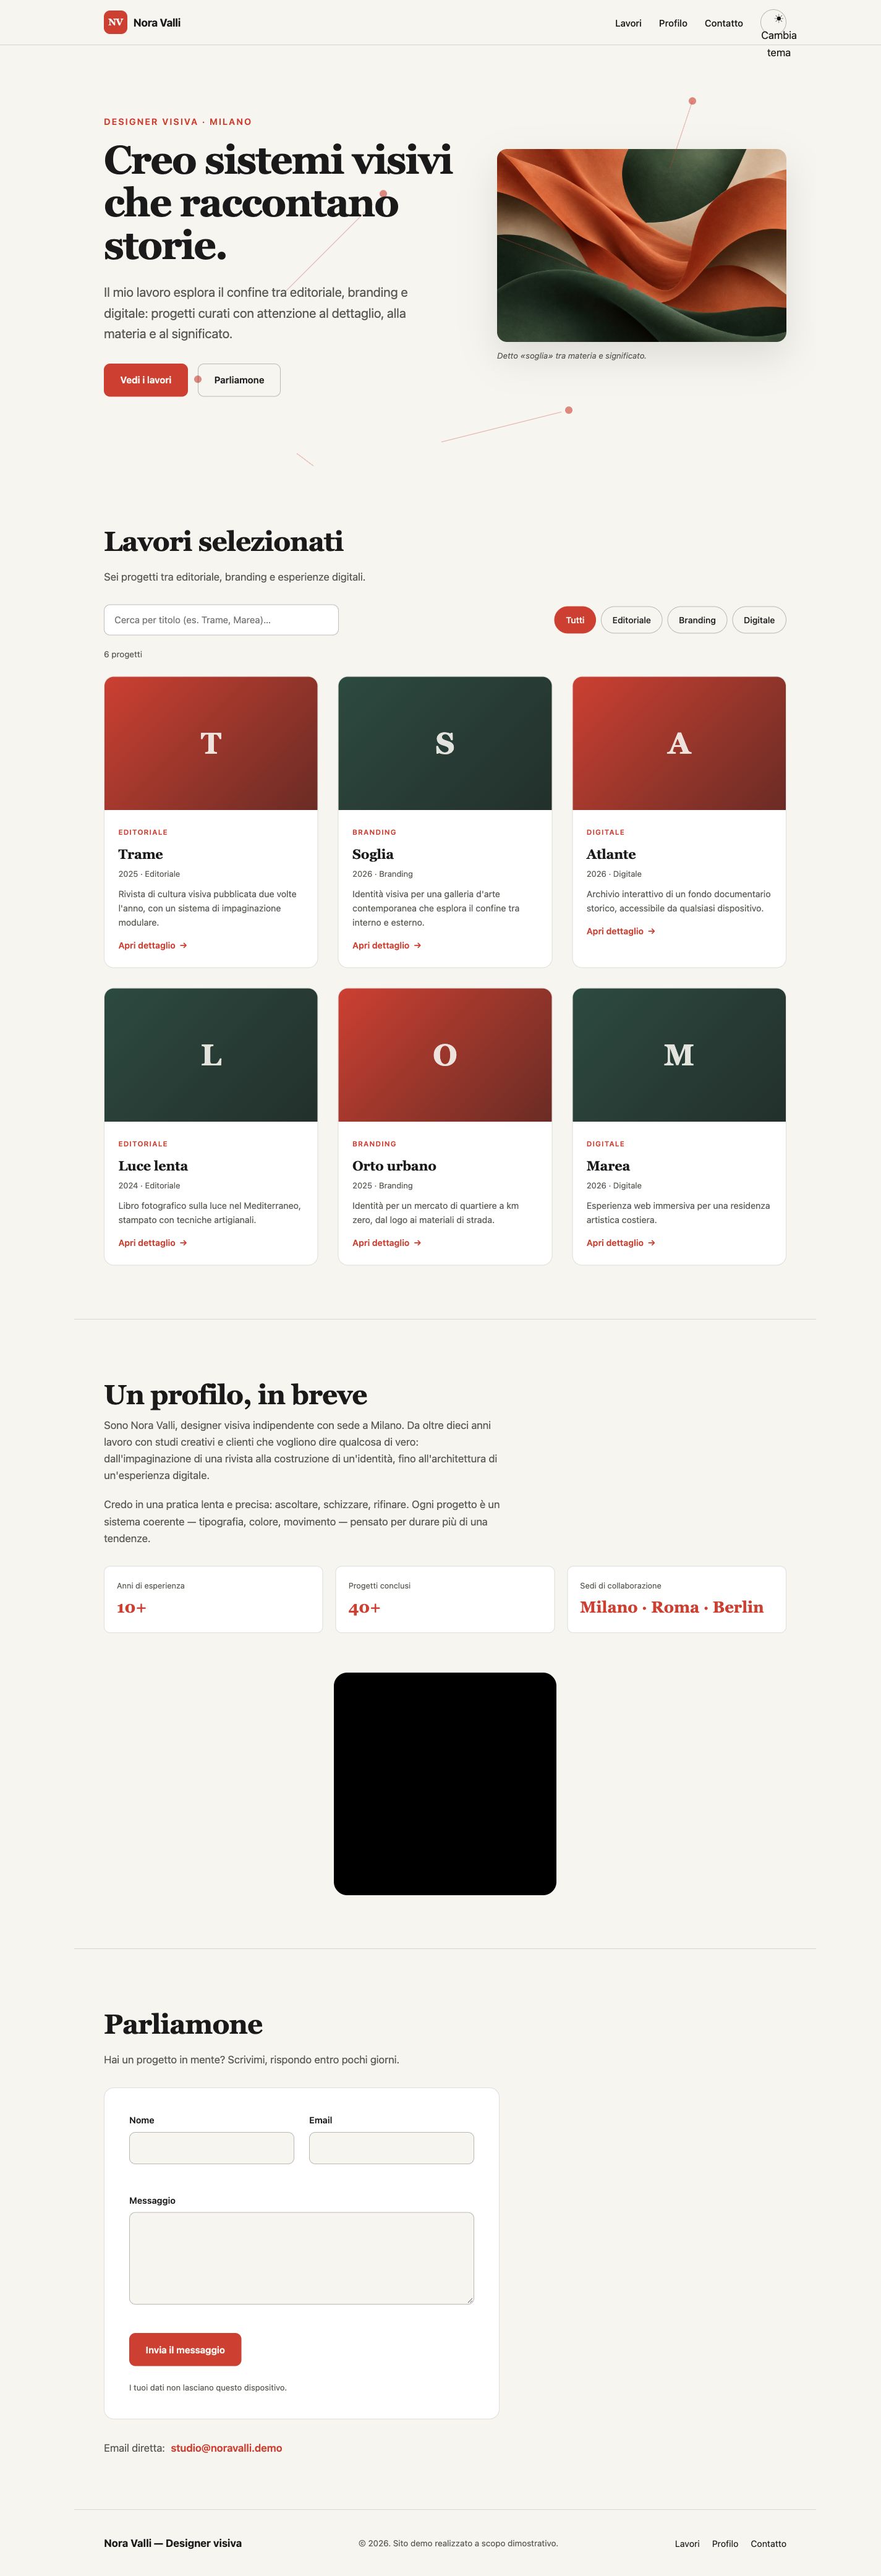
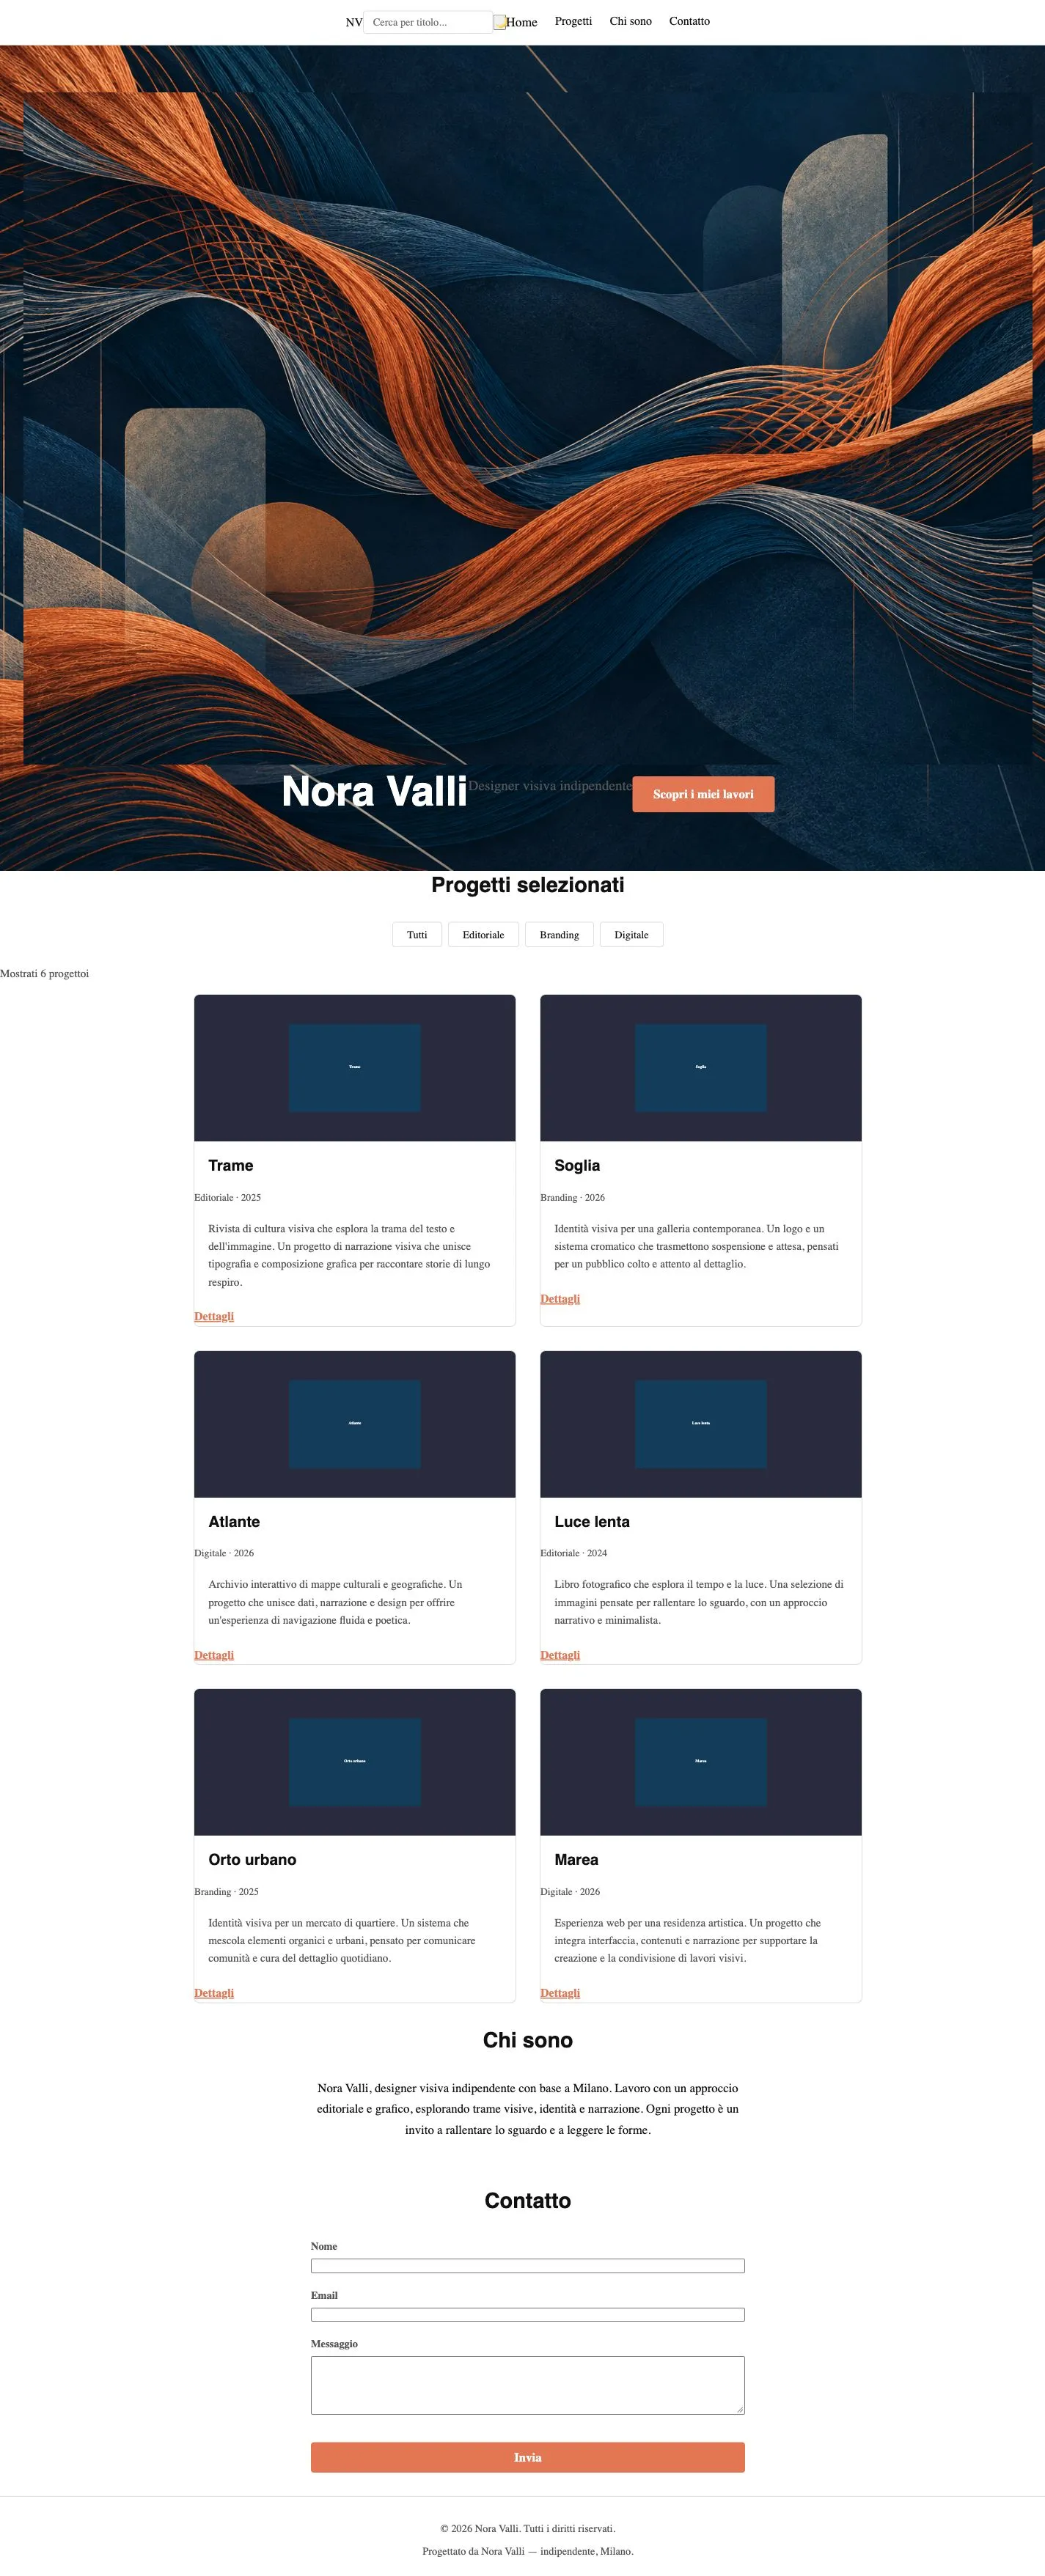
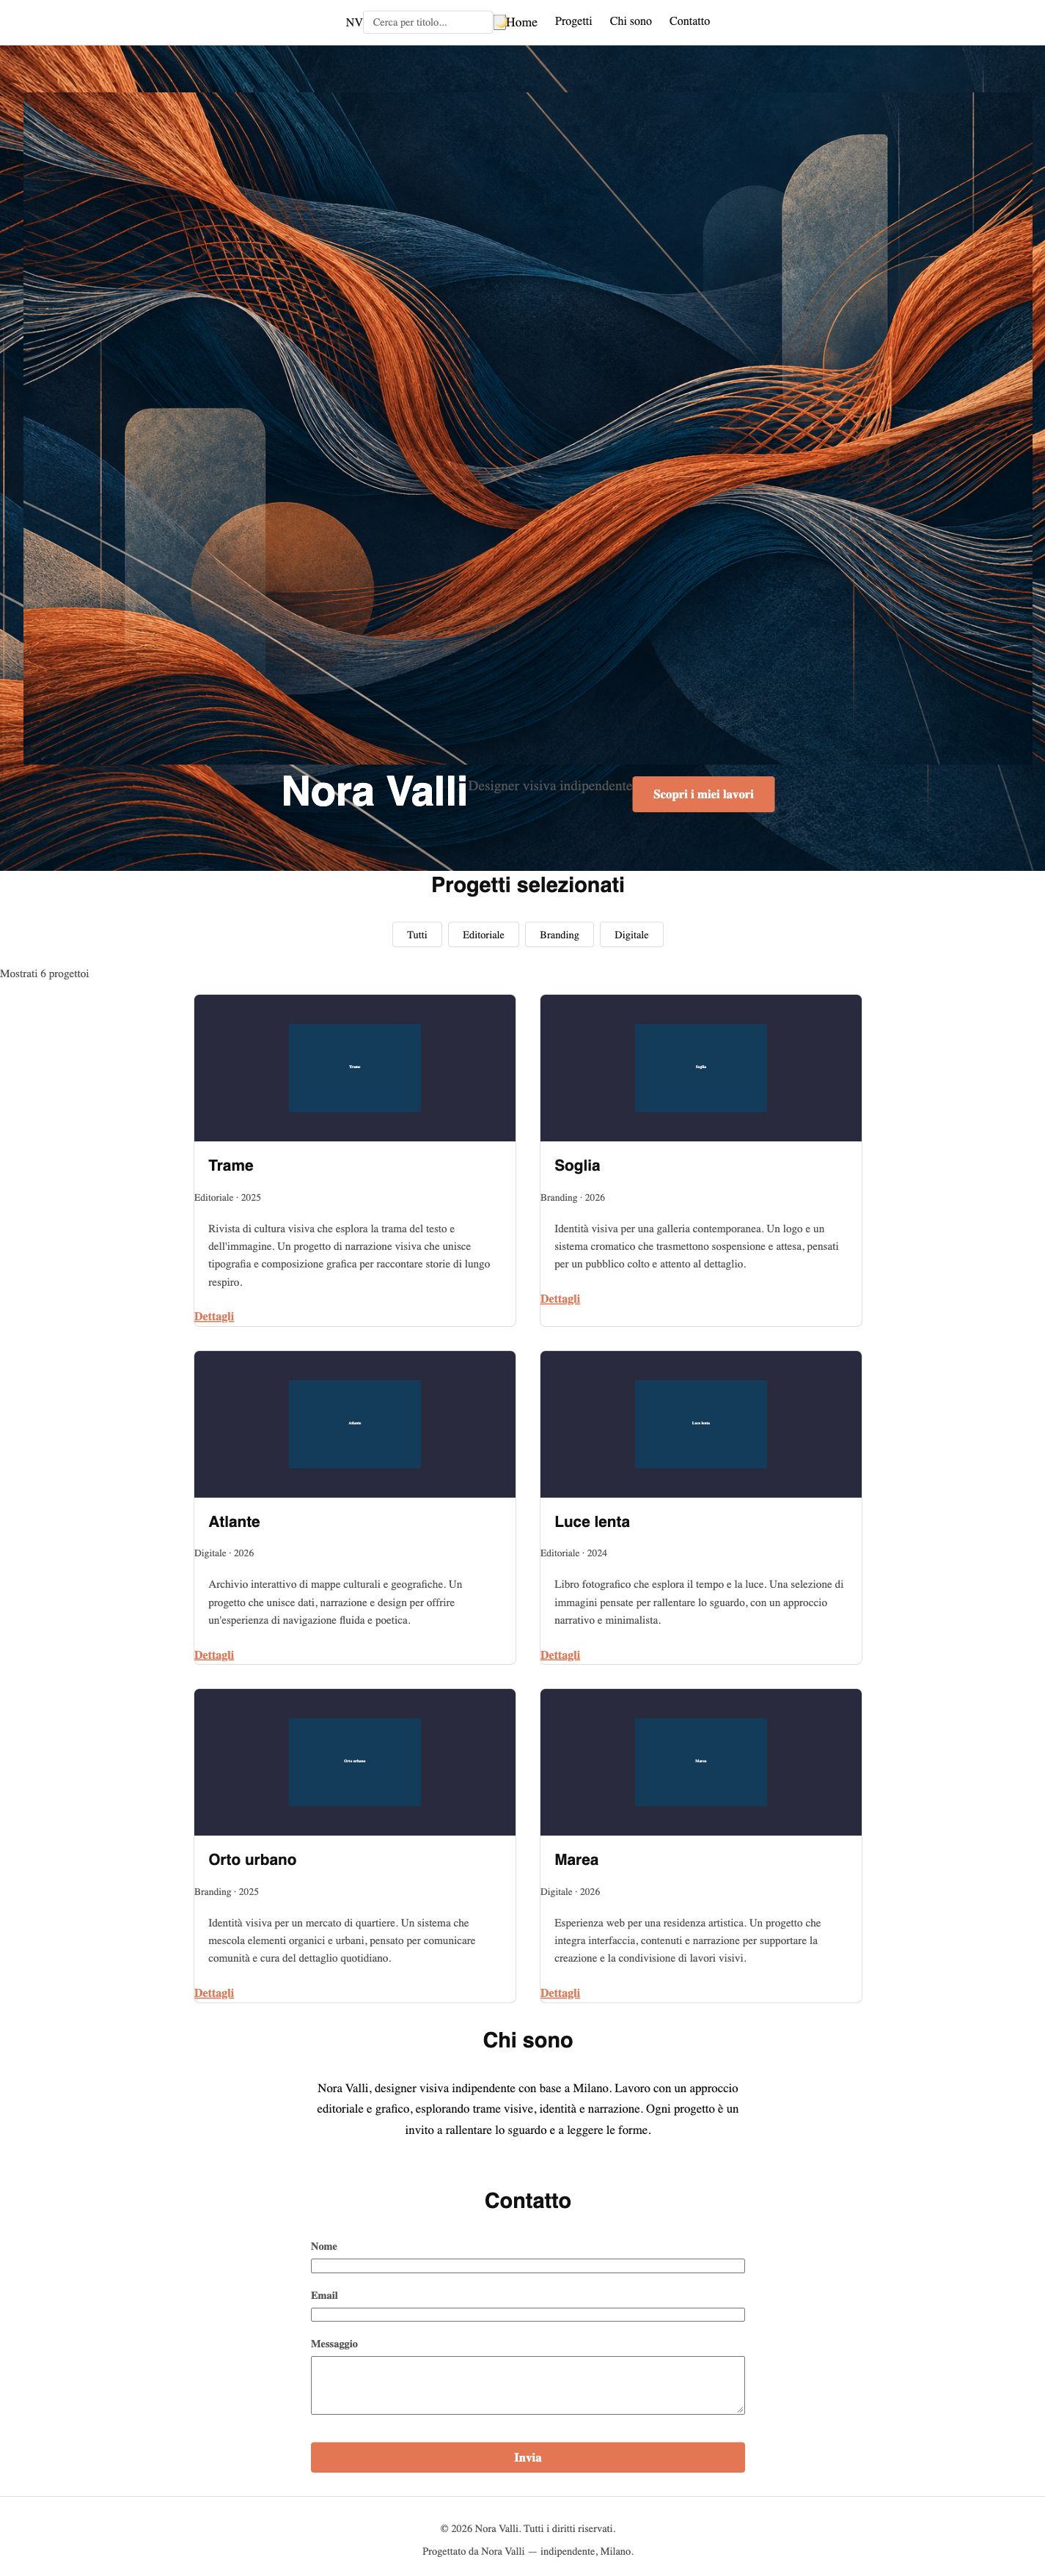
En mi juicio final, Qwen es el resultado estético que prefiero, Ornith es muy bueno y LFM no me convence. Su 10/10 no cambia esa elección. El número cuenta verificaciones funcionales definidas antes de las correcciones y precisadas durante la auditoría: no es una nota global de diseño web.
También quedan defectos fuera del alcance de la batería. El texto alternativo final de la imagen de LFM es genérico. Los atributos HTML de Qwen necesitan revisión. Los textos de formularios y contadores requieren atención editorial. Un sitio listo para otras personas necesitaría más comprobaciones.
El tiempo registrado y el trabajo que falta en la cuenta
| Configuración | Primera versión | Corrección | Total | Salida registrada en las correcciones |
|---|---|---|---|---|
| Qwen | 1656,4 s | 2470,1 s | 4126,6 s | al menos 7581 tokens |
| Ornith | 505,3 s | 48,2 s | 553,4 s | 873 tokens |
| LFM | 161,3 s | 2070,6 s | 2232,0 s | 139.532 tokens |
Las duraciones las mide el programa que inicia y cierra cada ejecución, llamado runner. Incluyen arranque, esperas del servidor, trabajo del agente y limpieza final. No son solo tiempo de GPU ni incluyen toda la coordinación y evaluación. Los tiempos de petición incluyen procesamiento de contexto, generación y comunicación local y se solapan con el runner: sumarlos duplicaría el recuento.
Qwen tiene tiempos de espera agotados y una petición interrumpida sin recuento final de tokens. Los registrados son, por tanto, un límite inferior, tanto en la baseline como en las correcciones. Durante estas, las nuevas entradas y lecturas de caché fueron respectivamente 849.146 y cero para Qwen, 18.149 y 76.388 para Ornith, 863.073 y 1.108.820 para LFM. Son recuentos repetidos por petición, no corpus de palabras únicas. Los tokenizadores y backends difieren.
La medida API de tokens de razonamiento separados está no disponible, indicada como NA. El cero normalizado de Pi no demuestra ausencia de razonamiento. Para LFM se conservaron 84 bloques thinking emitidos, cuyo texto se retokenizó en 87.101 tokens: una medida derivada de parte de la salida, que no debe sumarse al total ni llamarse acceso al pensamiento interno. No hay una medida fiable de los segundos dedicados al razonamiento.
Tampoco se midieron los tokens del coordinador ni el coste del generador de imágenes. No deduzco de estas cifras un coste económico, energético ni total del sistema.
Después de la prueba desinstalé LFM: unos 13,59 GB de pesos y archivos de arranque eliminados. El archivo del experimento permanece intacto.
Qué hace verificable esta prueba
Al final se volvió a ejecutar la misma batería congelada sobre las 19 versiones conservadas: tres baselines y dieciséis correcciones. Los 190 veredictos individuales coinciden con las puntuaciones canónicas. Esta reevaluación comprueba la coherencia de los artefactos tras corregir al evaluador; no añade réplicas de inferencia.
El protocolo de corrección se escribió tras ver las baselines. Las adaptaciones posteriores están en las enmiendas. El orden no fue aleatorio; los errores iniciales eran distintos; las ayudas llegaron a ser muy diferentes, especialmente para LFM. Caché, backends y actividad del sistema no eran idénticos ni estaban aislados. El coordinador operativo era una IA, no un juez humano independiente. El juicio estético posterior es mío.
Con una trayectoria por checkpoint y un solo portfolio, los datos describen un caso. No permiten una clasificación universal, una estimación estadística de la probabilidad de éxito ni una explicación causal del efecto del thinking. Las pruebas eran conocidas y los comentarios las abordaban: llegar a diez de diez mide la corrección de esa tarea.
Me llevo un criterio concreto para mi trabajo: verificar los gestos prometidos, observar la página incluso después de la puntuación y contar la asistencia necesaria. La decisión de usar un resultado queda abierta al juicio de quien vaya a utilizarlo.
Datos, fuentes y procedencia
- Datos por iteración, CSV, resultados JSON y resumen JSON.
- Protocolo de corrección, junto a las enmiendas, los roles y el juicio estético.
- Índice de evidencias y acciones, URL y viewports de las capturas editoriales. Las verificaciones históricas están en el paquete de materiales; no son nuevas inferencias. Algunas marcas periféricas pertenecen al navegador o a extensiones.
- Qwen, repositorio en la revisión probada, Ornith, identificación fijada del mismo modo, LFM, ficha de cuantización.
El paquete público reúne datos, documentos de método, verificaciones e imágenes seleccionadas. El manifiesto SHA256 permite comprobar los archivos descargados. Se eliminaron rutas y URL locales de las copias documentales; los rásteres originales se conservan sin retoques. El juicio estético posterior sigue separado de las puntuaciones funcionales.