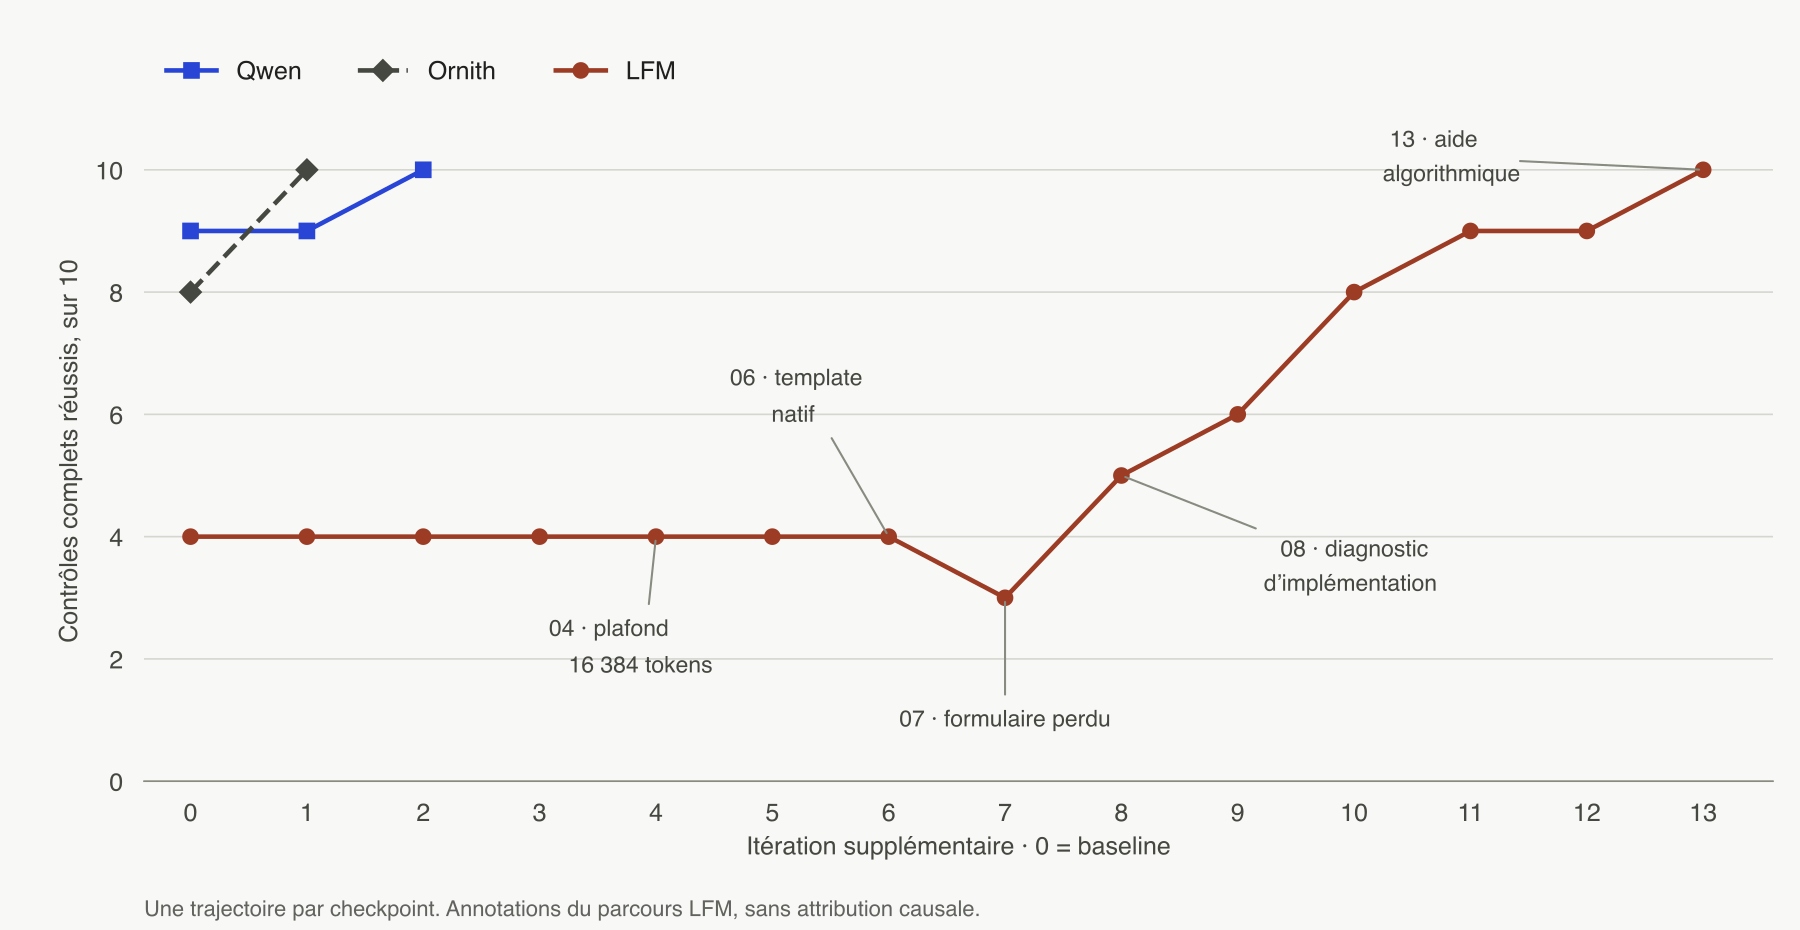
J’ai demandé à trois modèles locaux de construire le même portfolio. Tous ont fini par réussir dix contrôles fonctionnels. Mon jugement sur les sites est resté très différent : Qwen le meilleur sur le plan esthétique, Ornith très bon, LFM rejeté. Après l’essai, j’ai désinstallé LFM.
L’écart entre ces deux évaluations justifie de regarder le travail de près. Un filtre peut fonctionner dans une page peu convaincante. Une composition réussie peut cacher quatre fiches impossibles à ouvrir. Le temps nécessaire pour aboutir dépend aussi de l’aide que nous sommes prêts à apporter.
Voici le récit d’un essai réalisé sur mon Mac les 23 et 24 octobre 2026 : une tâche, un parcours documenté pour chacune des trois configurations testées. Fichiers, étapes ratées et corrections ont été conservés. Les images montrent ce qui a changé ; les logs vérifient ce qu’une capture ne peut démontrer.
Un portfolio fictif, des demandes concrètes
Nora Valli est une designer imaginaire. Les projets le sont aussi : Trame et Luce lenta pour l’éditorial, Soglia et Orto urbano pour le branding, Atlante et Marea pour le numérique. Noms, catégories et années étaient fixés par le brief. Les modèles pouvaient rédiger les descriptions.
Le brief exigeait trois fichiers fonctionnels, HTML, CSS et JavaScript, sans framework, CDN ni police distante. Recherche et filtres devaient se combiner, le compteur suivre les résultats et l’état vide apparaître au bon moment. Chaque projet devait ouvrir un détail cohérent, avec fermeture, Échap et gestion du focus. Il fallait aussi un thème persistant, une présentation, un formulaire de démonstration et une mise en page sans débordement à 390 et 1440 pixels.
Pour la première version, chaque modèle pouvait demander une seule image au même générateur externe. Il choisissait le prompt et l’emplacement du fichier reçu. Les pixels venaient de ce service : les attribuer au modèle local confondrait deux travaux différents. Les trois fichiers image sont restés inchangés pendant les corrections, comme le confirme la comparaison de leurs empreintes.
Un assistant d’IA coordonnait l’essai : il a préparé outils et contrôles, rédigé les retours et, dans les phases avancées de LFM, fourni diagnostics et indications algorithmiques. Les modèles locaux ont écrit et modifié les fichiers par des outils contrôlés ; sans navigateur ni shell, ils ne voyaient pas les concurrents. Aucune correction manuelle n’a été appliquée aux portfolios.
L’accès aux fichiers passait par Pi, un agent de programmation reliant les réponses des modèles aux outils de lecture et d’écriture. Les modèles tournaient avec MLX, un framework de calcul sur Apple Silicon, via les deux backends de la fiche technique. Ce logiciel organise et exécute l’essai ; les pages étaient vérifiées séparément dans le navigateur.
Le Mac et l’environnement de l’essai
| Composant | Configuration de la machine utilisée |
|---|---|
| Ordinateur | MacBook Pro 16 pouces, 2026 ; identifiant Mac17,8 |
| Processeur | Apple M5 Pro |
| CPU | 18 cœurs : 6 super cœurs et 12 cœurs de performance |
| GPU | 20 cœurs |
| RAM | 48 Go de mémoire unifiée ; le système relève 51 539 607 552 octets, soit 48 Gio |
| Bande passante mémoire | 307 Go/s nominaux selon Apple ; non mesurés dans cet essai |
| Neural Engine | 16 cœurs selon Apple ; son utilisation n’est pas mesurée par le benchmark |
| Système d’exploitation | macOS 27.0.1, build 26A434 |
| Alimentation | Branché sur secteur lors du relevé initial |
| Agent | Pi 1.2.0 |
| Runtime | Node 26.11.1 ; Python 3.15.0 pour les scripts de l’essai |
| Navigateur de vérification | Chrome 155.0.8059.85 |
| Backend Qwen | mlx-vlm 0.6.15, MLX 0.32.1 |
| Backend Ornith et LFM | mlx-lm 0.32.2, MLX 0.32.4 |
Puce, mémoire, alimentation, système et GPU figurent dans les logs. Le modèle précis du Mac et le détail des cœurs CPU ont été ajoutés par un inventaire local ultérieur, toujours le 24 octobre : aucun numéro de série ni UUID n’est inclus. L’identifiant correspond au MacBook Pro 16 pouces de 2026 ; les noms des cœurs et les valeurs nominales viennent des spécifications Apple.
Les modèles ont tourné un par un. Le Mac effectuait aussi d’autres tâches : sa charge n’était pas isolée. La capacité physique du SSD, la consommation énergétique et les performances thermiques n’ont pas été mesurées. La bande passante nominale ne doit pas être lue comme une vitesse de génération observée.
| Nom utilisé dans le récit | Checkpoint effectif | Révision |
|---|---|---|
| Qwen | orcarouter/Qwen3.8-27B-Uncensored-MLX, variante 4 bits | 34c32b5b1b2c24181e121a5cba3df8924fa66bce |
| Ornith | ornith-ai/Ornith-1.5-35B-A3B-MLX-4bit | 19504d912fa8fc7622bf6b1de3db5d5d890b1f02 |
| LFM | LiquidAI/LFM2.5-24B-A2B-MLX-4bit | 667408d494bde191c2cb9dd4f4549827816b9275 |
Ces versions précises des modèles, appelées checkpoints, identifient les configurations testées. Elles ne représentent pas de manière interchangeable des familles entières. Leur identité est vérifiée dans les fiches des dépôts aux révisions indiquées. Le nom communautaire de Qwen est conservé en entier : l’essai n’a pas évalué les capacités suggérées par « uncensored ».
Trois directions visuelles, avant les scores
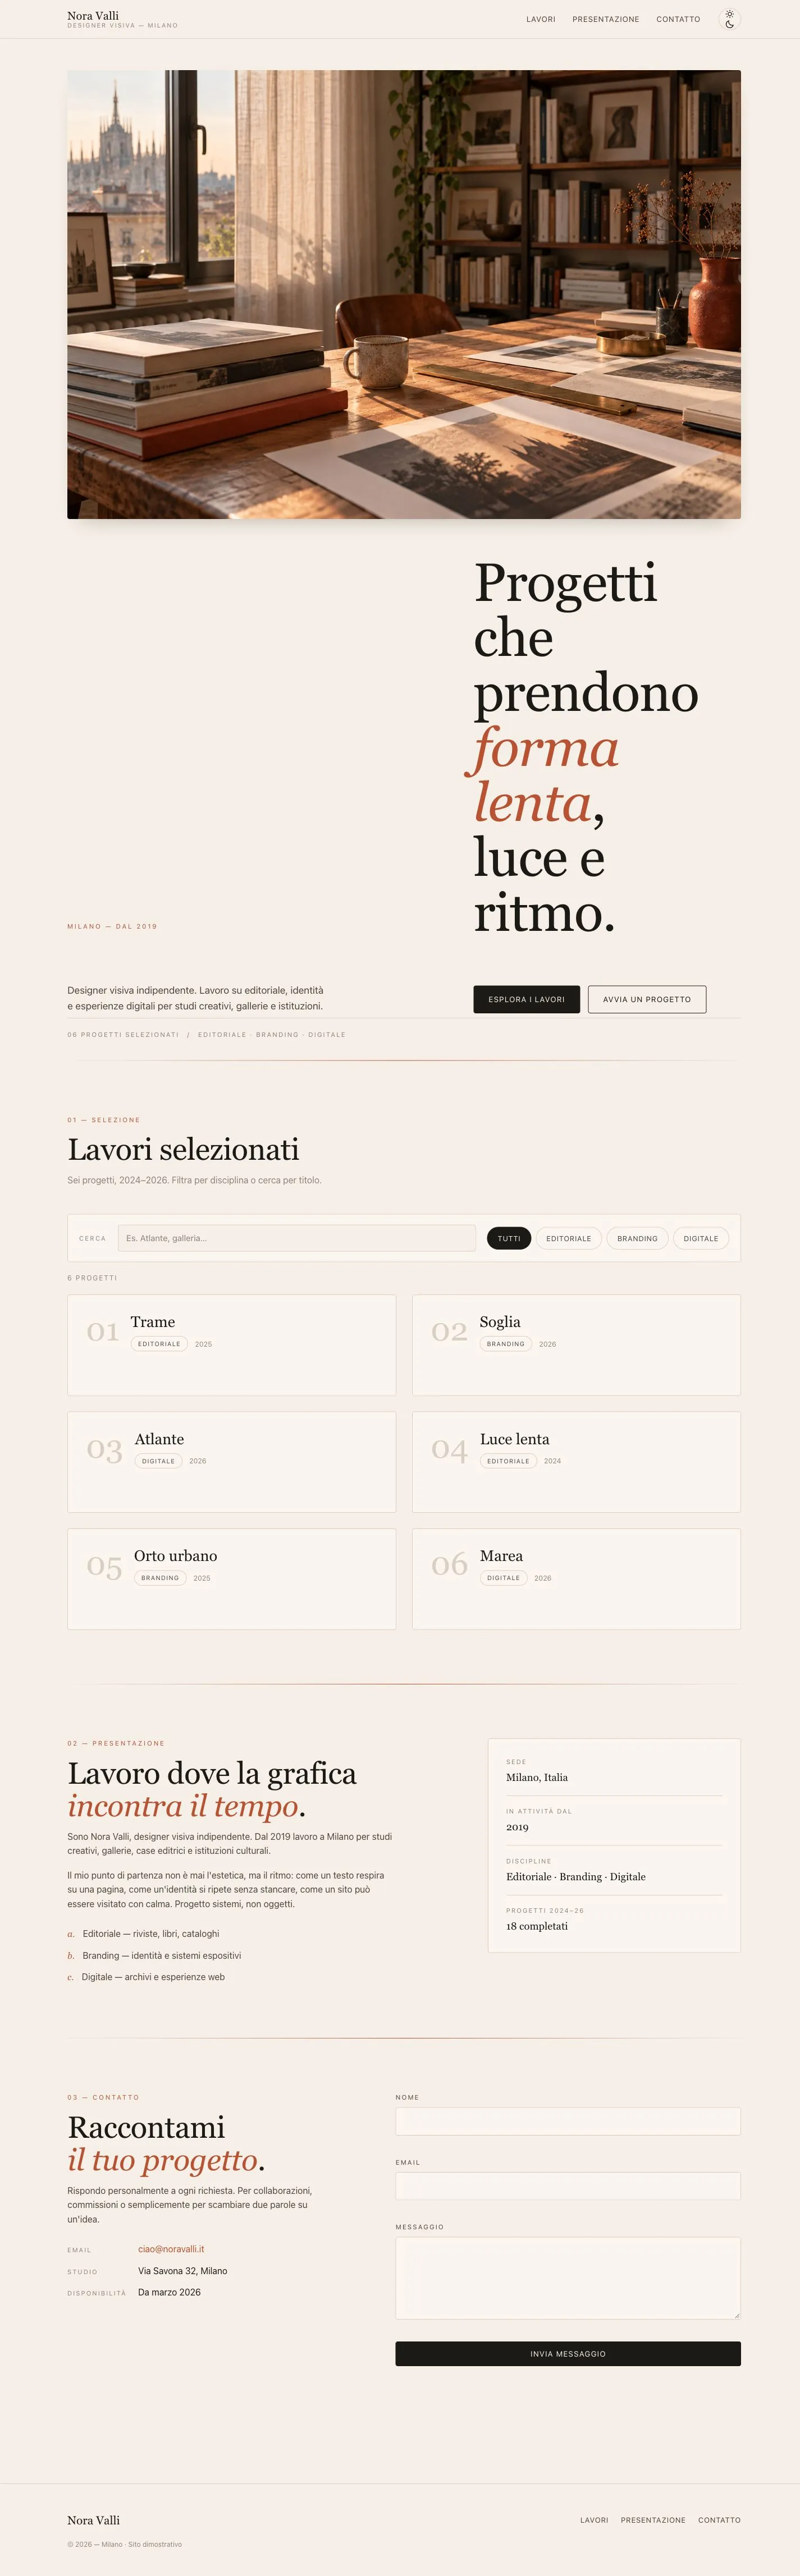
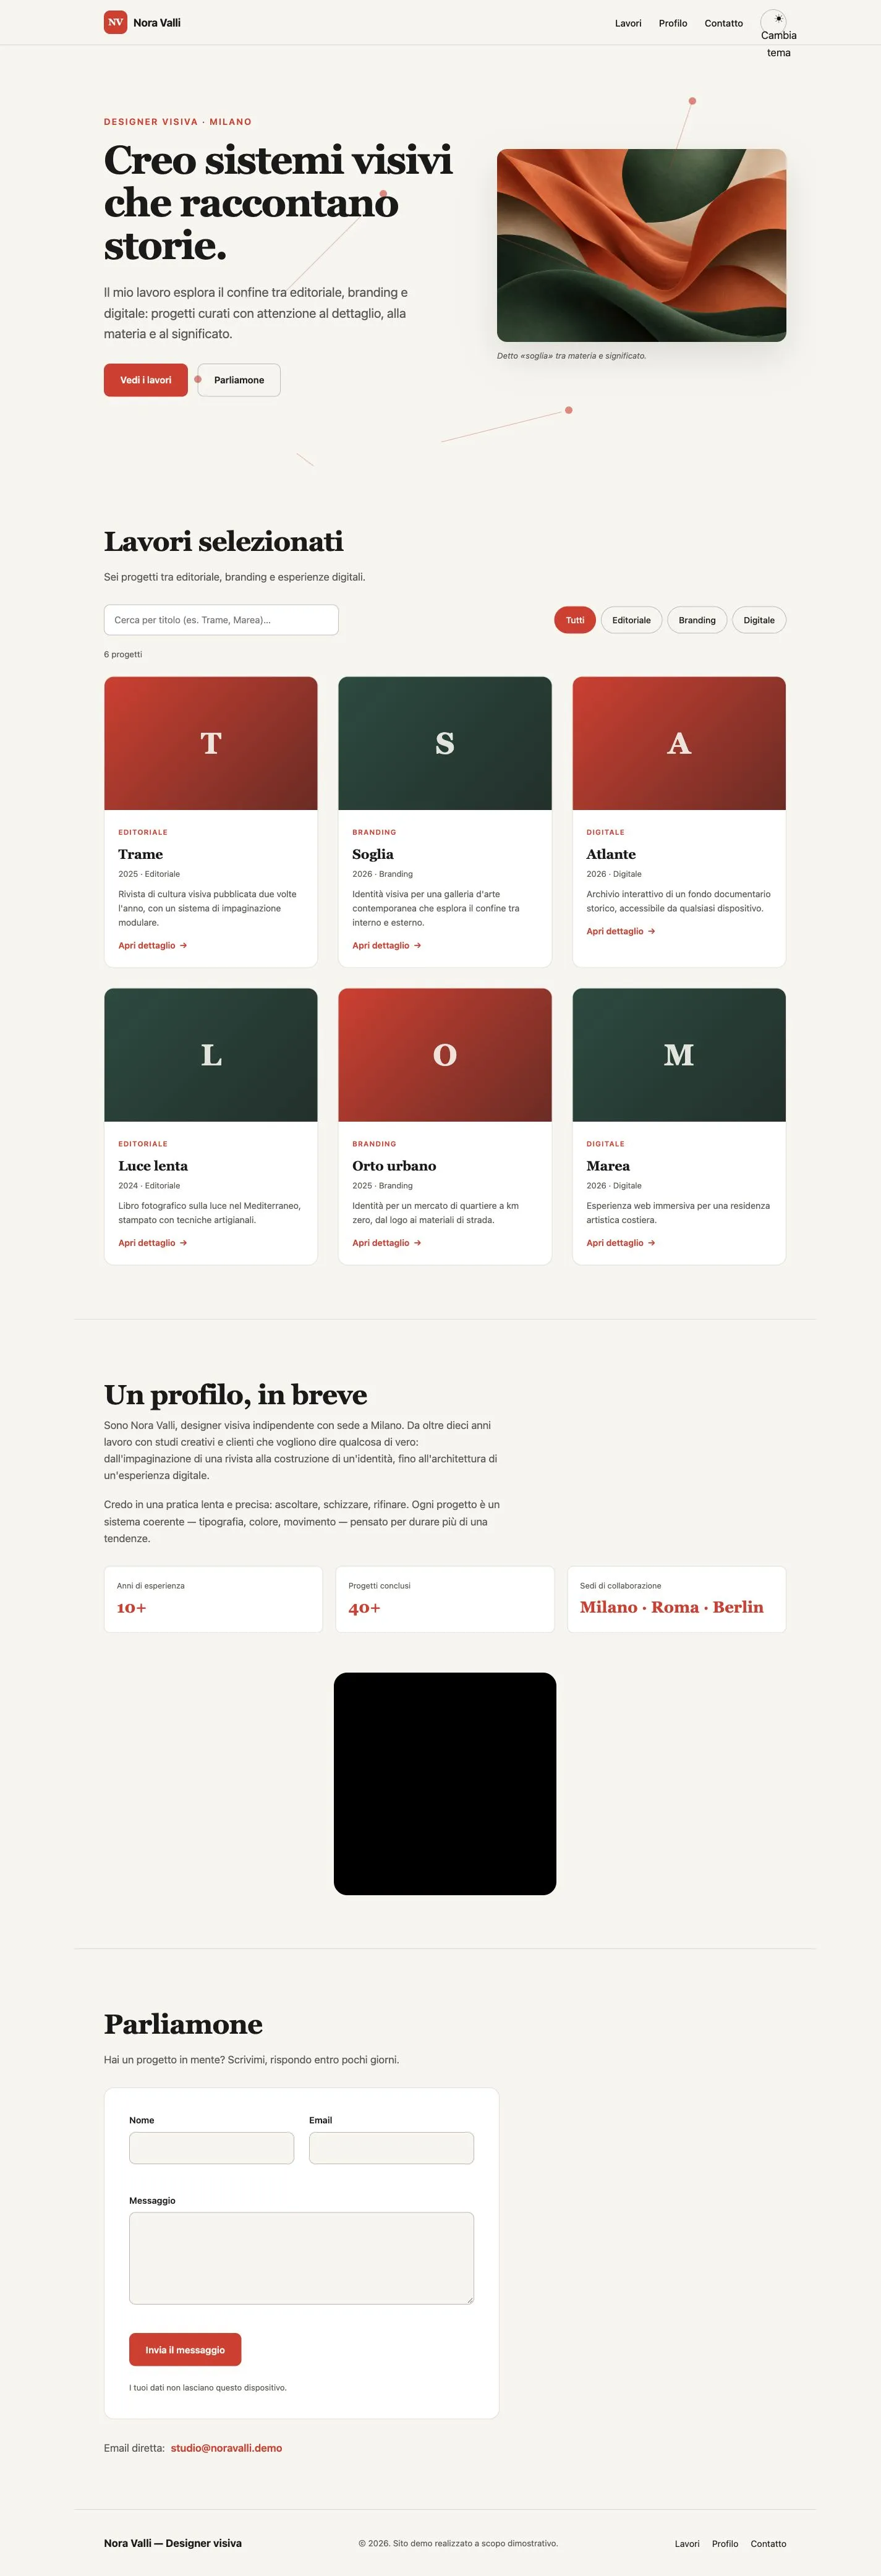
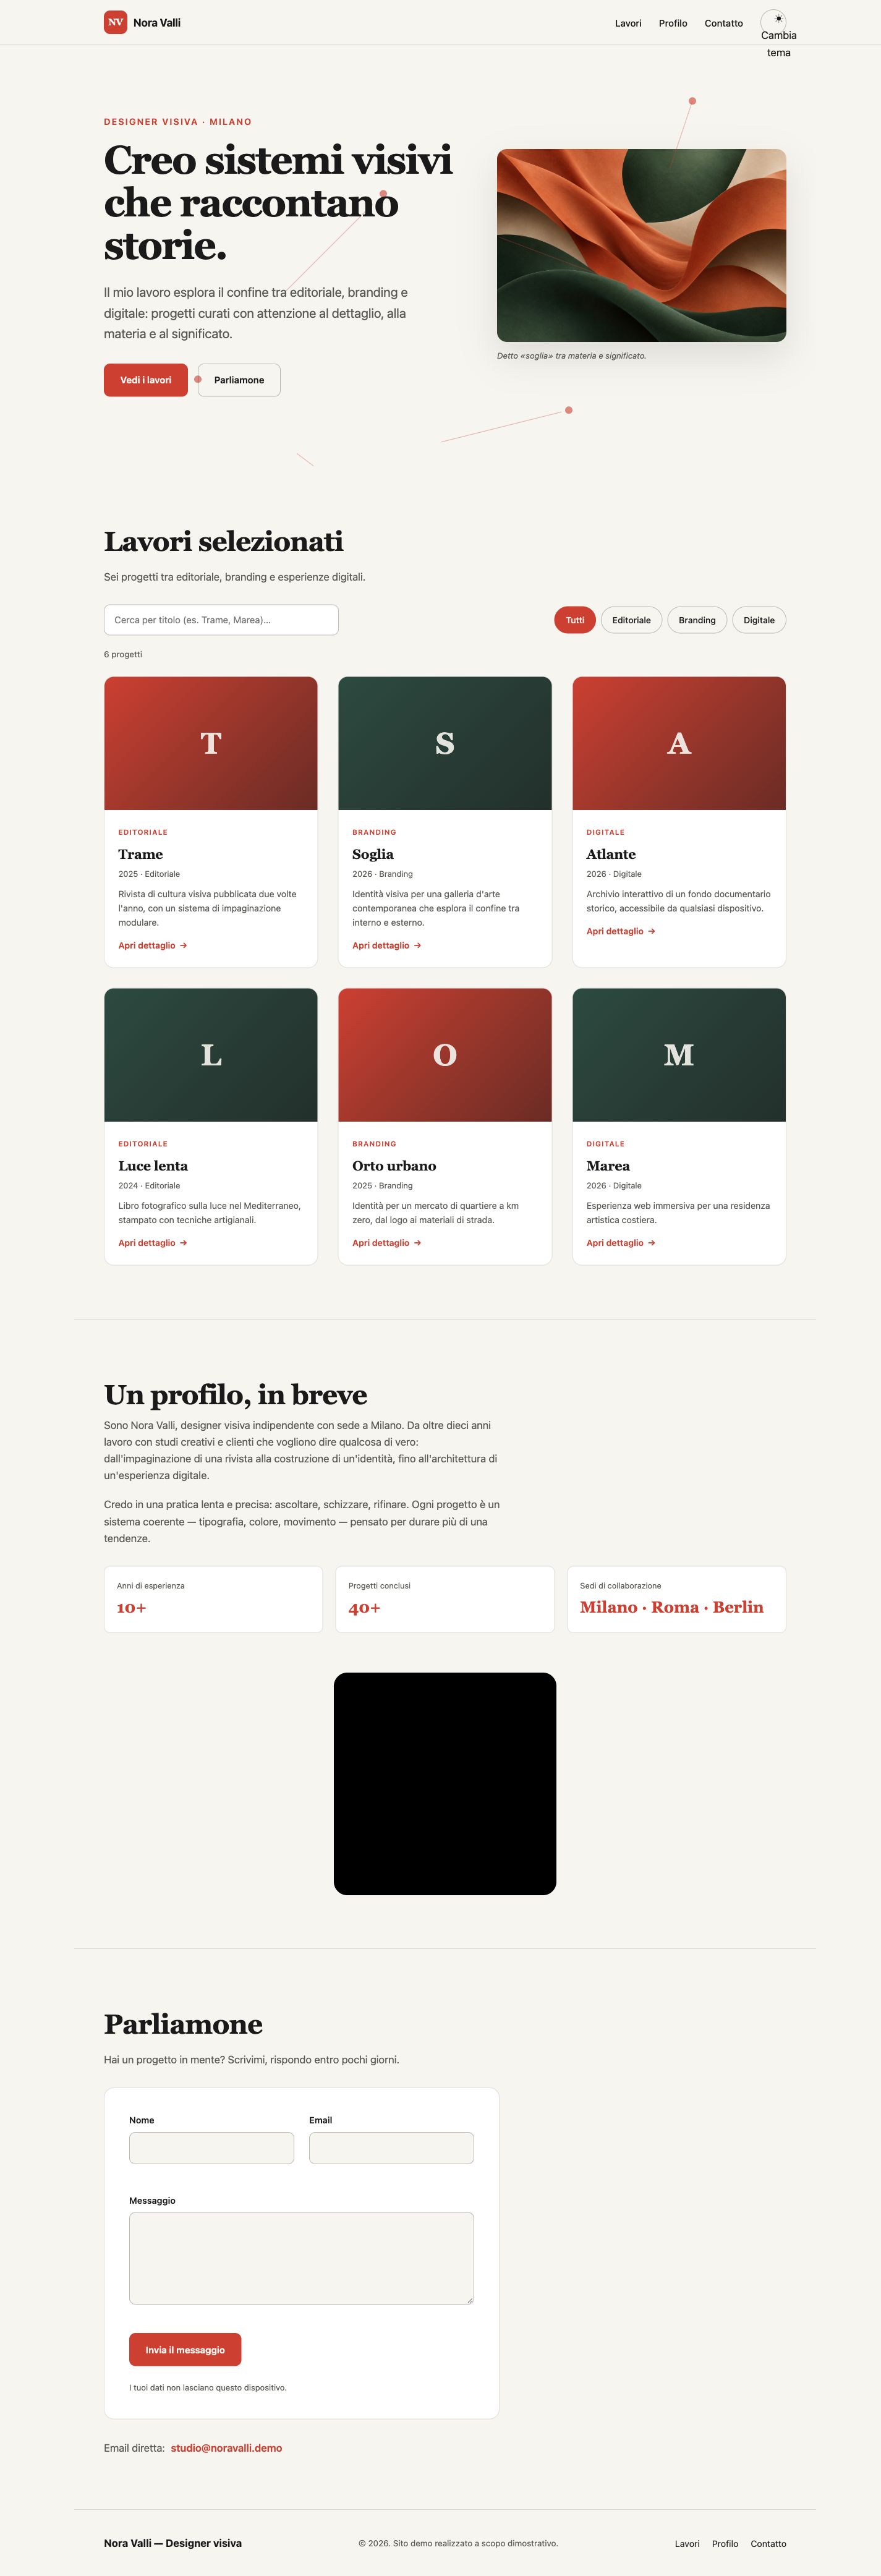
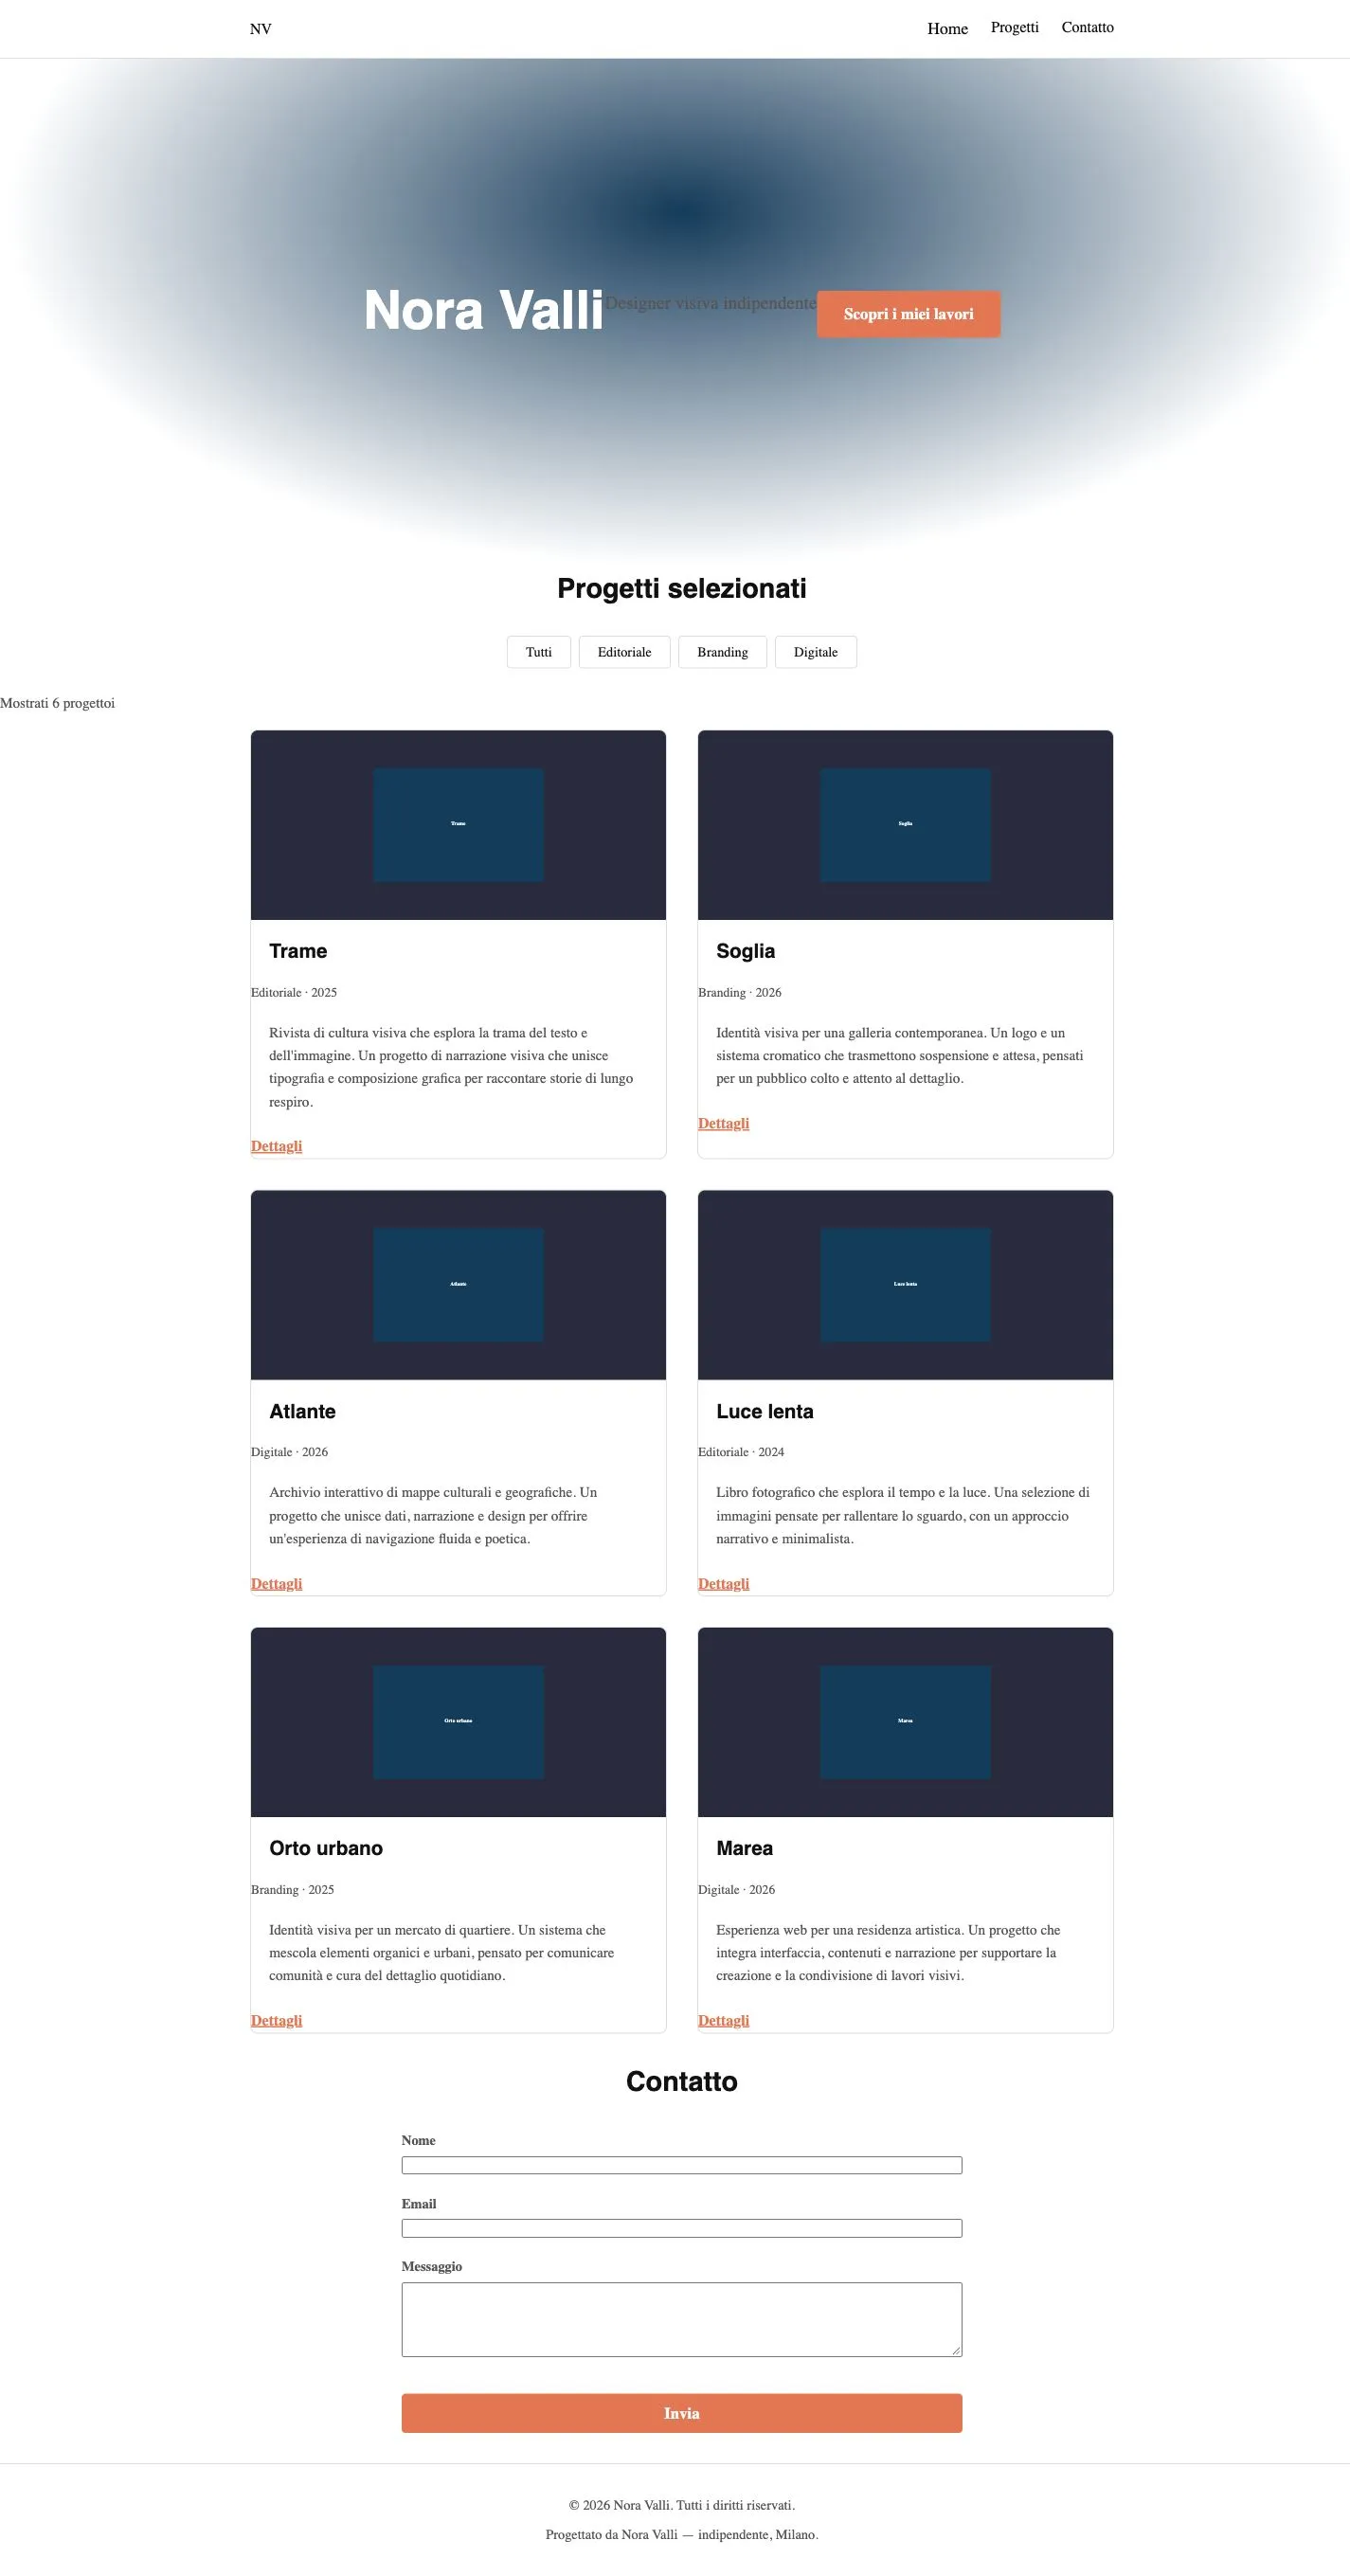
Qwen construit une page claire, avec une grande image du studio, des titres à empattements, des italiques terre et beaucoup d’espace. Ornith juxtapose titre et image, utilise des accents rouges et verts et classe les projets en fiches à grandes initiales. LFM présente un large bandeau bleu dégradé, avec un rapport peu résolu entre titre, texte et commande principale. Le fichier généré existe, mais n’est pas encore intégré dans la version initiale ; il apparaîtra pendant les corrections.
Mon ordre de préférence est Qwen, puis Ornith, puis LFM. C’est un jugement personnel déclaré, formulé après l’essai. Pour en explorer les raisons possibles, il faut comparer proportions, hiérarchies et intégration de l’image ; le nombre de contrôles réussis répond à une autre question.
Toutes les captures ci-dessous sont des reproductions éditoriales ultérieures des artefacts conservés, sans modification ni nouvelle inférence. La baseline est la première version, aussi appelée itération 0. Le viewport de bureau est de 1440×900 ; une image de page entière peut dépasser 900 pixels de haut. Chaque image renvoie au fichier original agrandissable.
Derrière une bonne première impression
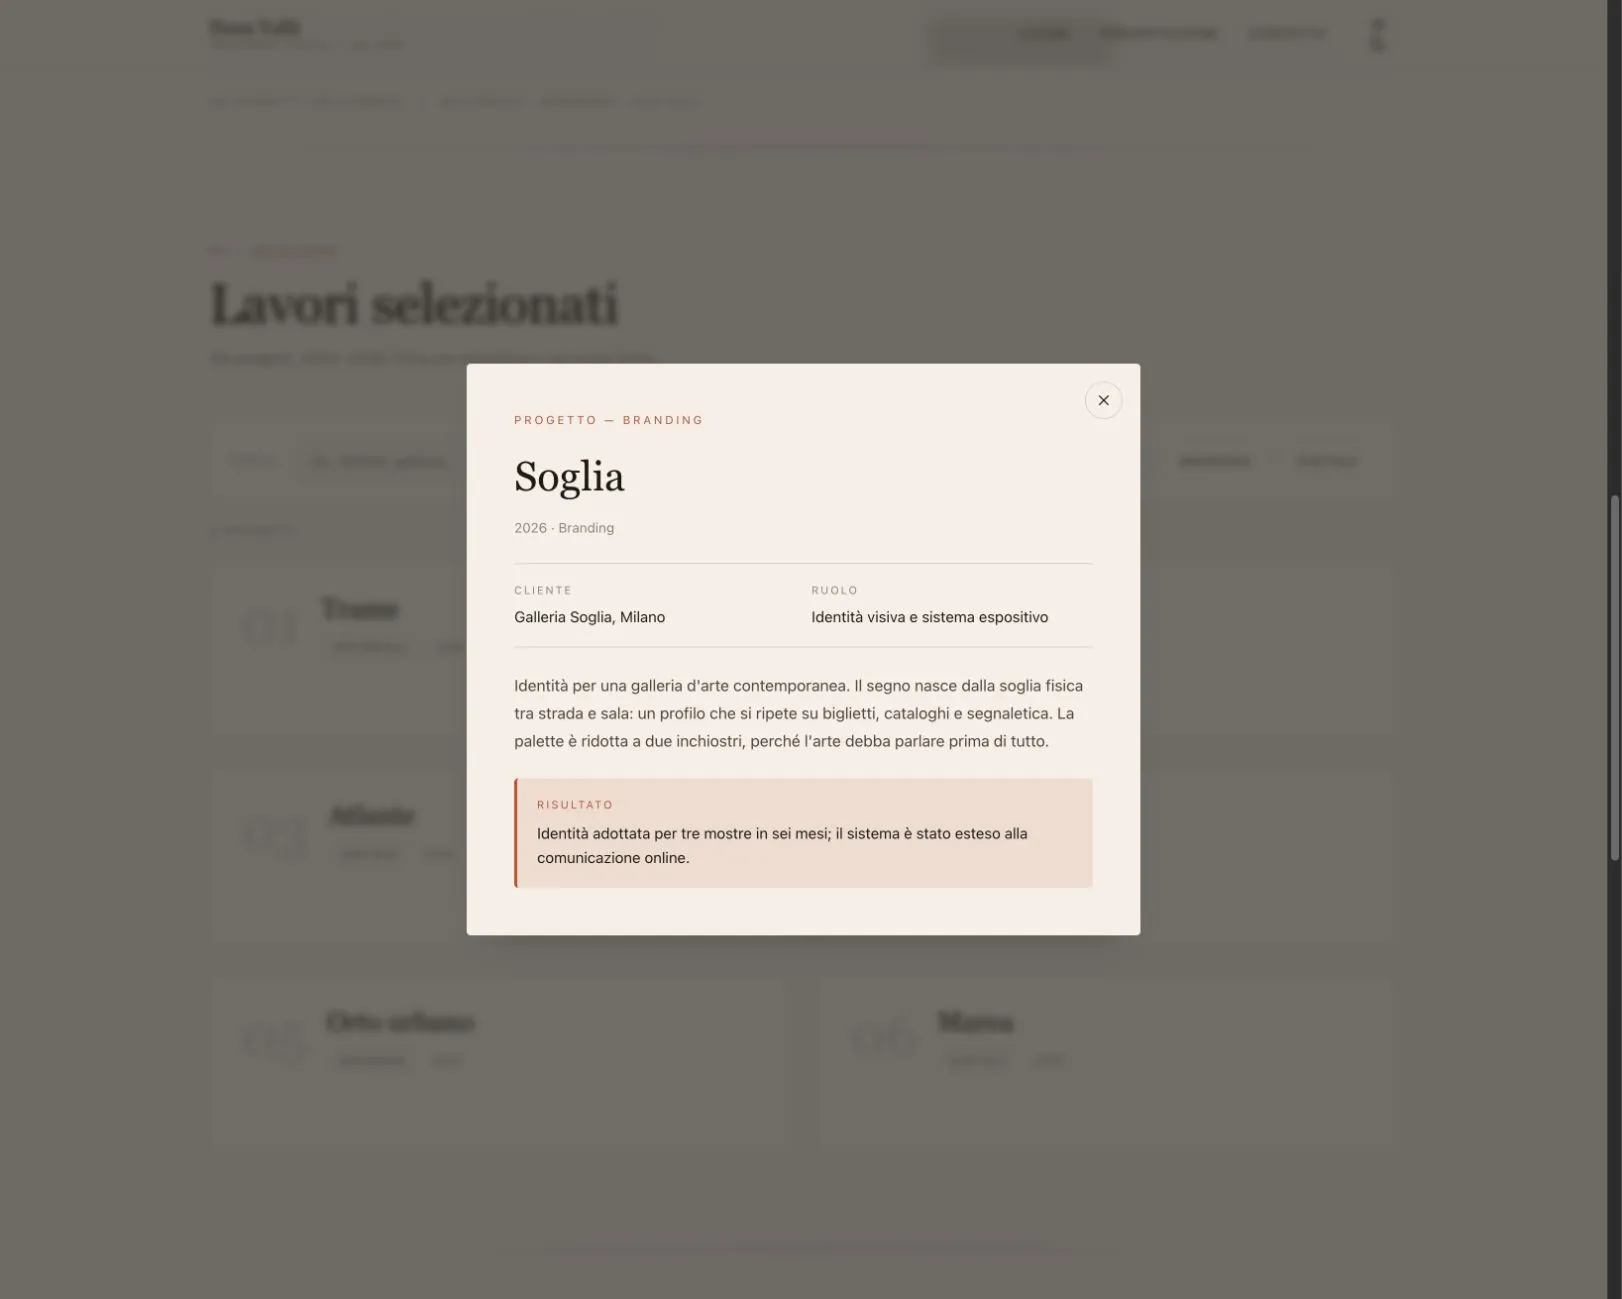
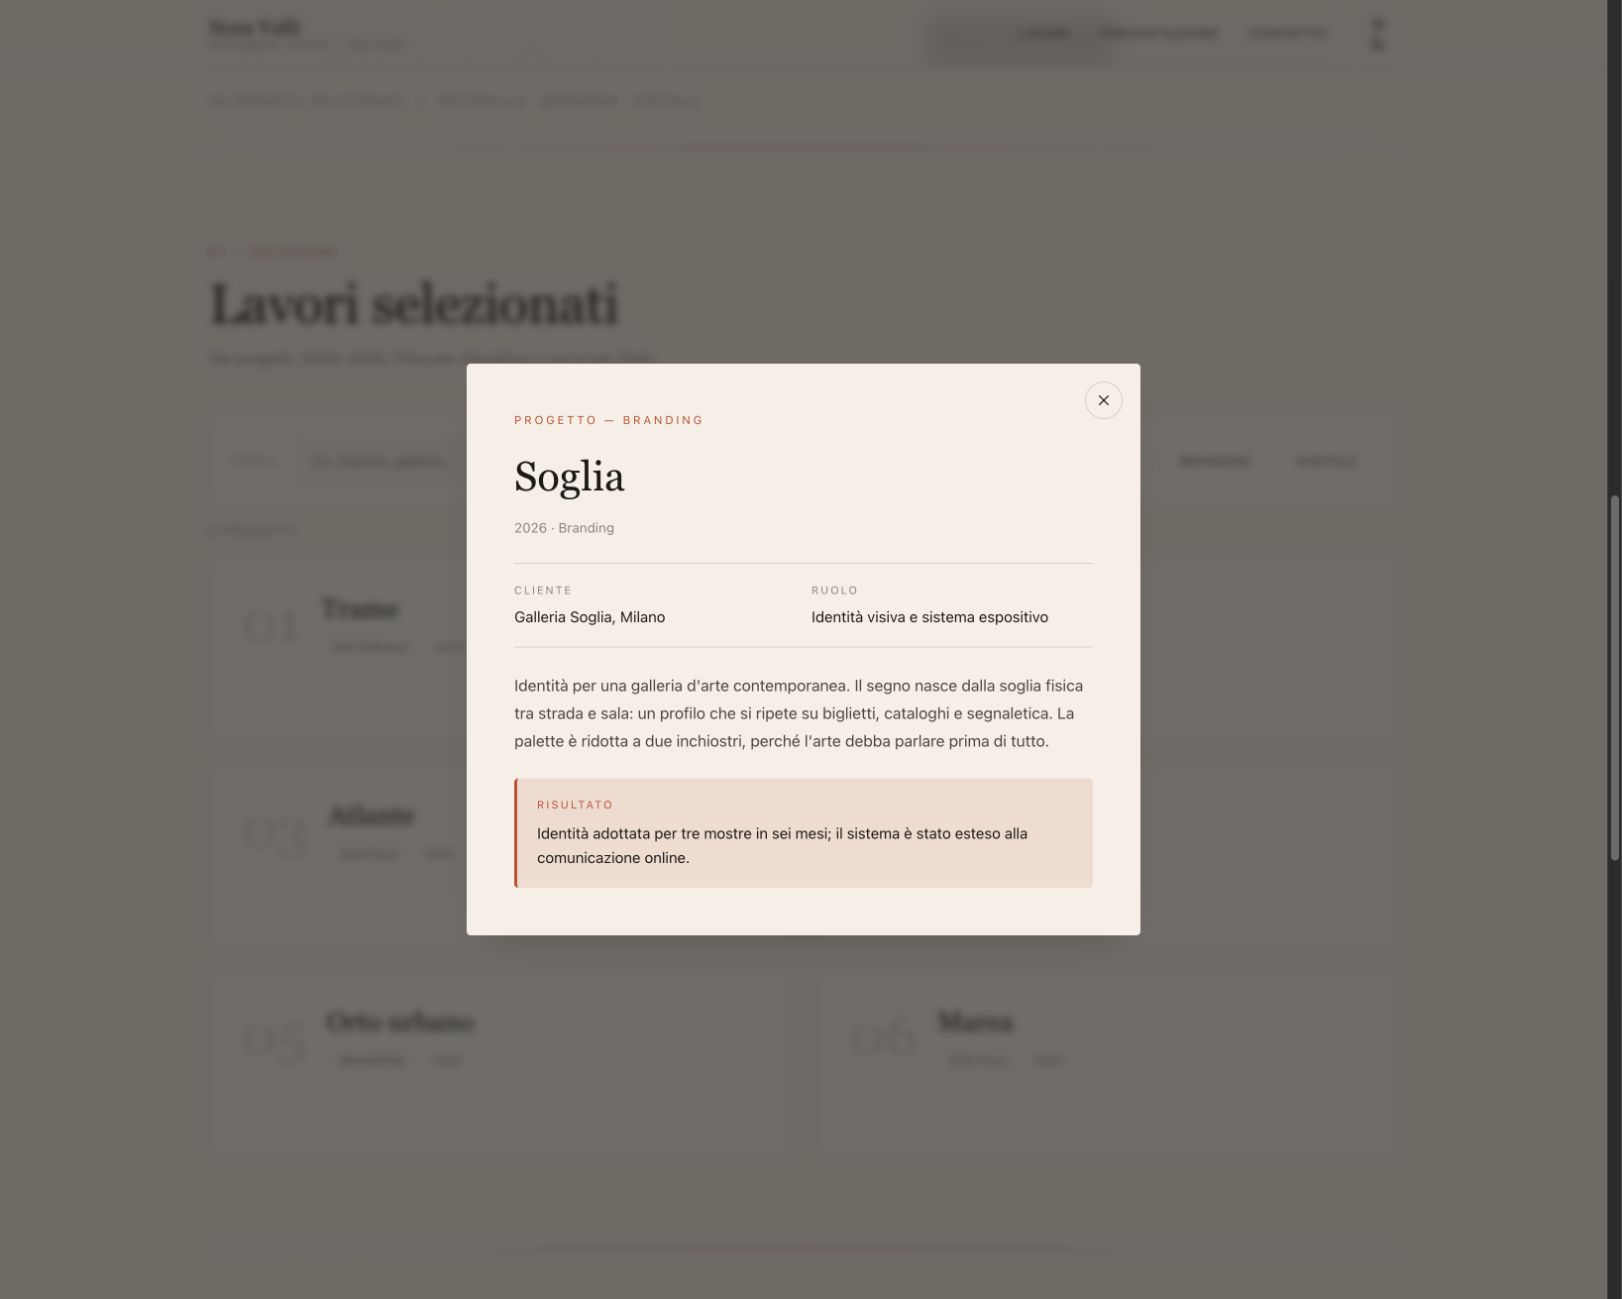
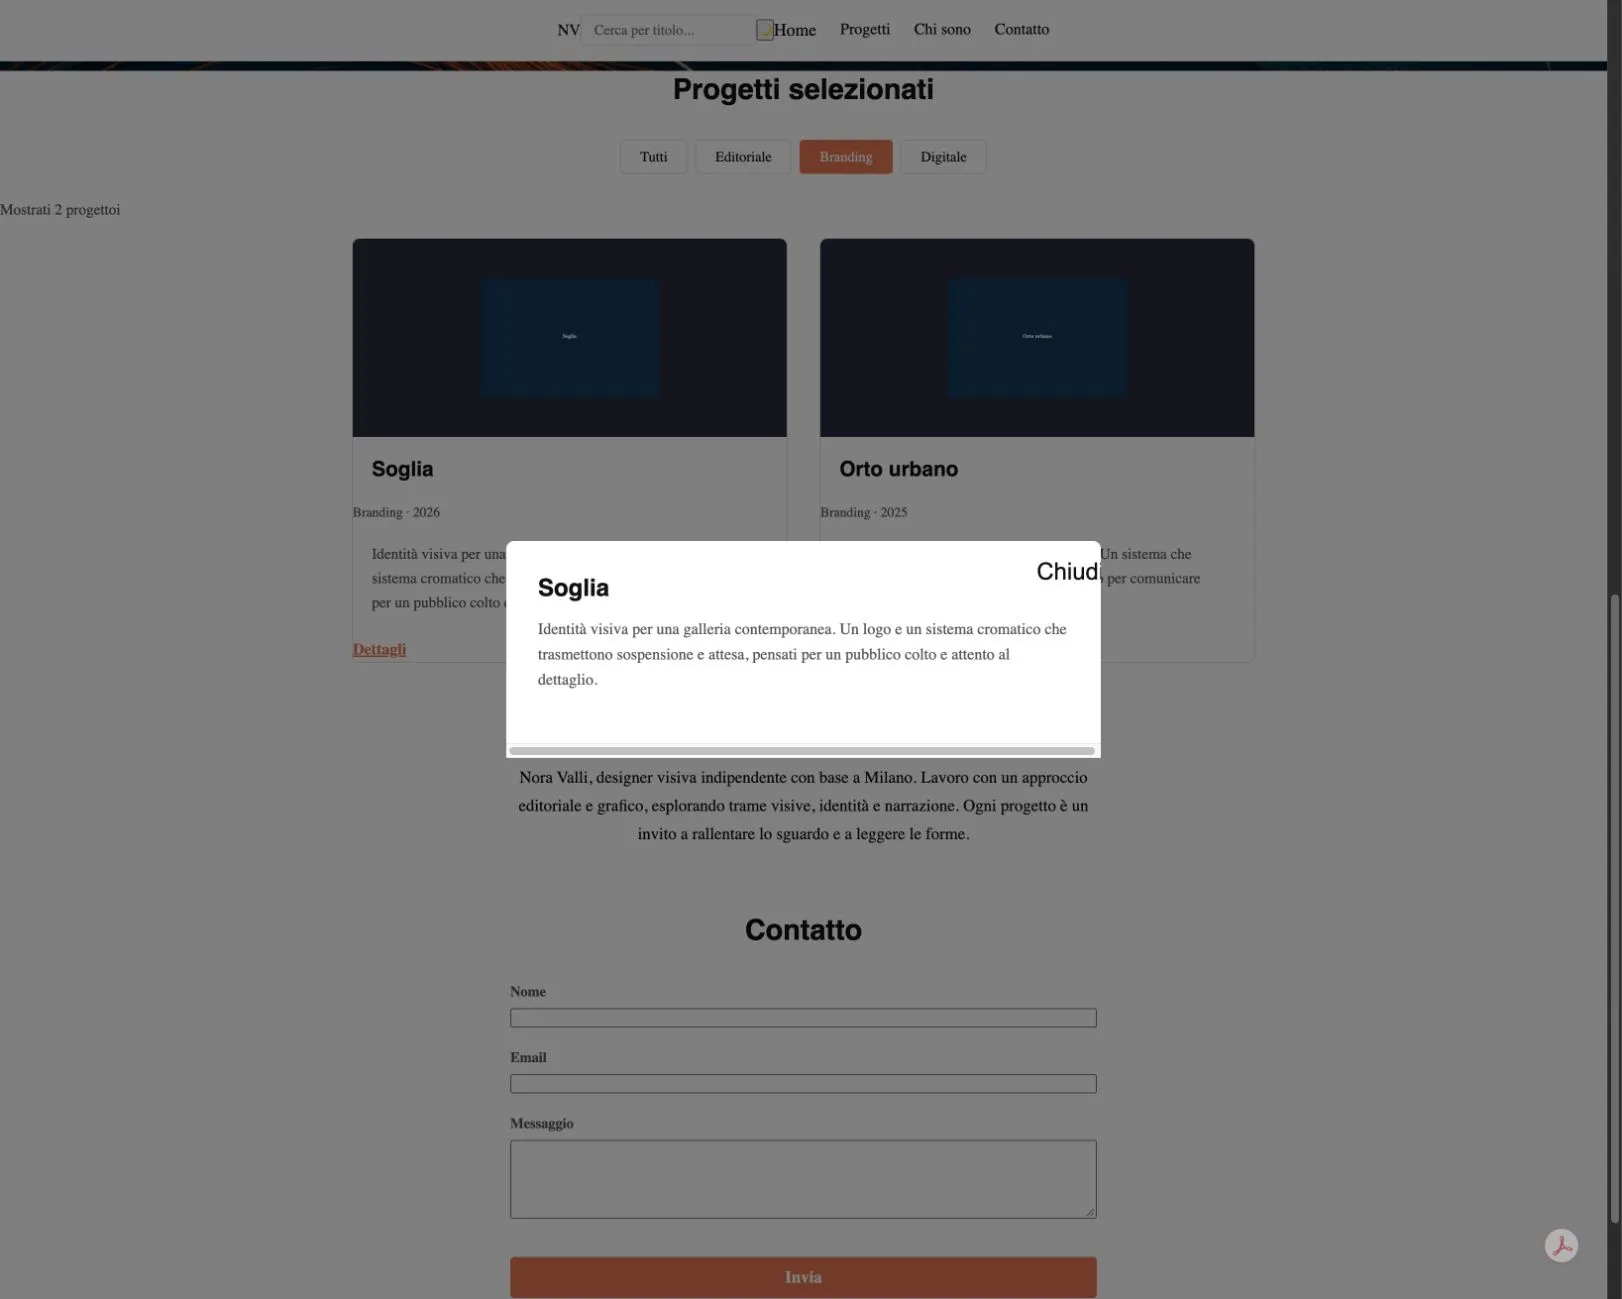
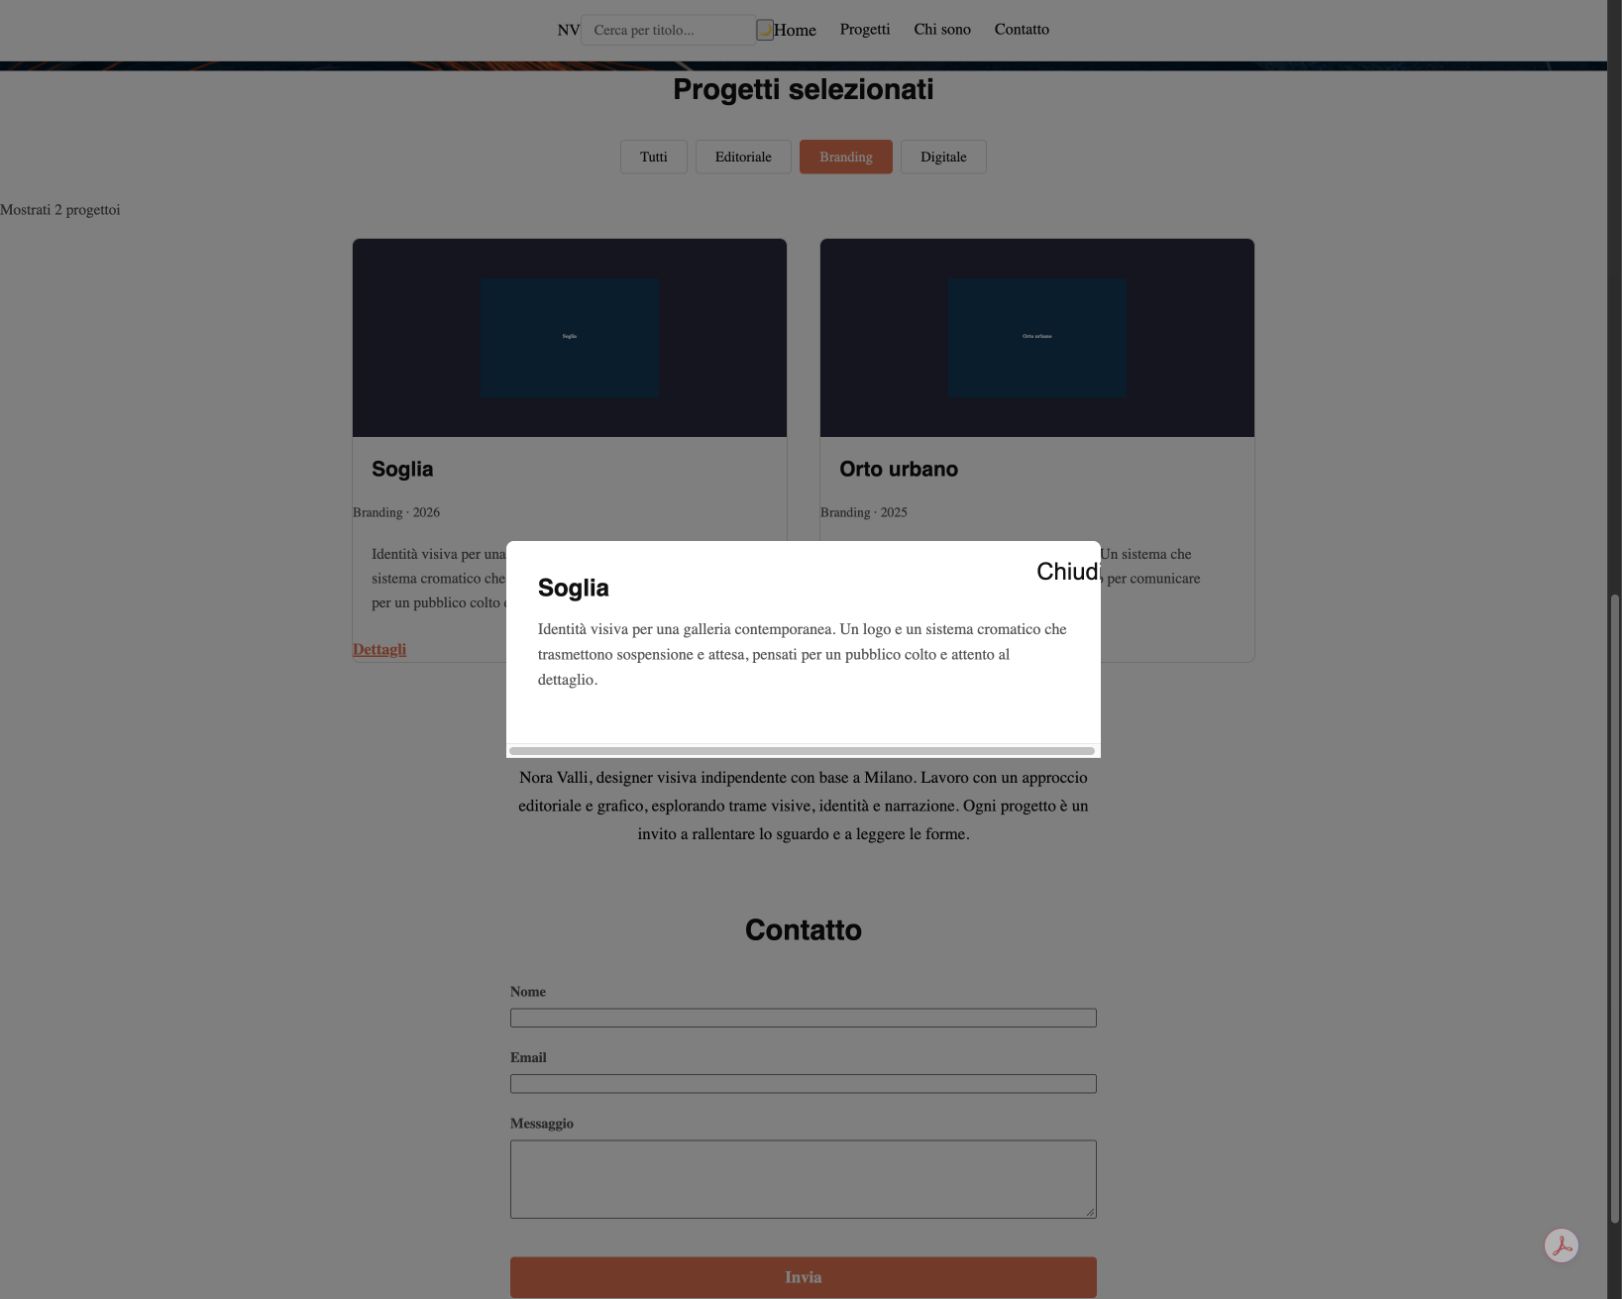
Qwen partait de neuf contrôles complets et d’un partiel. Le problème concernait les détails des projets : quatre dialogues sur six ne fonctionnaient pas. Cliquer sur Soglia laissait la page affichée sans ouvrir le contenu demandé.
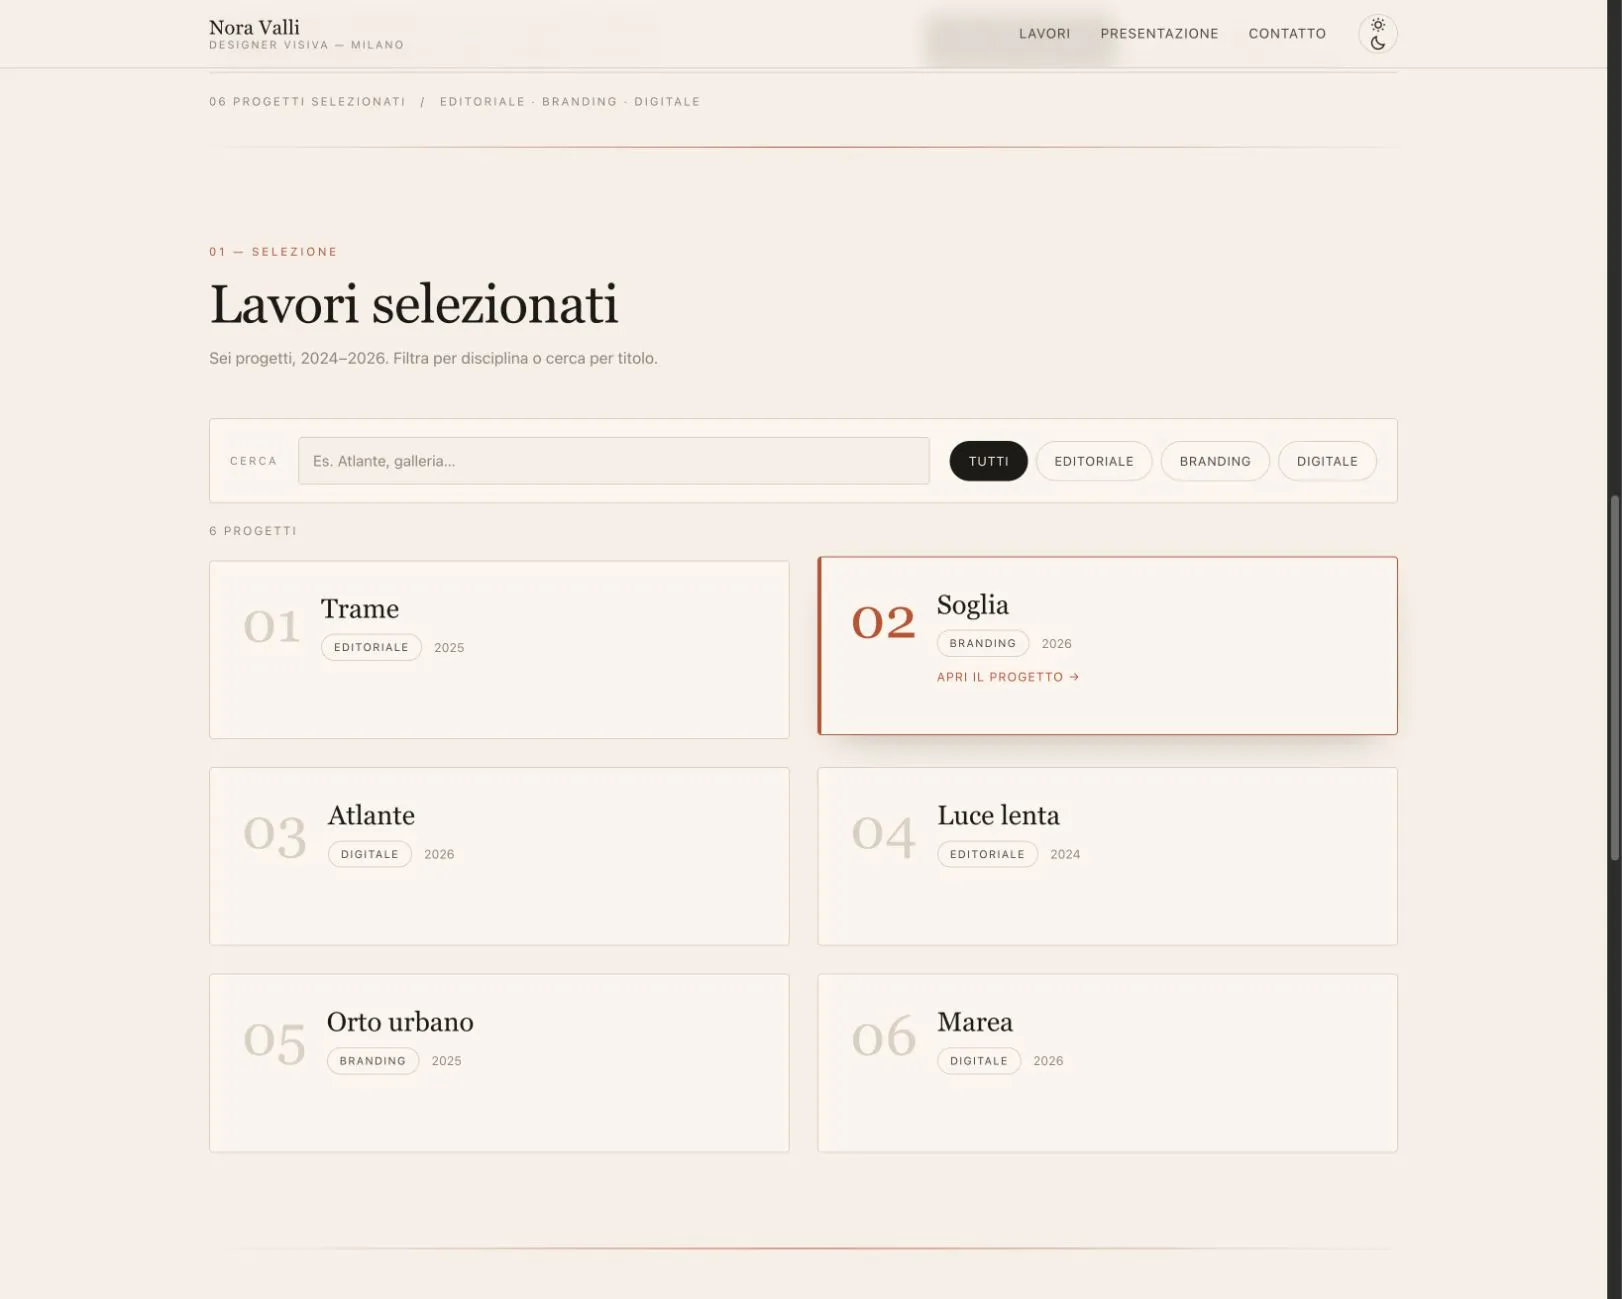
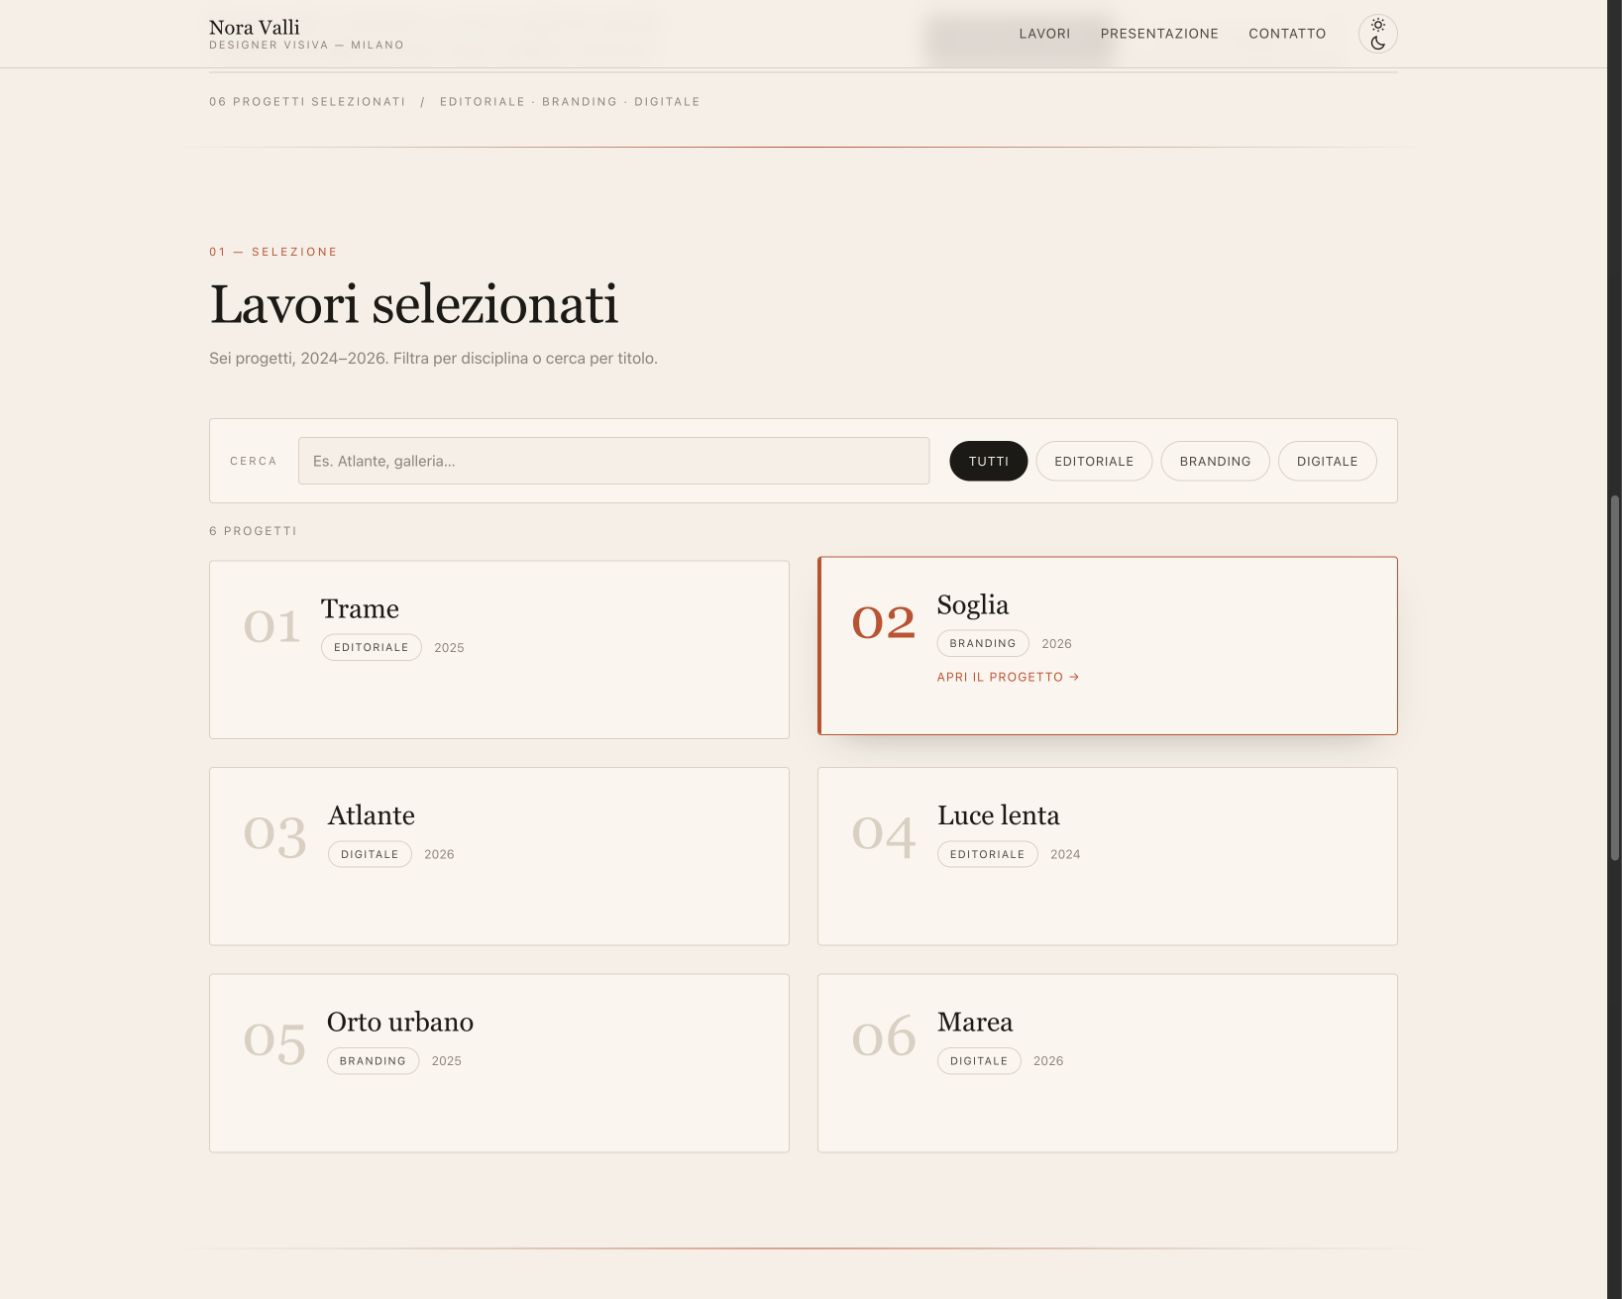
Après deux itérations supplémentaires, la même action ouvre un détail avec titre, année, rôle et description. La solution ajoute un fallback JavaScript : les données sont récupérées même lorsque les attributs HTML d’origine contenant du JSON sont tronqués. Le comportement demandé passe ; le balisage malformé reste à corriger avant un usage réel.
Ornith partait de huit contrôles complets. Le filtre Branding changeait d’apparence, mais laissait les six projets visibles. La commande annonçait une sélection que la collection ne respectait pas.
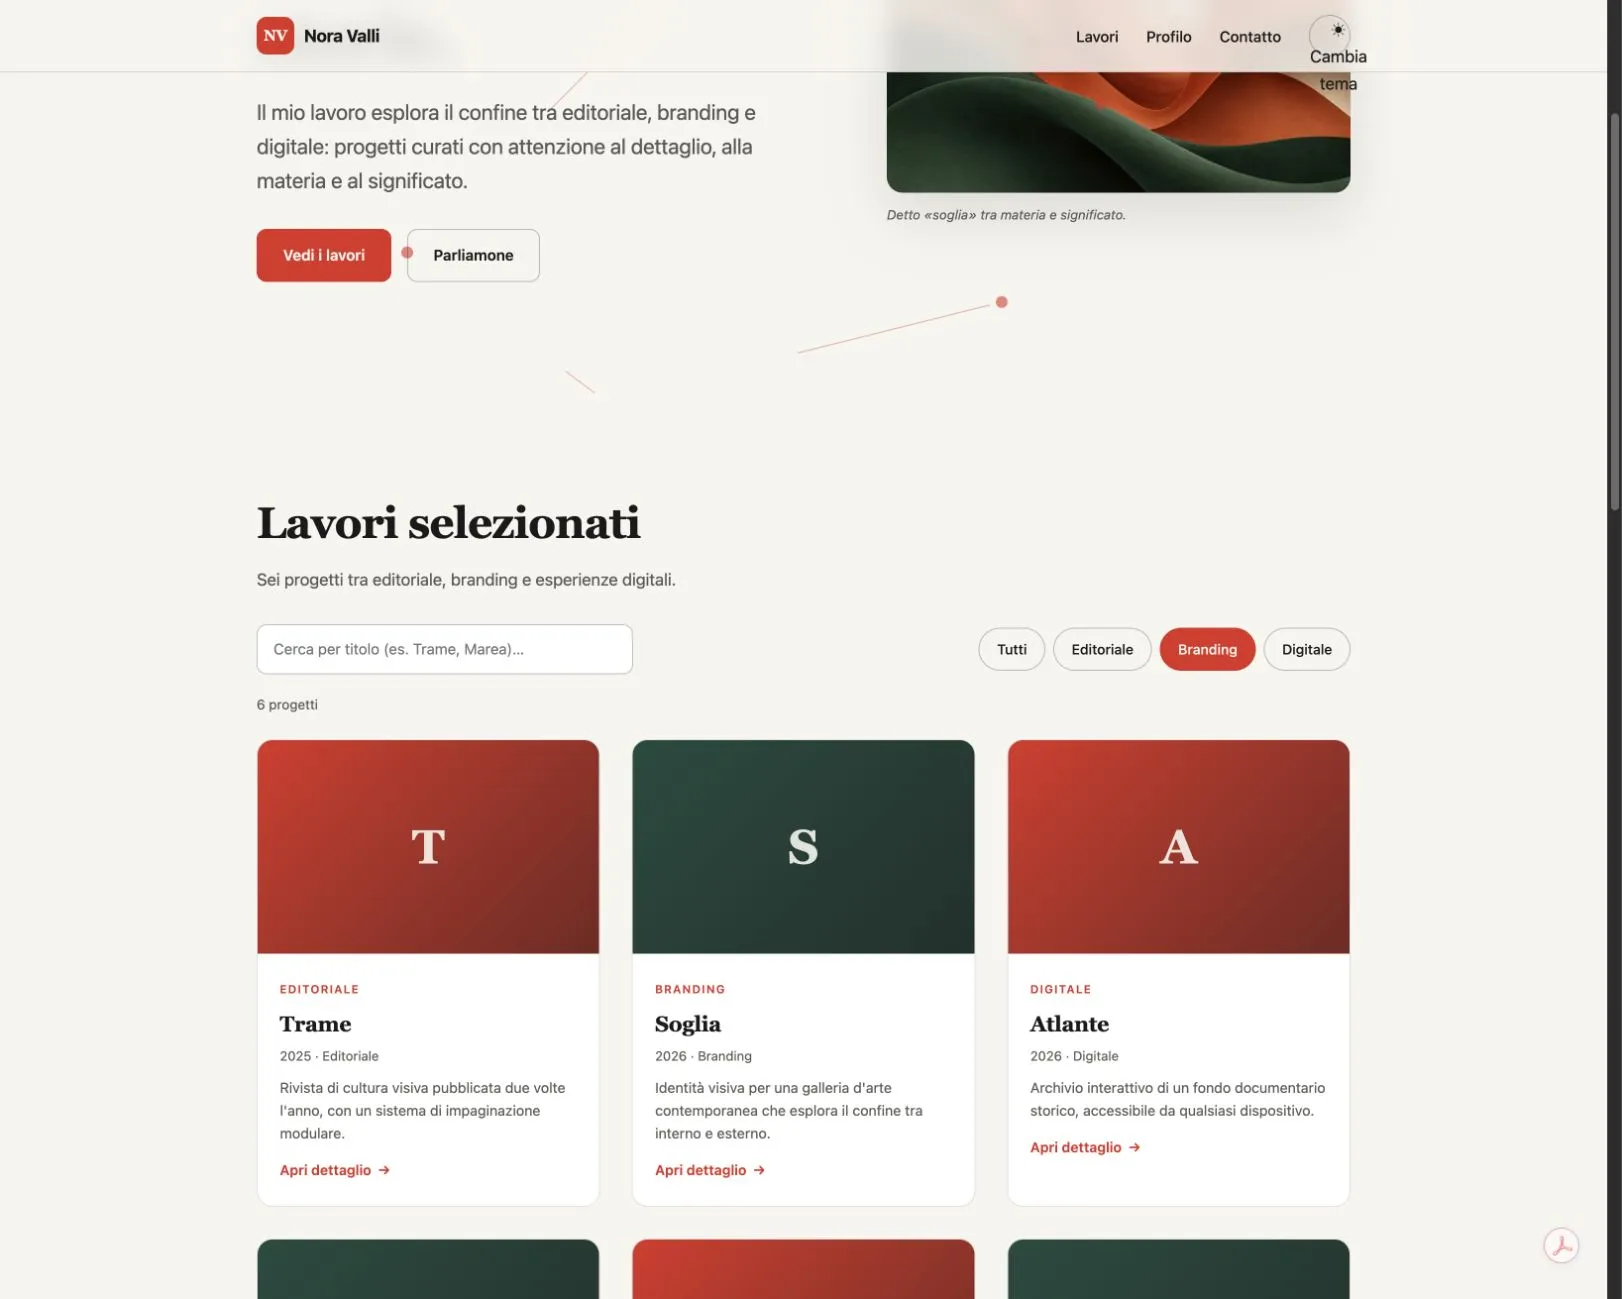
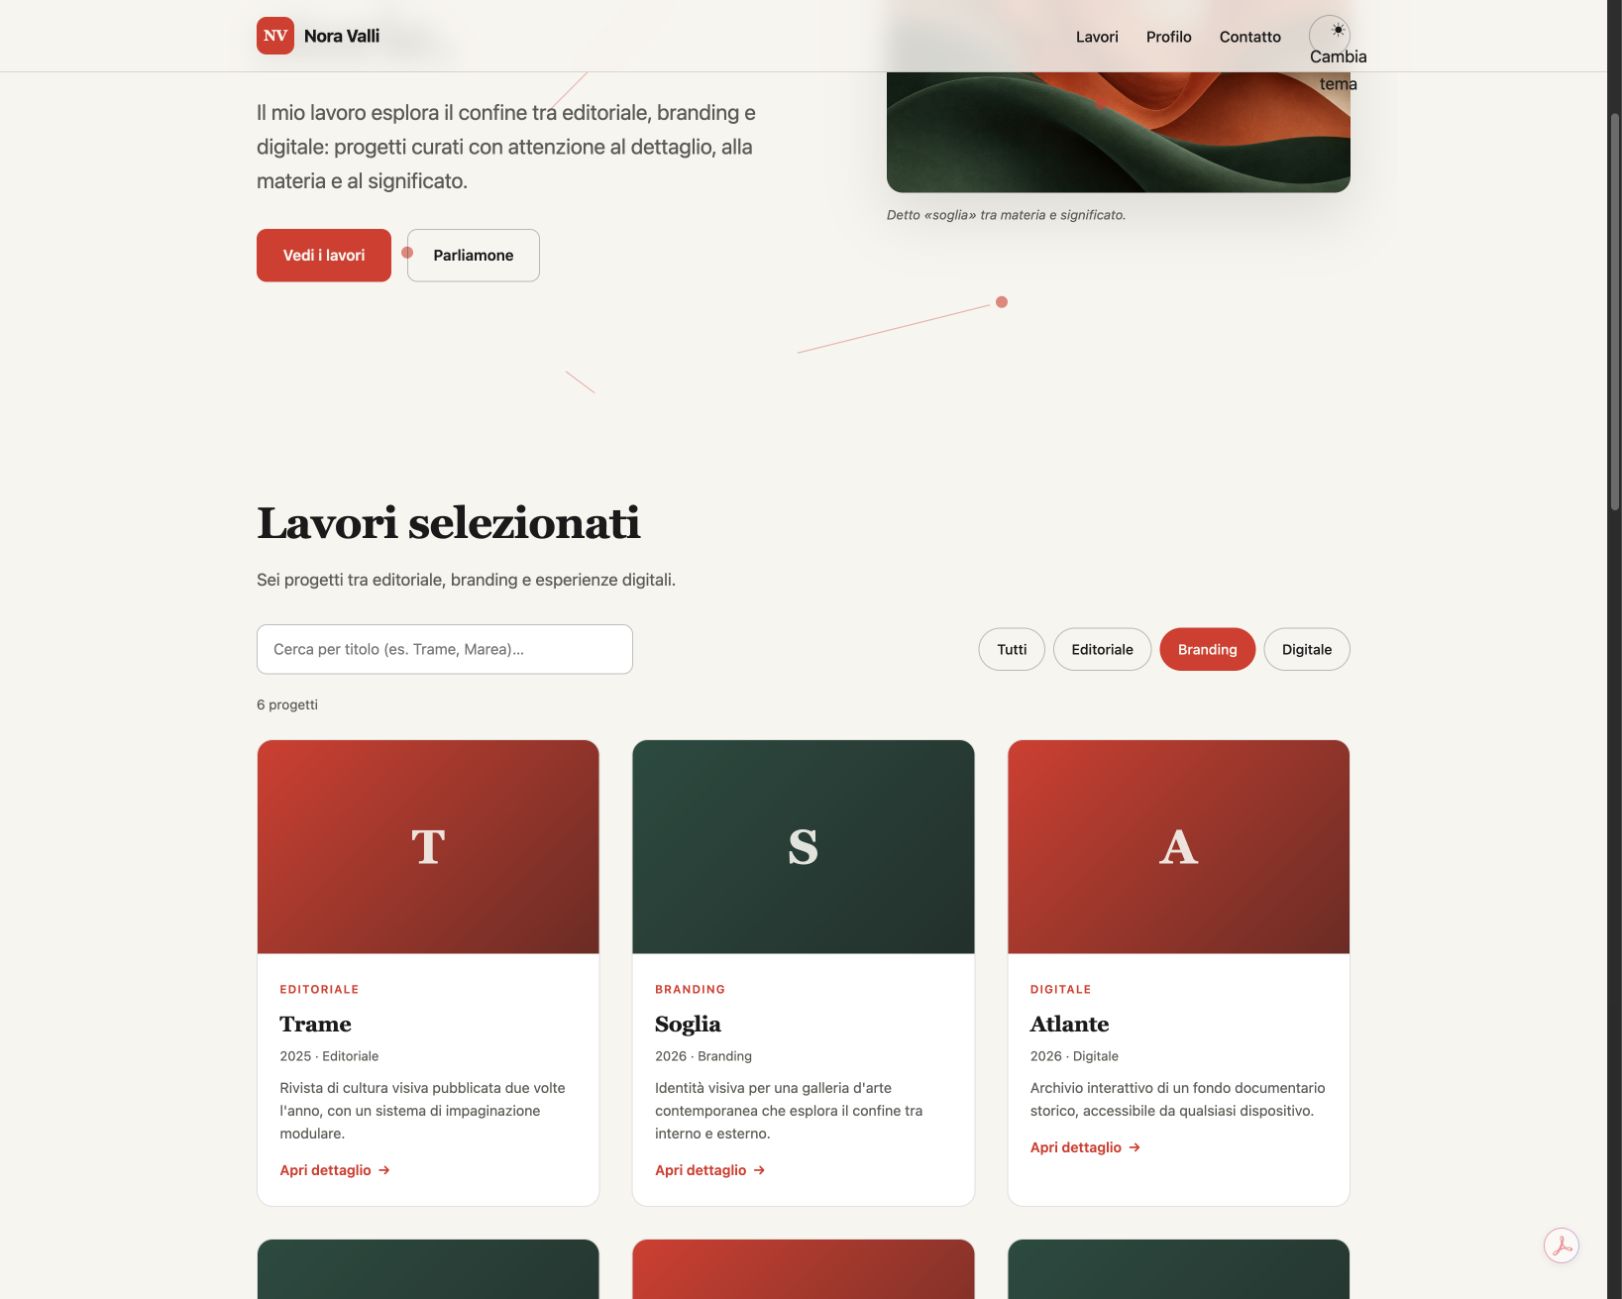
Dans son unique round de correction, Ornith corrige les références aux variables du filtre. Soglia et Orto urbano restent, comme demandé. La faute « 2 progettoi trovatoi » est toujours là : le contrôle vérifie le compte et l’état, sans certifier chaque mot de l’interface.
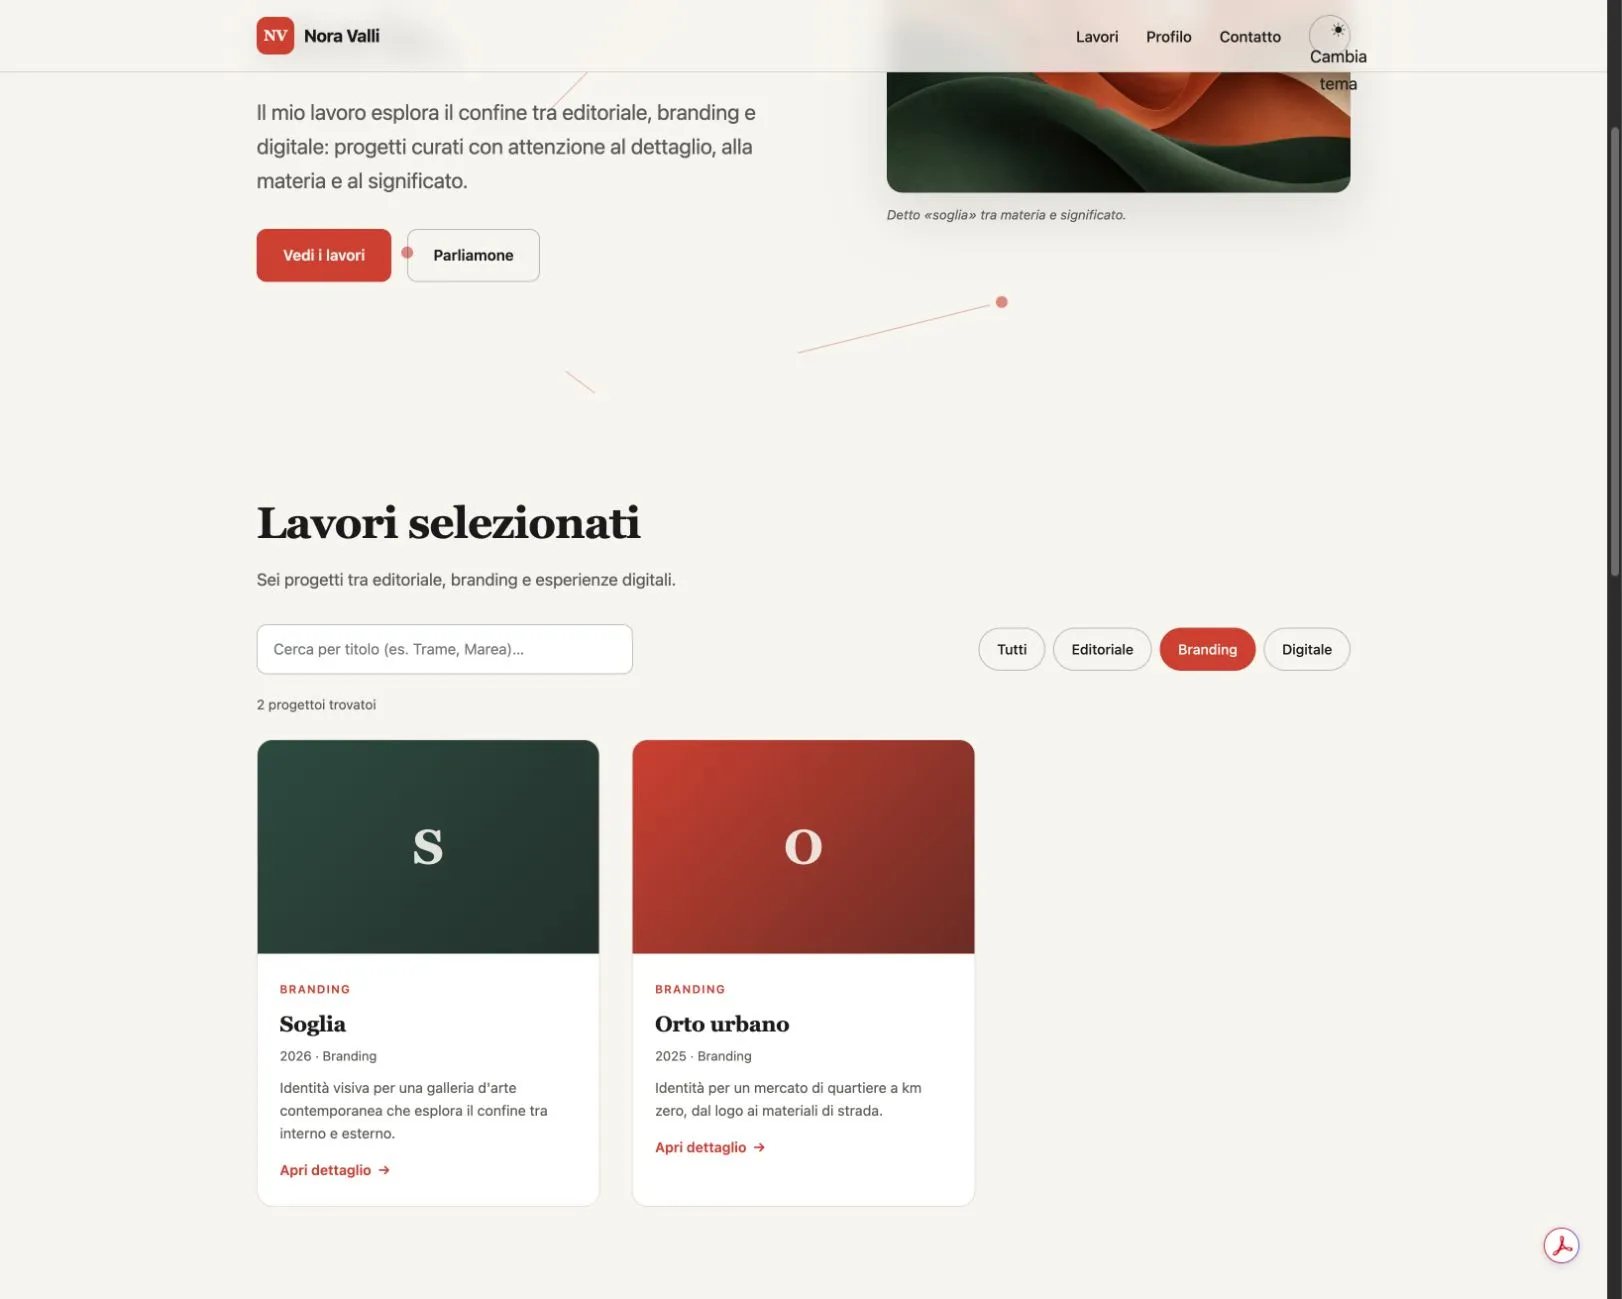
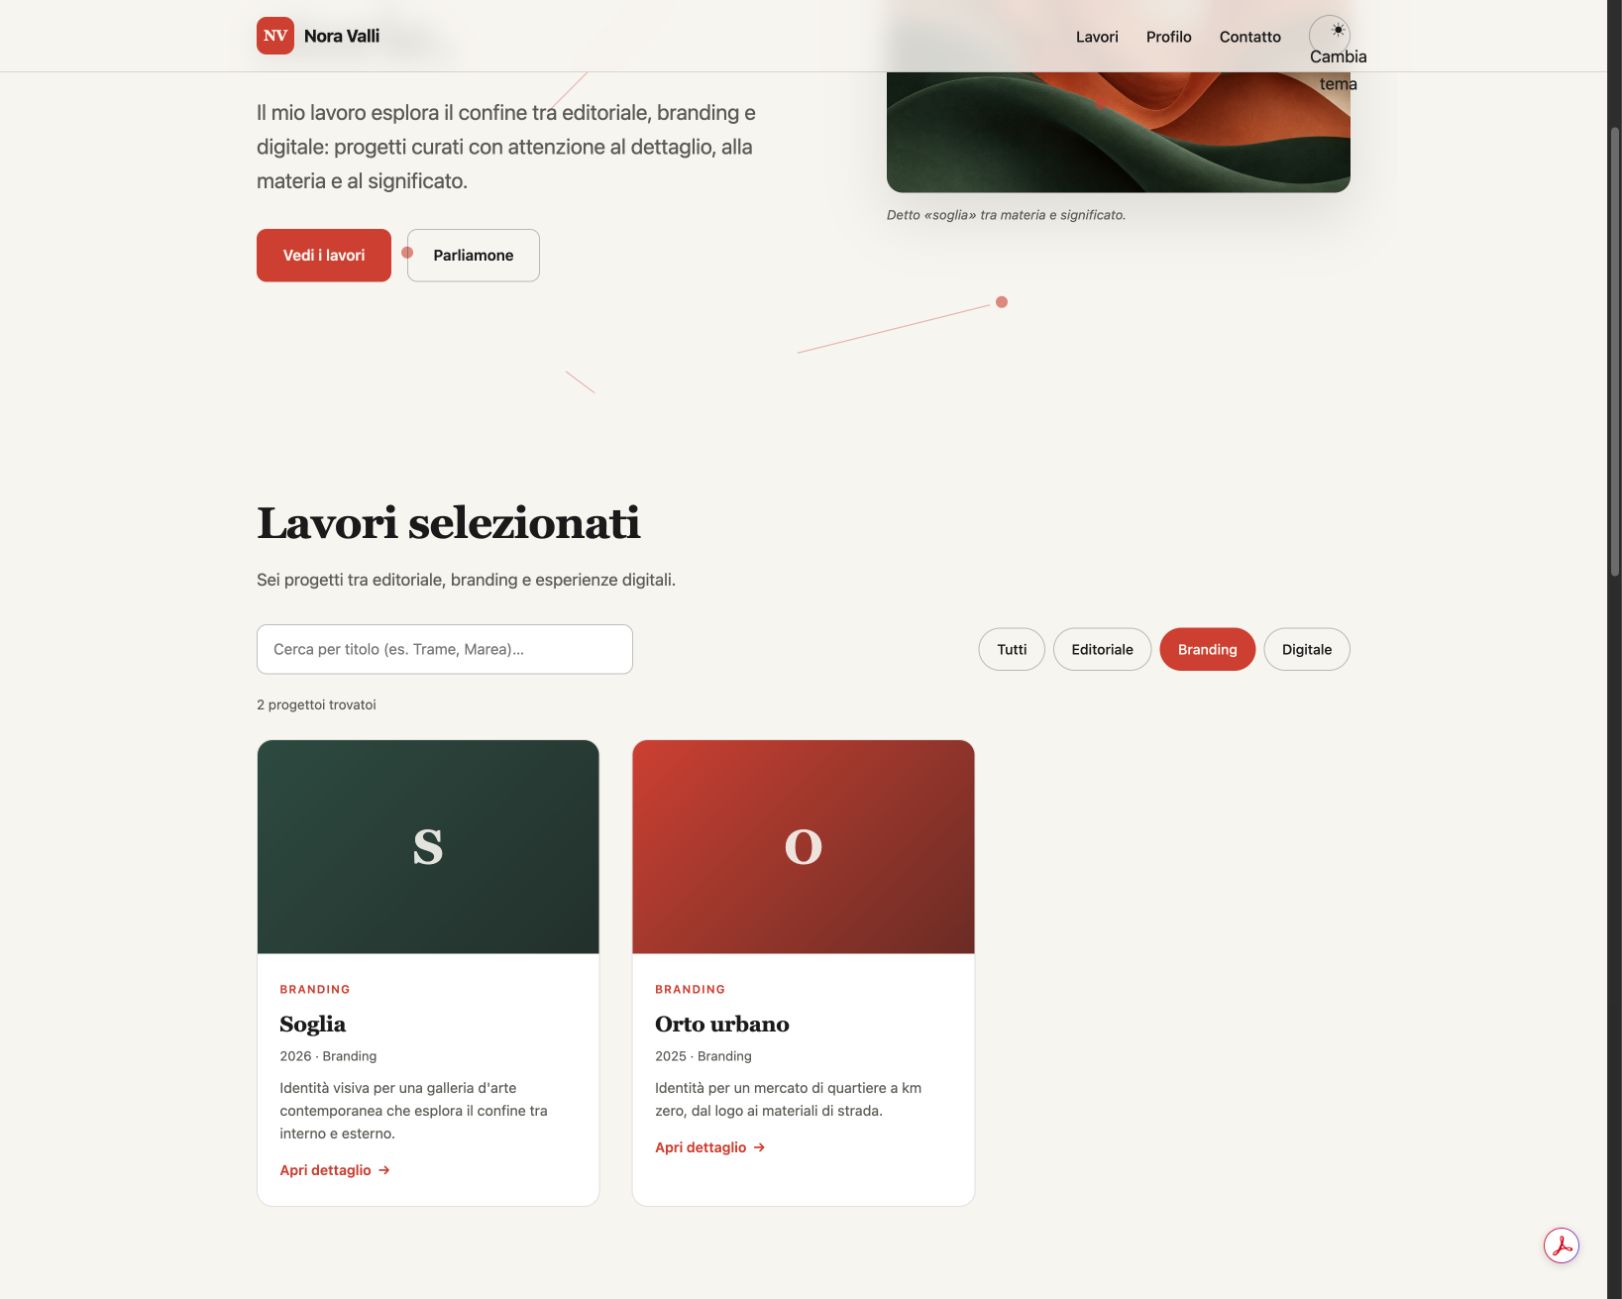
Les contrôles complets combinent filtre et recherche. La séquence attendue passe de six résultats à deux, puis à un et zéro, avant de revenir à six par réinitialisation. Si une recherche « Soglia » affiche encore ce projet sous Editoriale, filtre et requête travaillent séparément : une capture d’un filtre réussi ne vérifie pas leur combinaison.
Une itération peut corriger, répéter ou aggraver
Ici, une itération supplémentaire signifie une nouvelle exécution de Pi, avec nouvelle session et nouveau prompt, à partir des fichiers précédents, suivie de tous les contrôles externes. Un appel d’outil ou une réponse du modèle ne constitue pas une nouvelle itération.
| Configuration | Départ | Parcours des contrôles complets | Itérations supplémentaires |
|---|---|---|---|
| Qwen | 9, plus un partiel | 9 → 9 → 10 | 2 |
| Ornith | 8 | 8 → 10 | 1 |
| LFM | 4 | 4 → 4 → 4 → 4 → 4 → 4 → 4 → 3 → 5 → 6 → 8 → 9 → 9 → 10 | 13 |
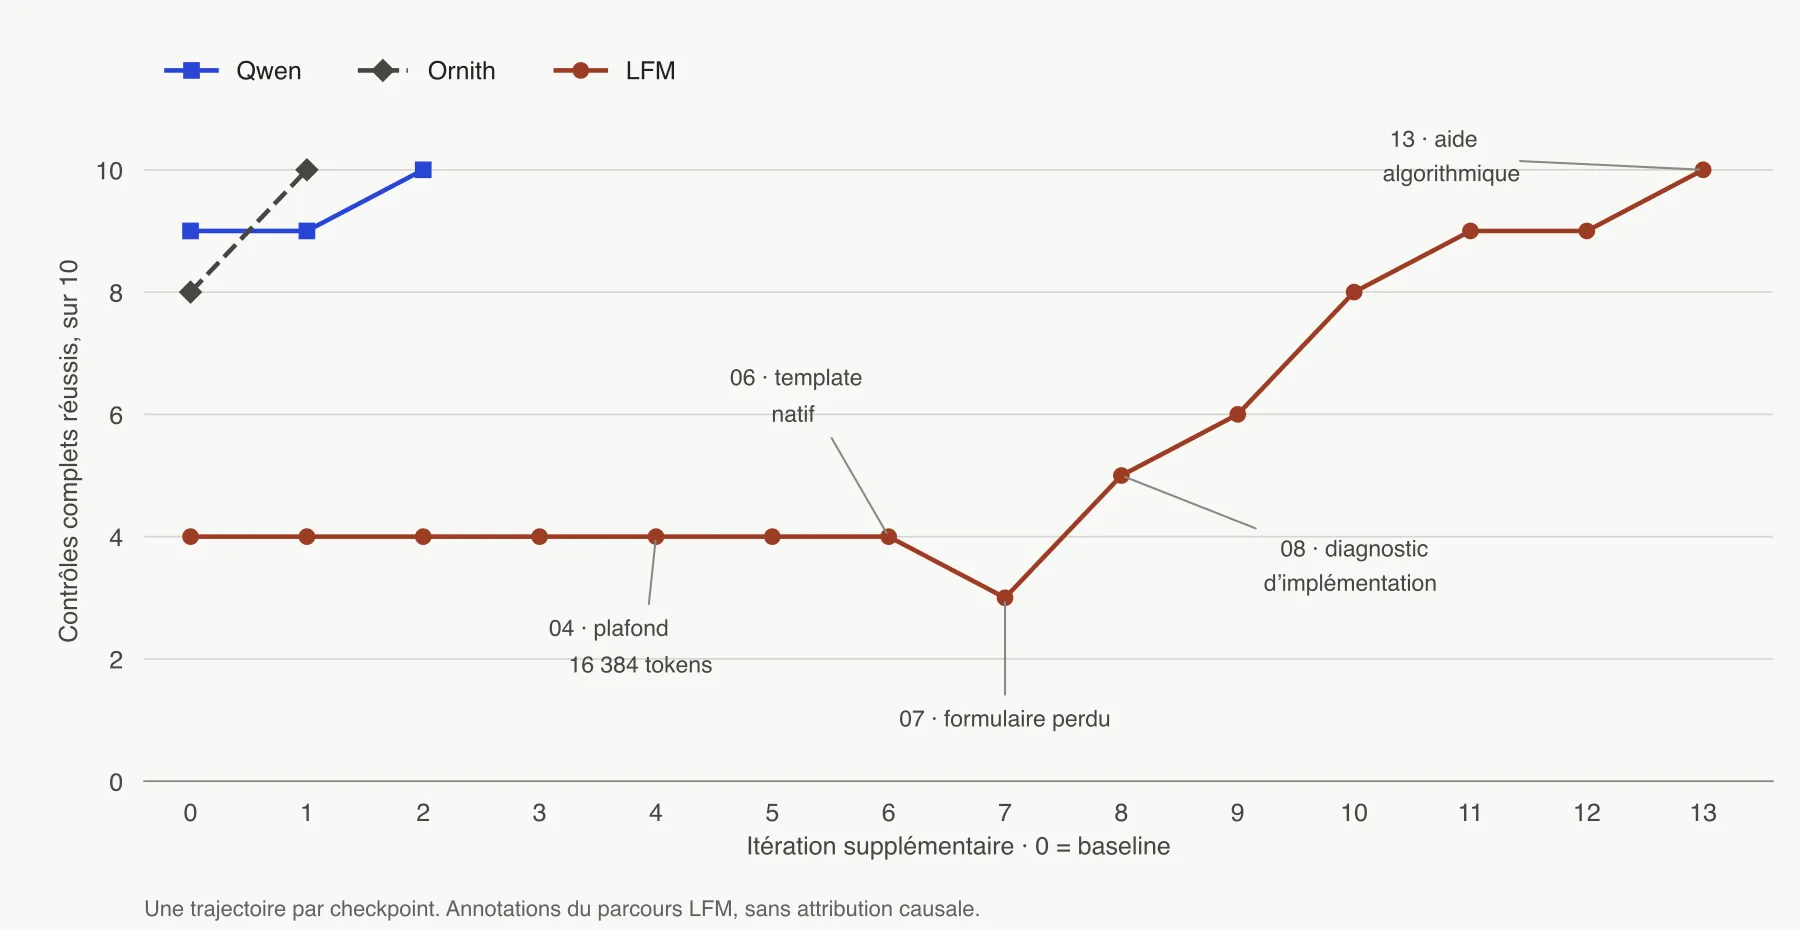
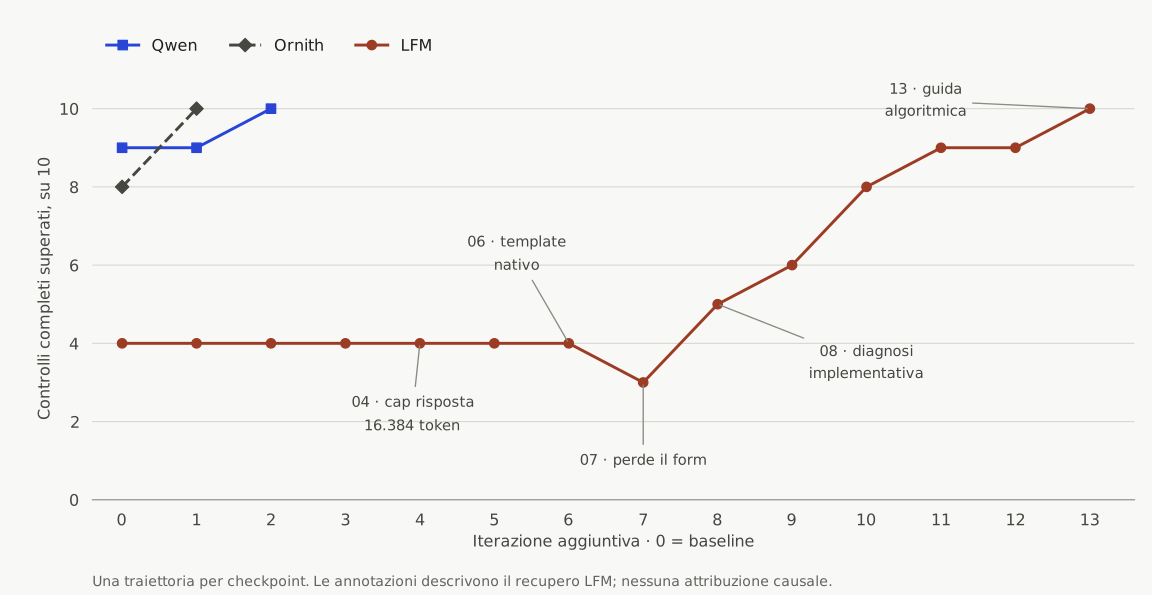
Chaque flèche de LFM correspond à une exécution conservée, y compris sans amélioration. La chute de quatre à trois est le round 07 : une réécriture perd le gestionnaire du formulaire. Le débordement mobile est un problème distinct, déjà présent, qui n’explique pas ce point perdu.
Au premier rattrapage, Qwen utilise les 24 appels d’outils disponibles. La séquence comprend lectures de script.js, remplacements et check_files répétés, puis d’autres remplacements et contrôles. Le second round atteint encore 24 appels, cette fois avec les dix contrôles externes réussis.
Il s’agit d’une répétition opérationnelle observable dans les logs. Qwen et Ornith avaient déjà enable_thinking=false dans les requêtes natives. Ces étapes ne permettent ni de reconstruire un processus mental interne ni de prouver un défaut général de Qwen. check_files vérifiait fichiers et syntaxe : le modèle pouvait le répéter sans voir le dialogue encore fermé dans le navigateur.
Ornith effectue huit appels d’outils et trois remplacements dans son unique correction. Le runner enregistre environ 48 secondes. Le défaut est vite résolu sur ce parcours, mais les problèmes initiaux différaient en nombre et difficulté de ceux des concurrents.
L’aide reçue par LFM
Le traitement de LFM a changé en cours de route. Après deux tentatives sans progrès, le prompt devient plus ciblé. À partir du round 04, la limite par réponse passe de 8192 à 16384 tokens, avec un plafond total de 24 000. Dès le round 06, le format des messages, ou template, change aussi : on abandonne un préfixe expérimental fermant le bloc think pour le format natif, avec thinking demandé.
Après la régression du round 07, le coordinateur limite les outils aux petits remplacements, utilise de brèves consignes en anglais et fournit des diagnostics d’implémentation. Au round 10, il donne aussi le texte italien de confirmation du formulaire. Au round 13, il explique comment relier les liens à la création des fiches, utiliser le projet courant, activer la classe ouvrant le dialogue et garder le focus sur le bouton de fermeture.
Cette aide est consultable dans le prompt original du round 13, avec le diff produit. Le modèle écrit les patchs, mais reçoit une part substantielle de la solution. Le 10/10 final doit être lu comme un résultat fortement assisté.
Les contrôles qui demandent une séquence
Un dialogue ouvert n’est qu’une partie du contrôle. Il faut ouvrir les six projets, vérifier la cohérence des contenus, fermer par bouton et Échap, puis retrouver le focus sur le lien initial. Tab et Maj+Tab ont été testés sur un dialogue représentatif. Identités des contrôles et résultats figurent dans les JSON d’audit : la photo seule ne prouve pas le maintien du focus.
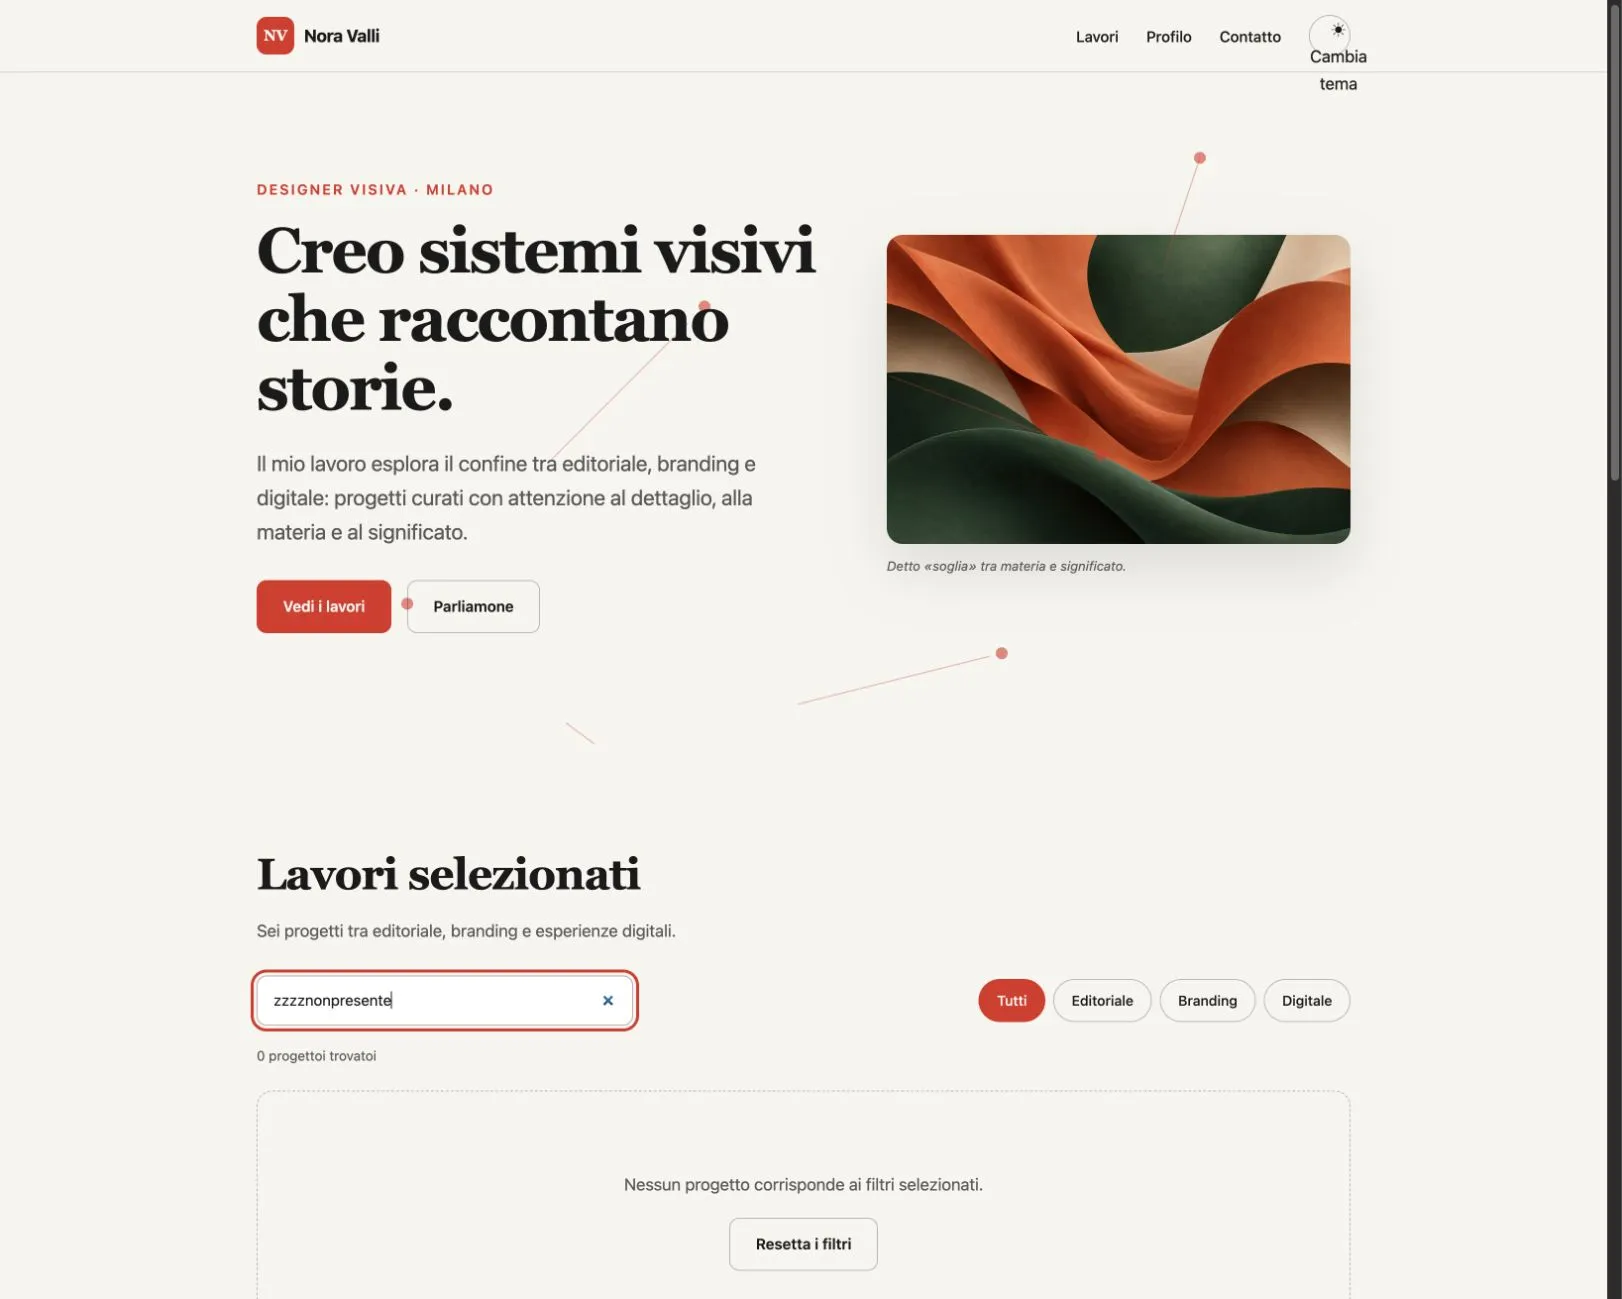
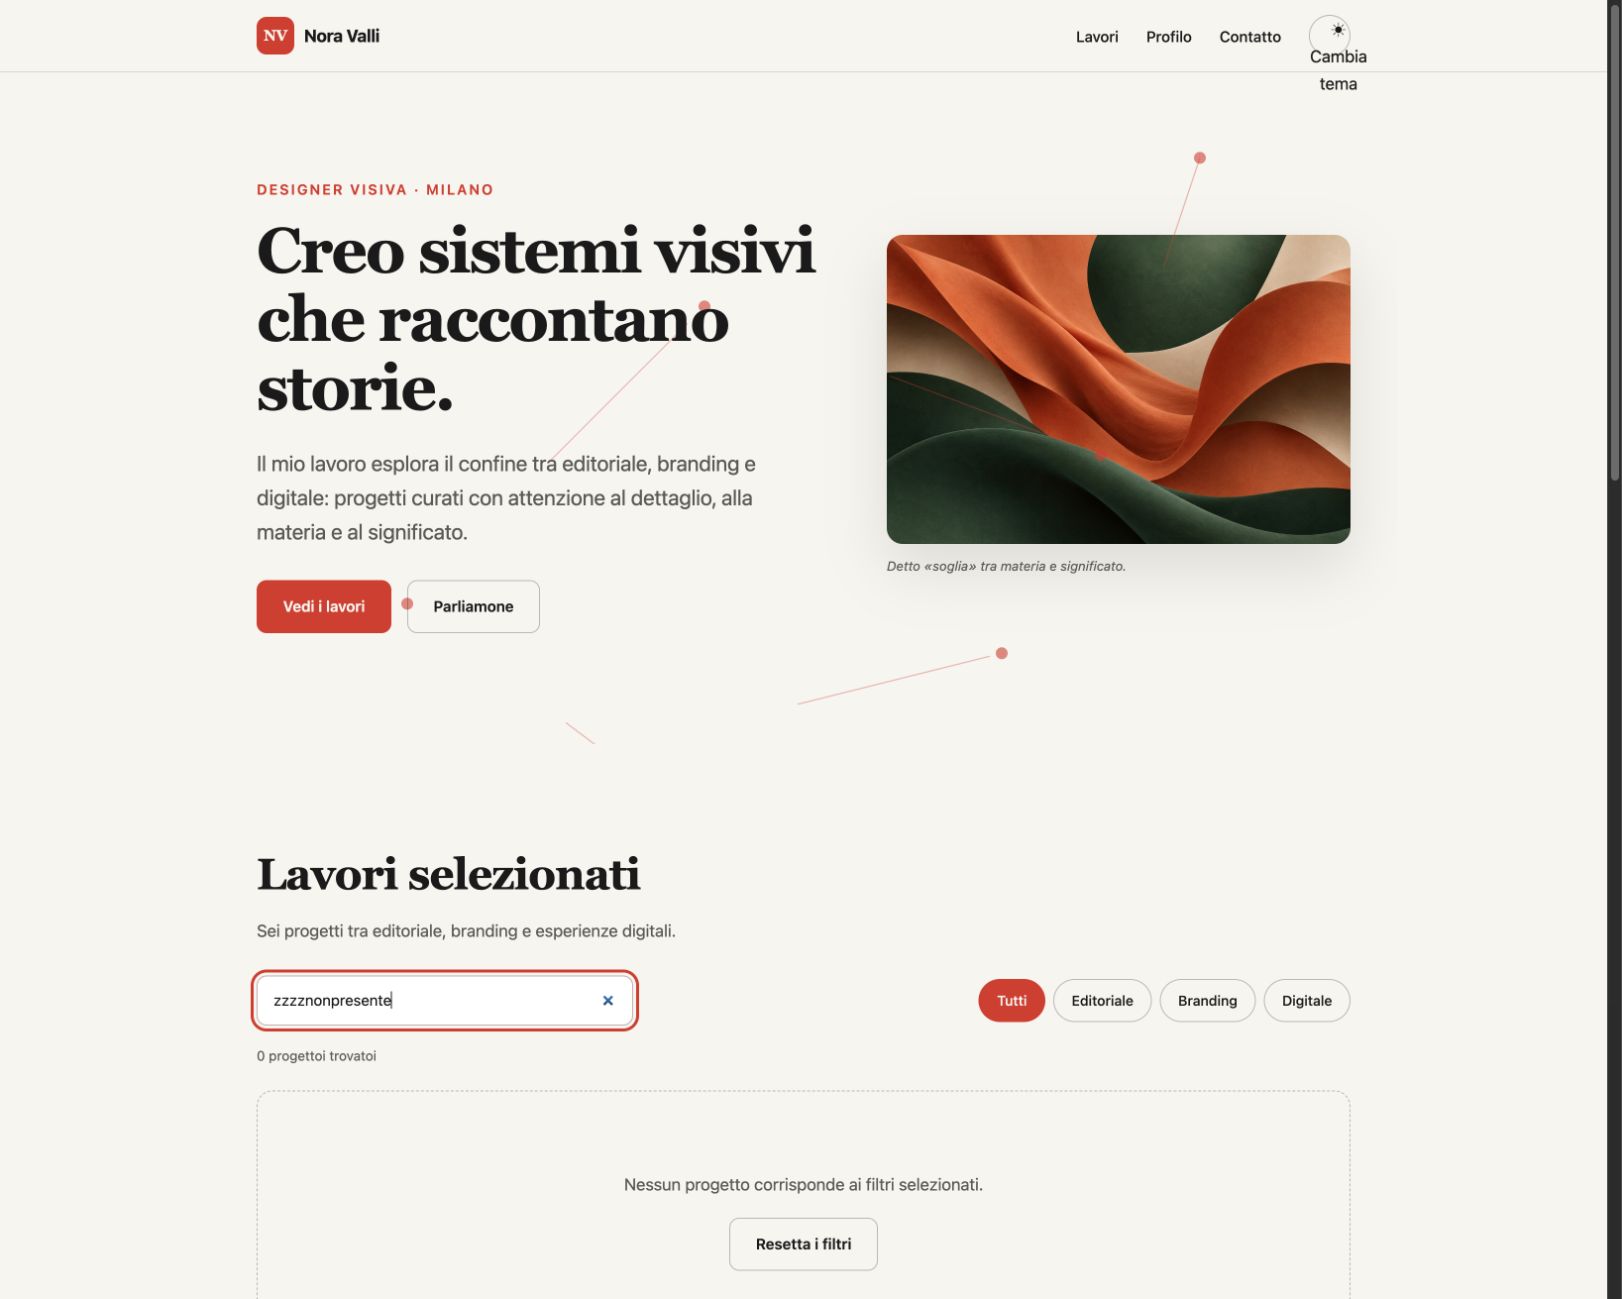
L’état vide doit être compréhensible et réversible. Chez Ornith, une recherche sans résultat affiche zéro, un message et une réinitialisation. Les défauts de langue restent visibles ici aussi.
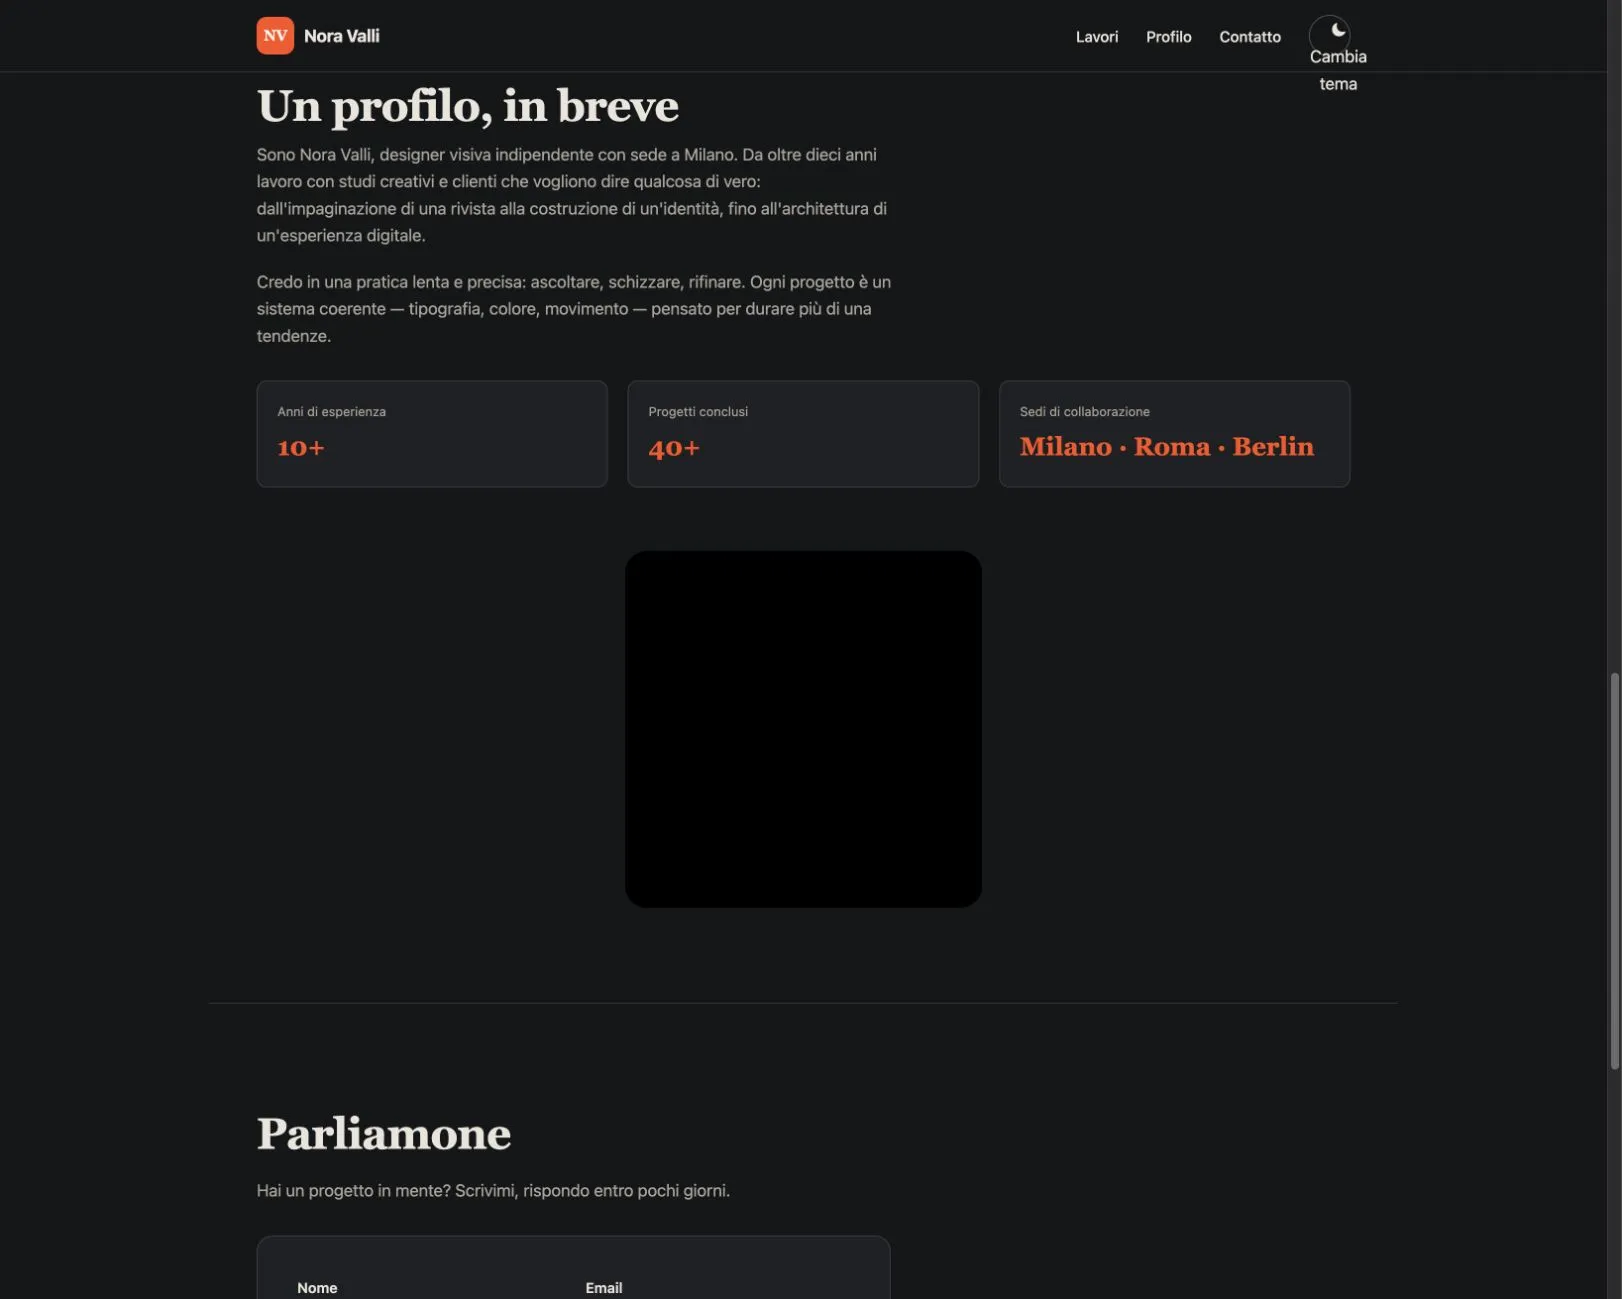
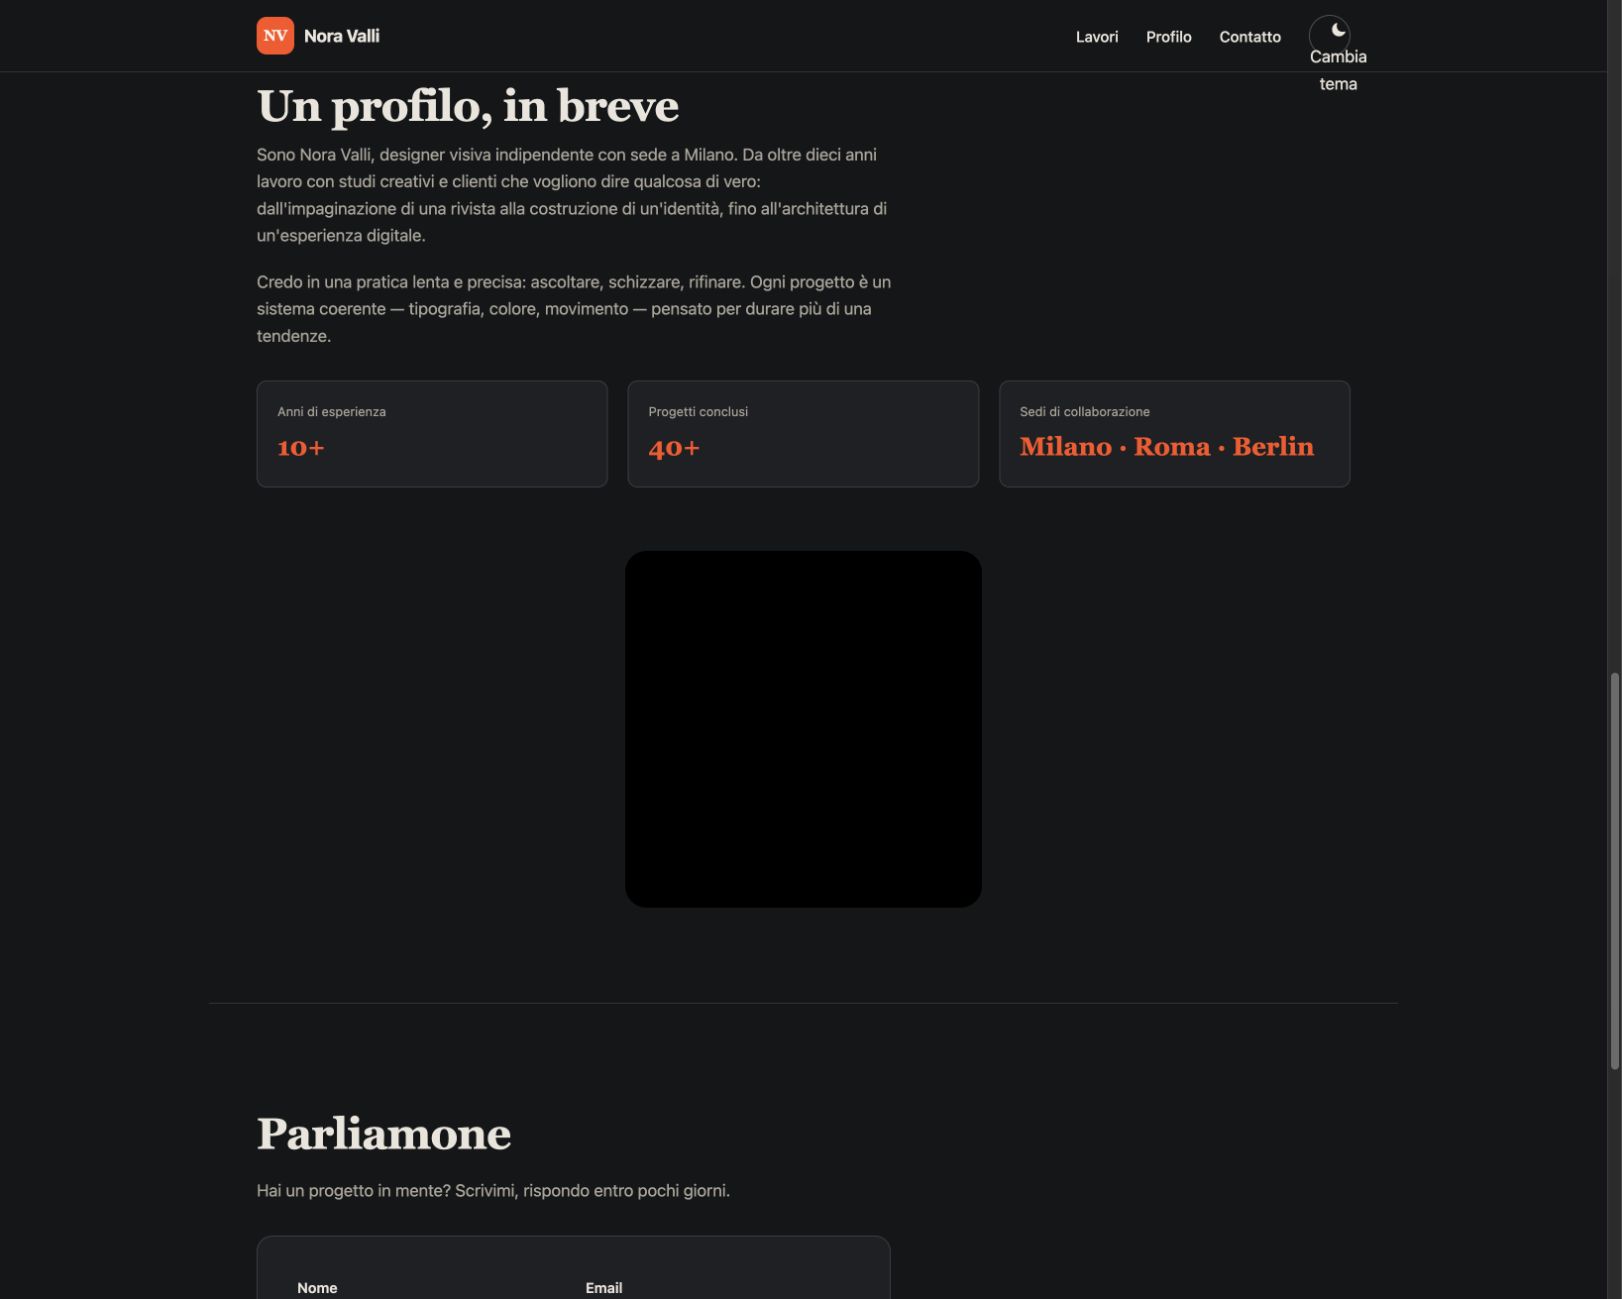
Une page sombre ne prouve pas la persistance du thème. Il faut changer, recharger et comparer l’état conservé. L’évaluateur avait d’abord lu la couleur trop tôt, au début de la transition d’Ornith : un faux négatif corrigé et documenté sans compter un nouvel essai du modèle.
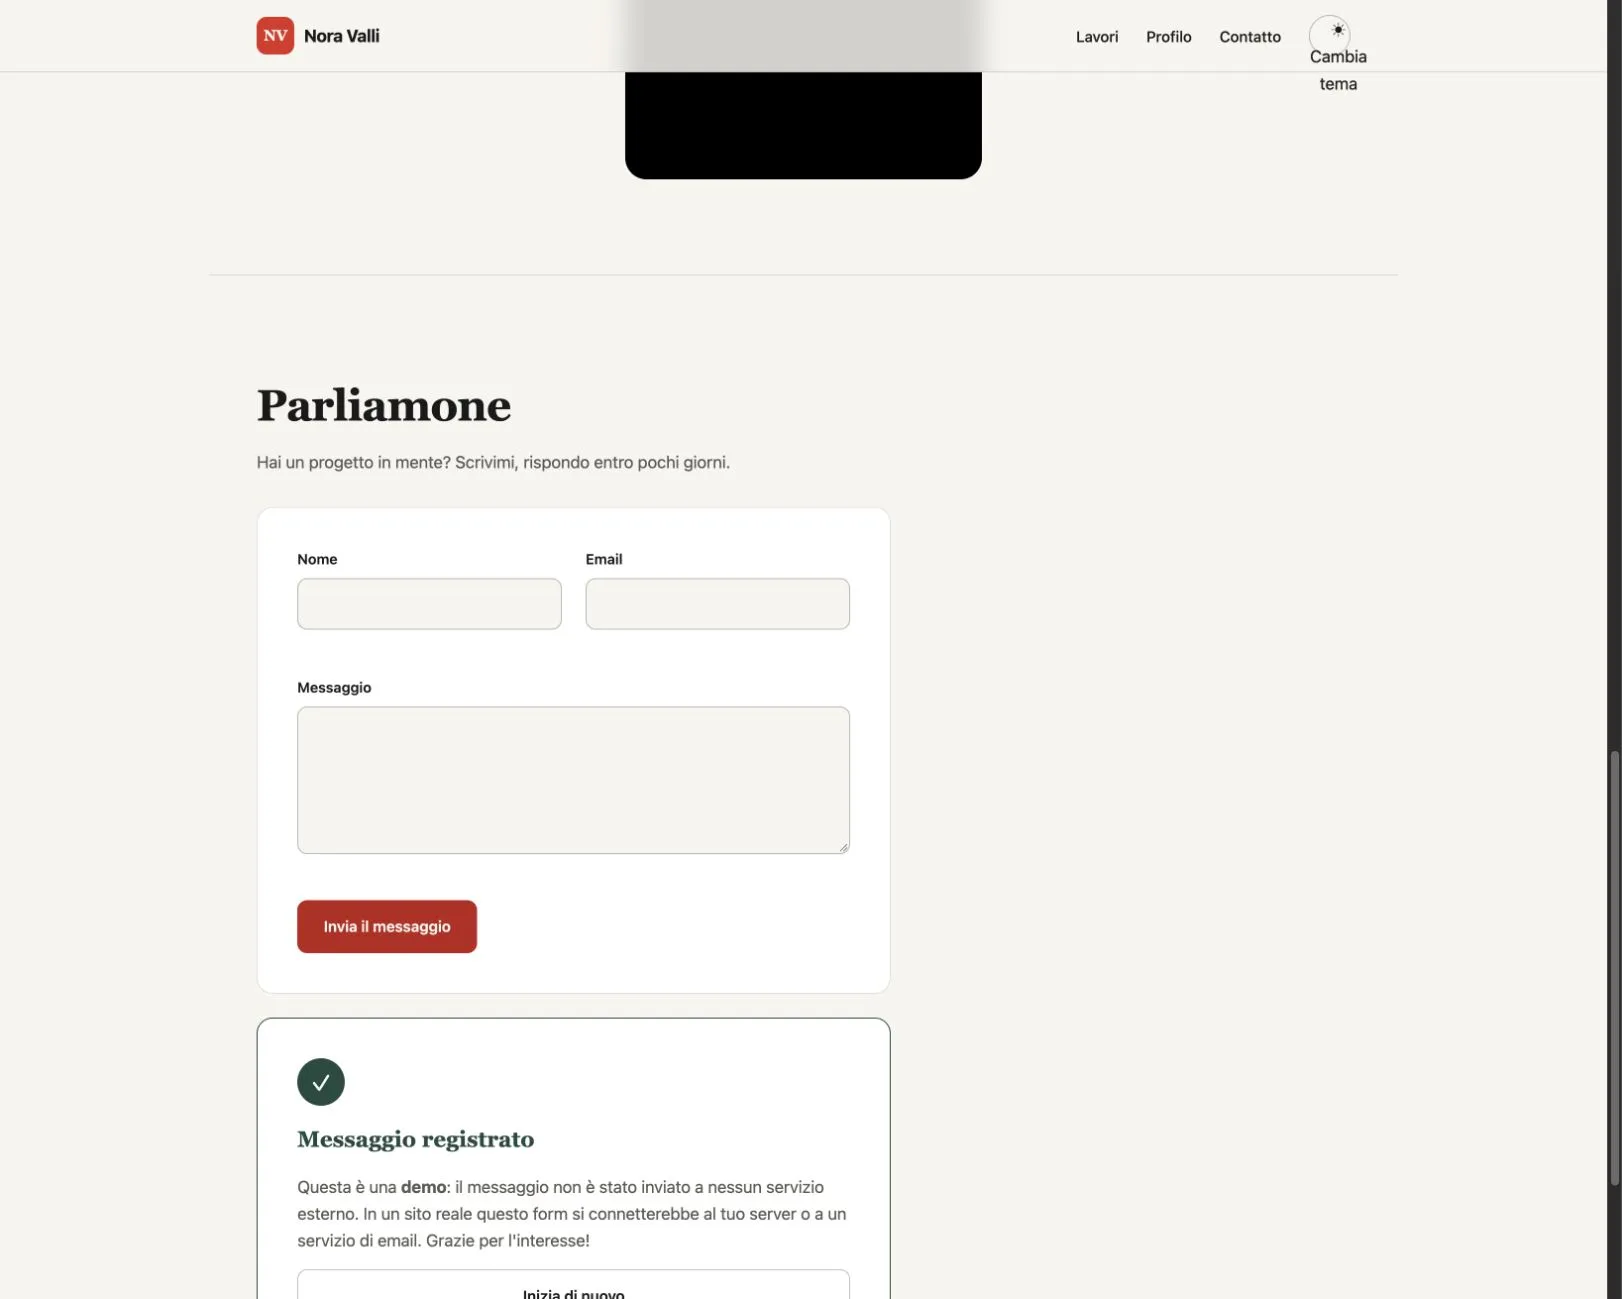
Le formulaire devait refuser les données manquantes et les e-mails invalides, puis confirmer localement l’envoi de démonstration. Des données synthétiques ont été utilisées. La mention « rien envoyé » est nécessaire au lecteur, mais l’absence de transmissions externes repose aussi sur l’inspection du code, pas seulement sur la promesse de la page.
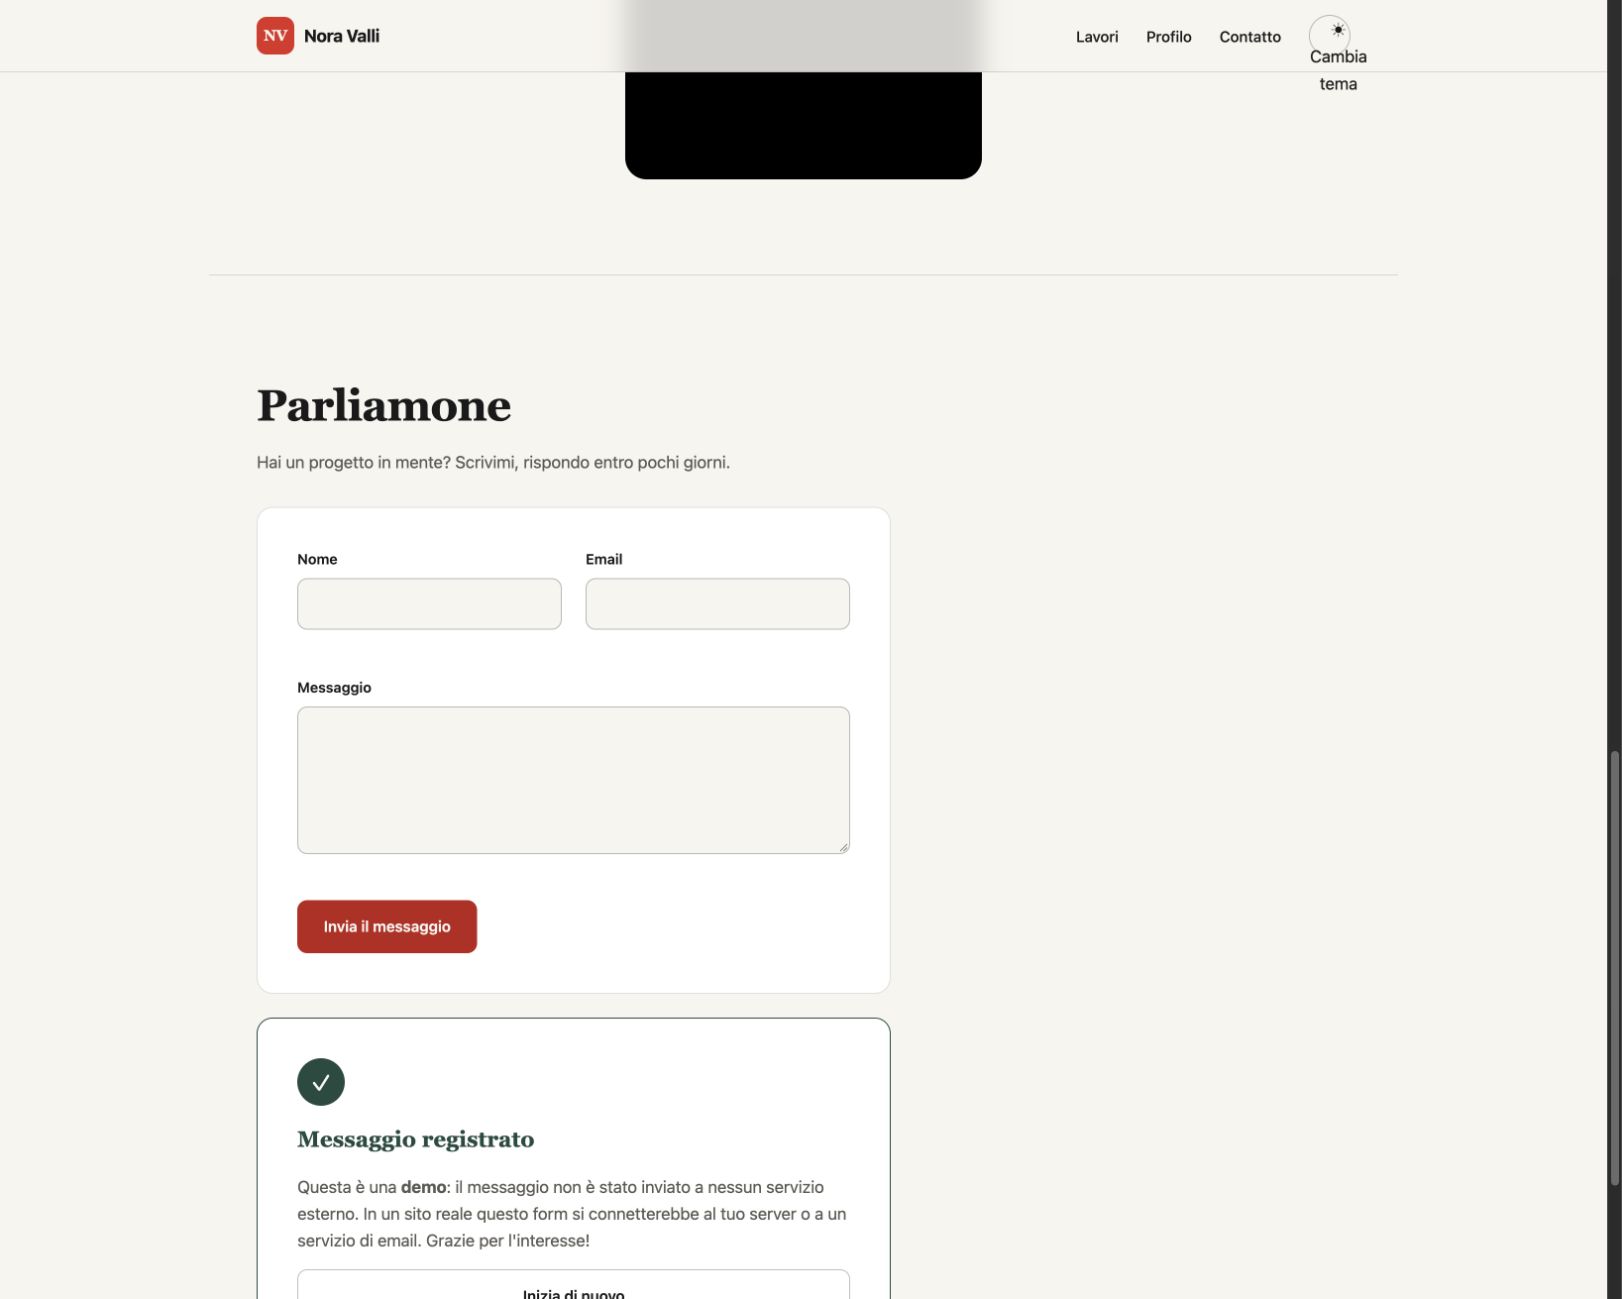
Le téléphone révèle d’autres problèmes
Les quatre images suivantes utilisent un viewport 390×844. Le navigateur réserve 15 pixels à la barre de défilement : le contenu mesure donc 375 pixels de large. Dans les versions finales des trois portfolios, scrollWidth et clientWidth valent tous deux 375.
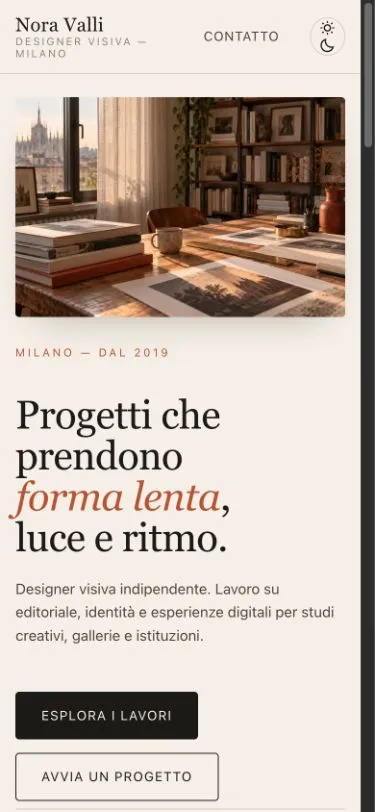
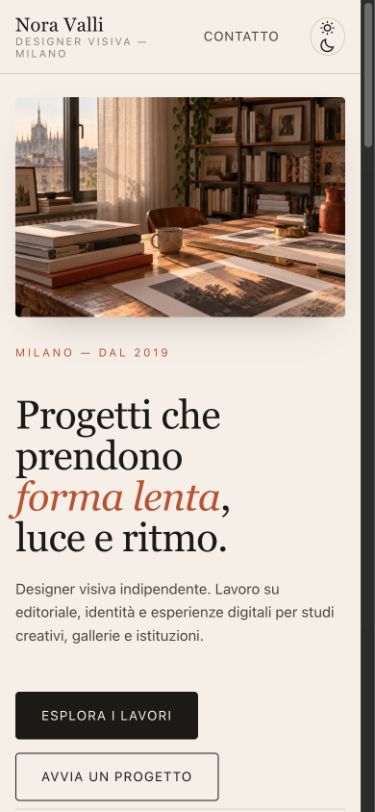
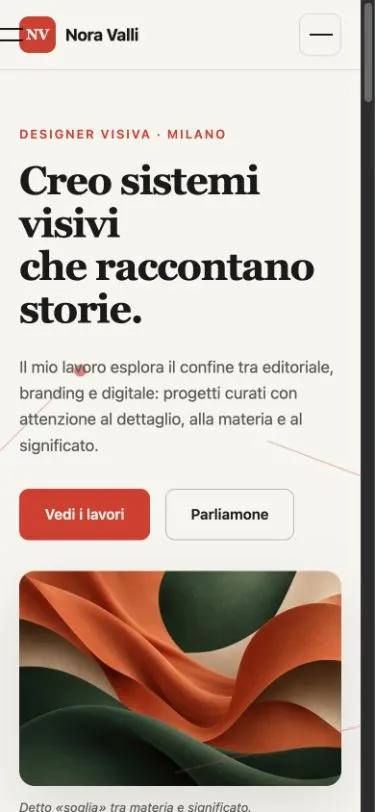
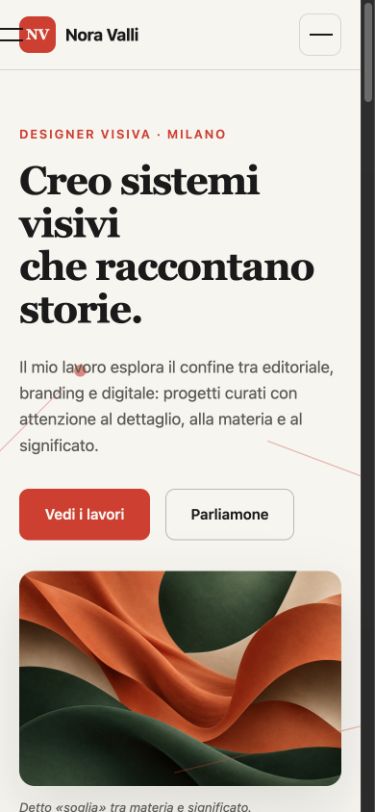
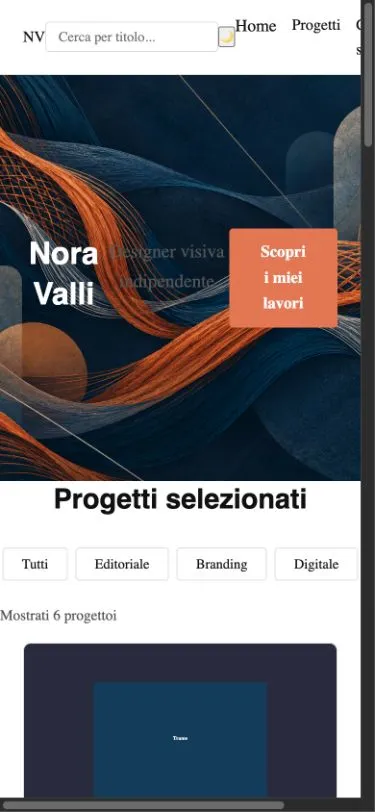
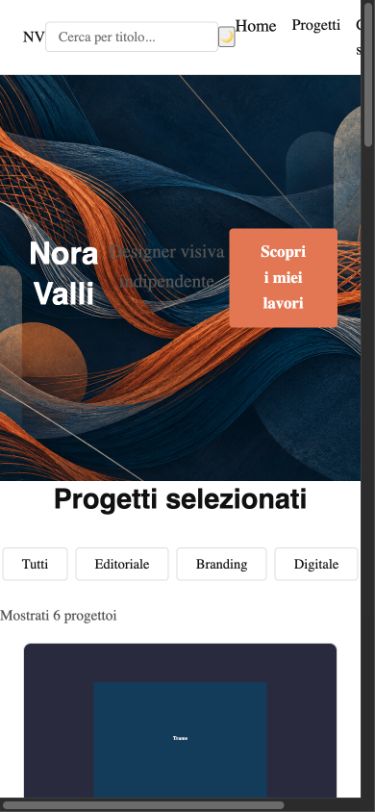
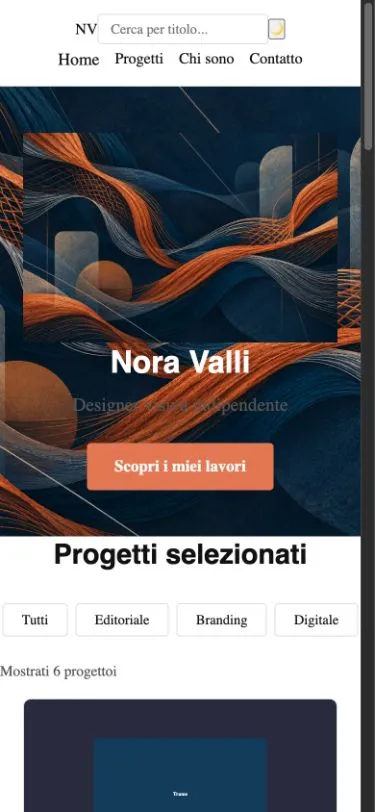
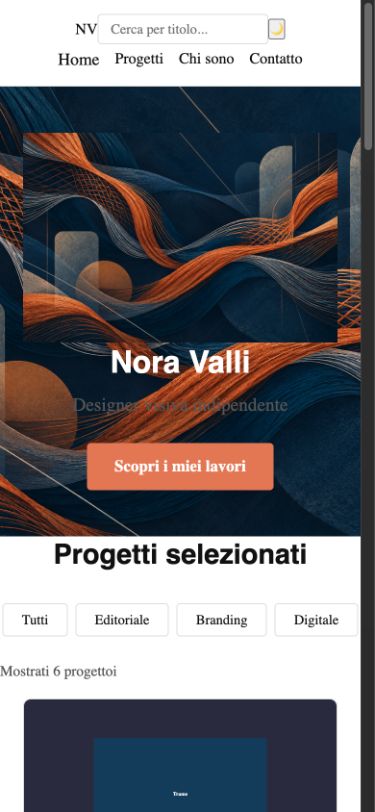
L’absence de débordement est un contrôle précis et limité. Elle ne mesure ni le confort de chaque geste, ni la lisibilité de tous les textes, ni l’équilibre de la composition. Il faut continuer à utiliser et observer la page pour évaluer ces qualités.
Tous à dix, trois sites différents
Voici les pages finales, toujours depuis des viewports de bureau 1440×900. Les images originales des portfolios sont restées identiques pendant les corrections. Le code a modifié certains comportements ; la structure visuelle distingue toujours trois résultats.
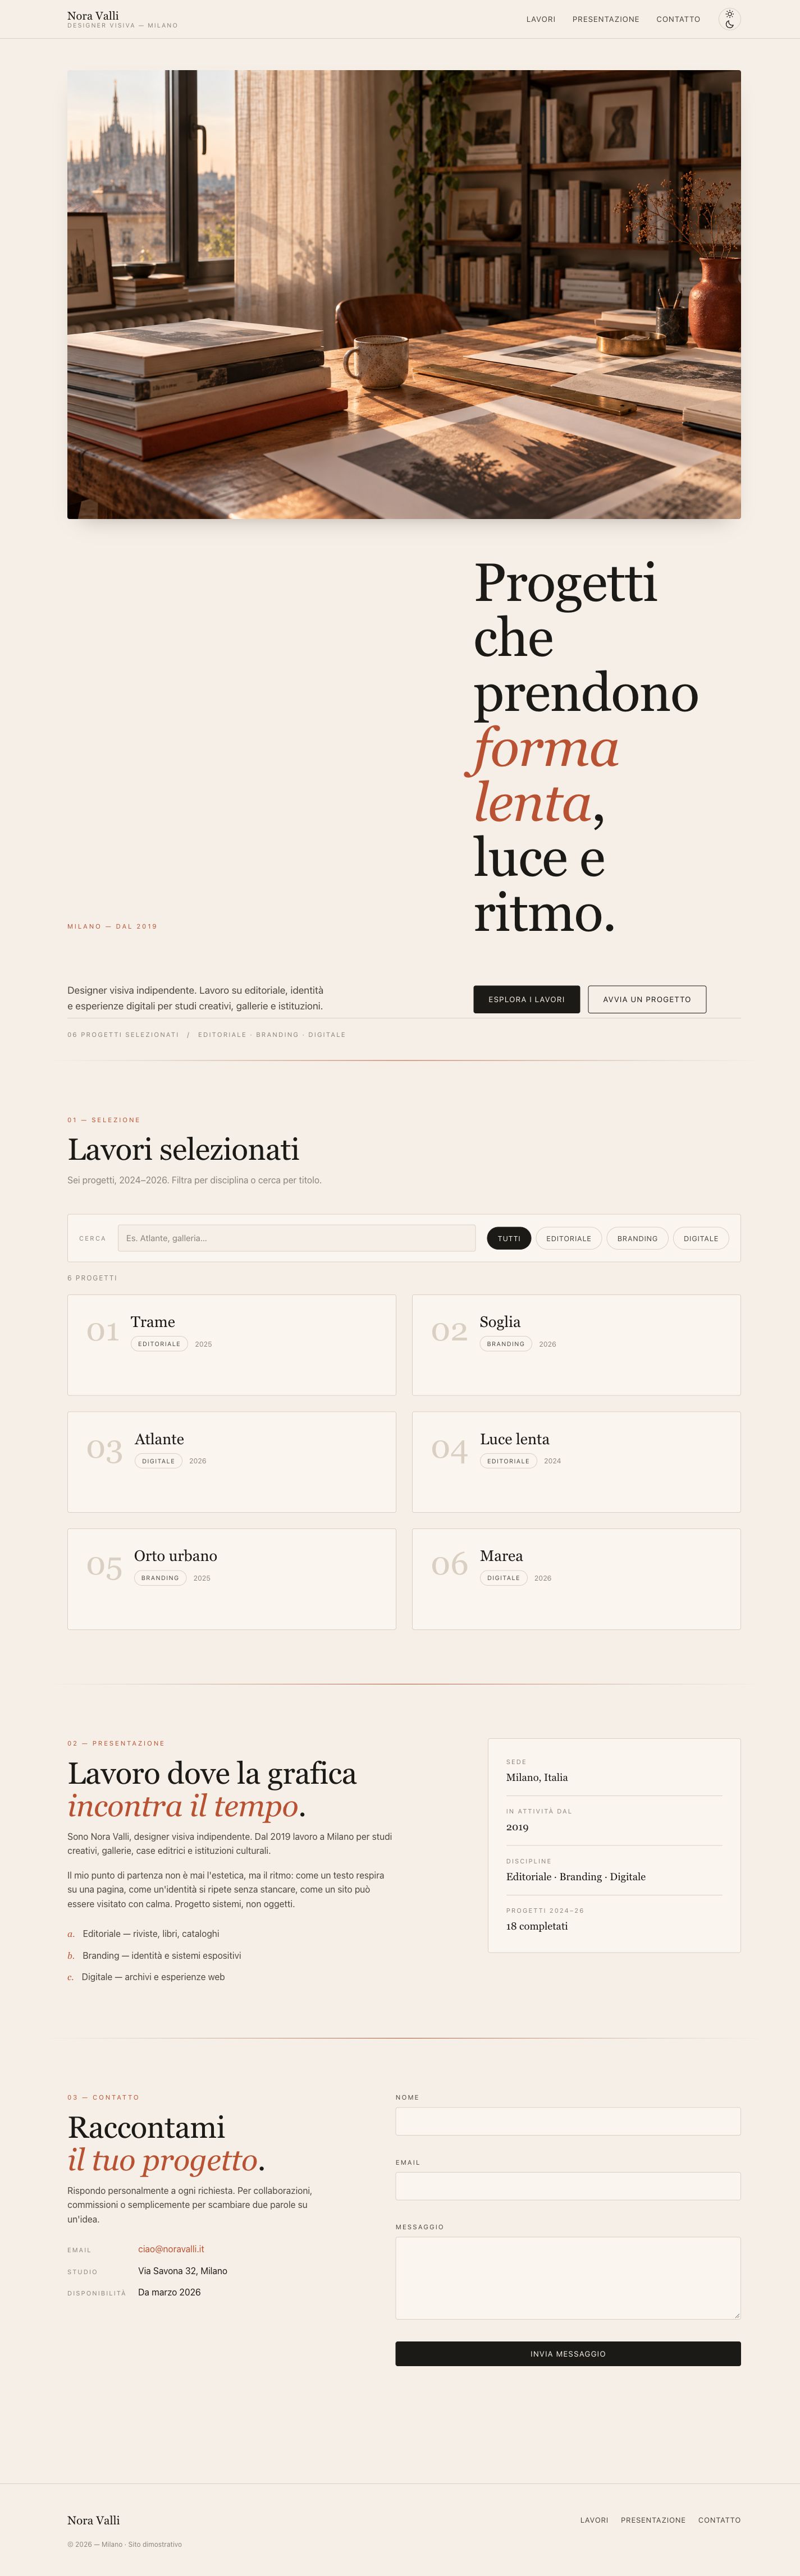
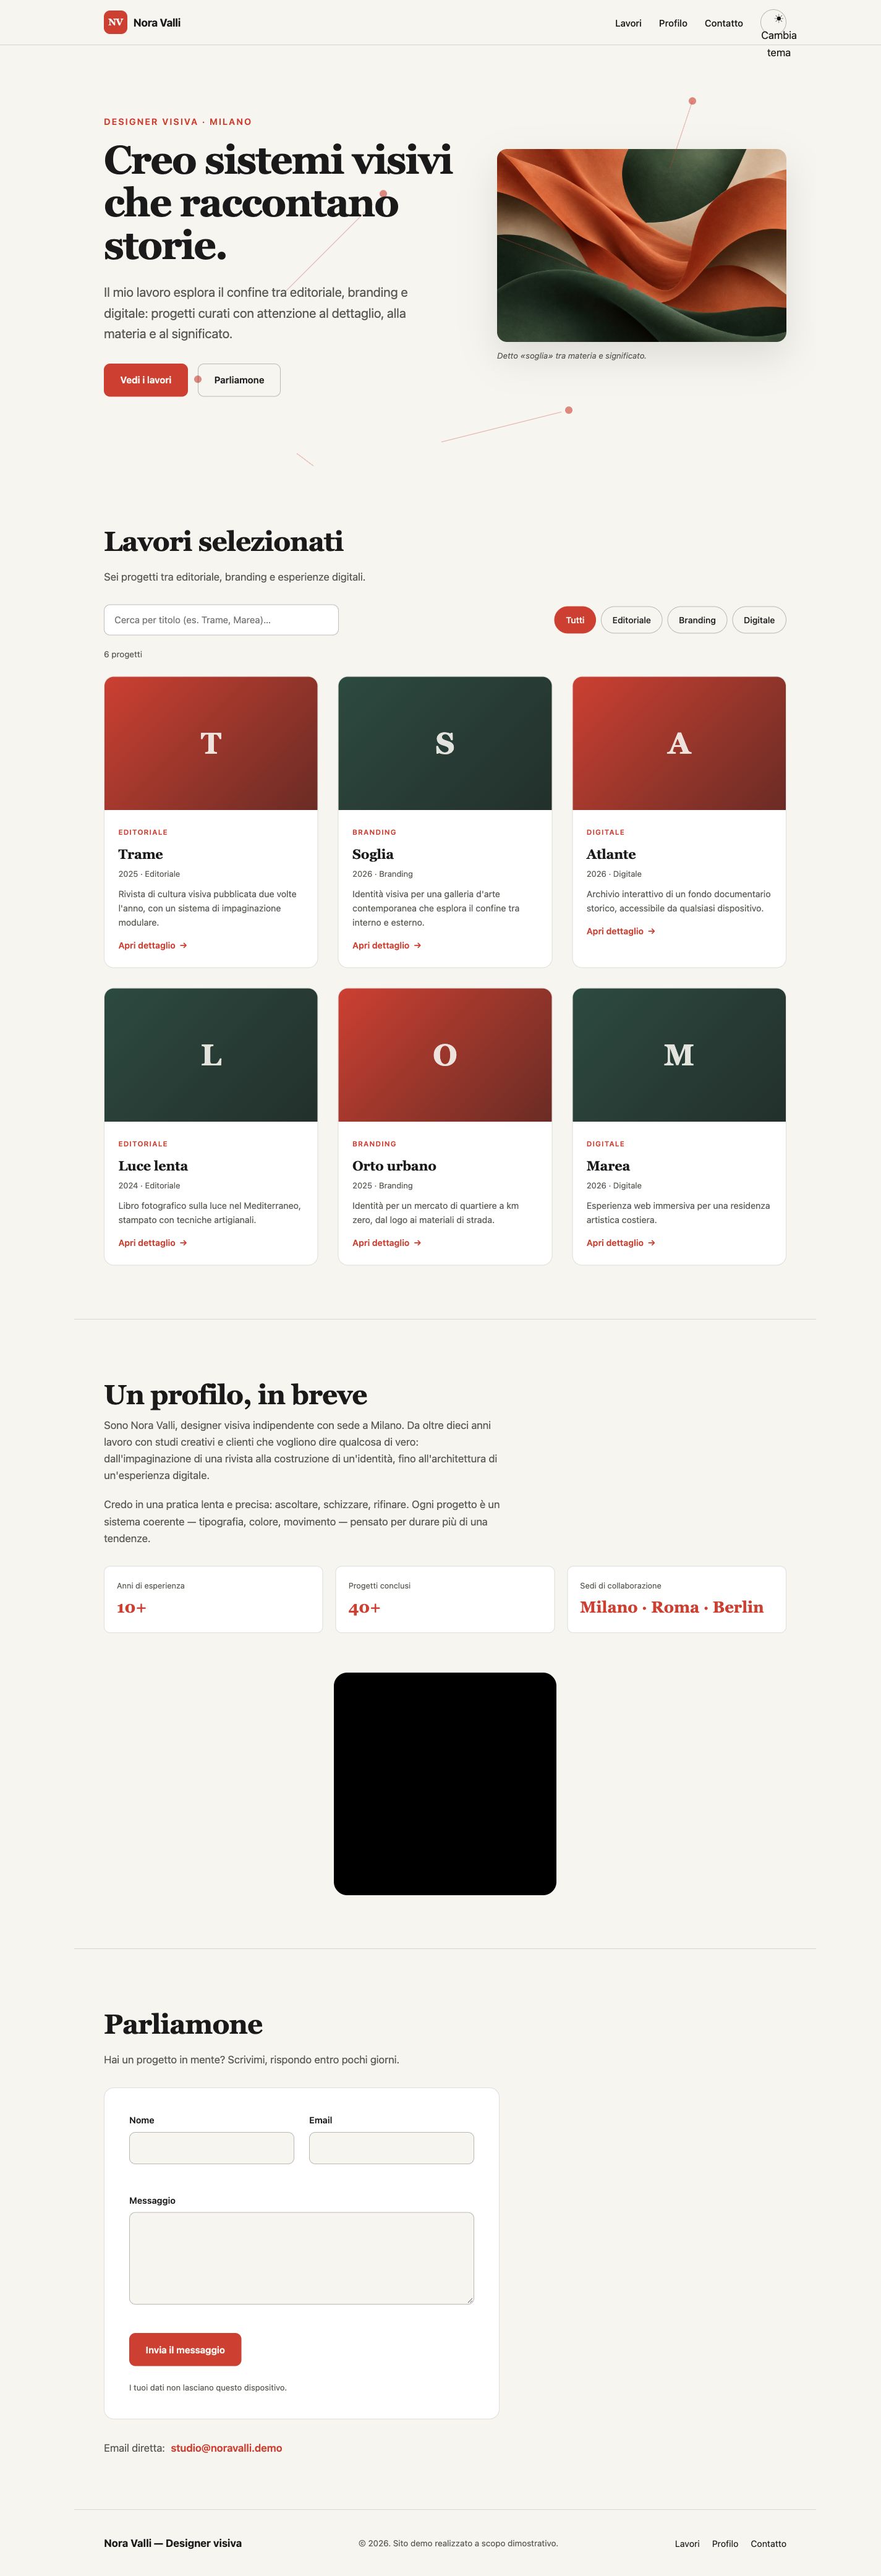
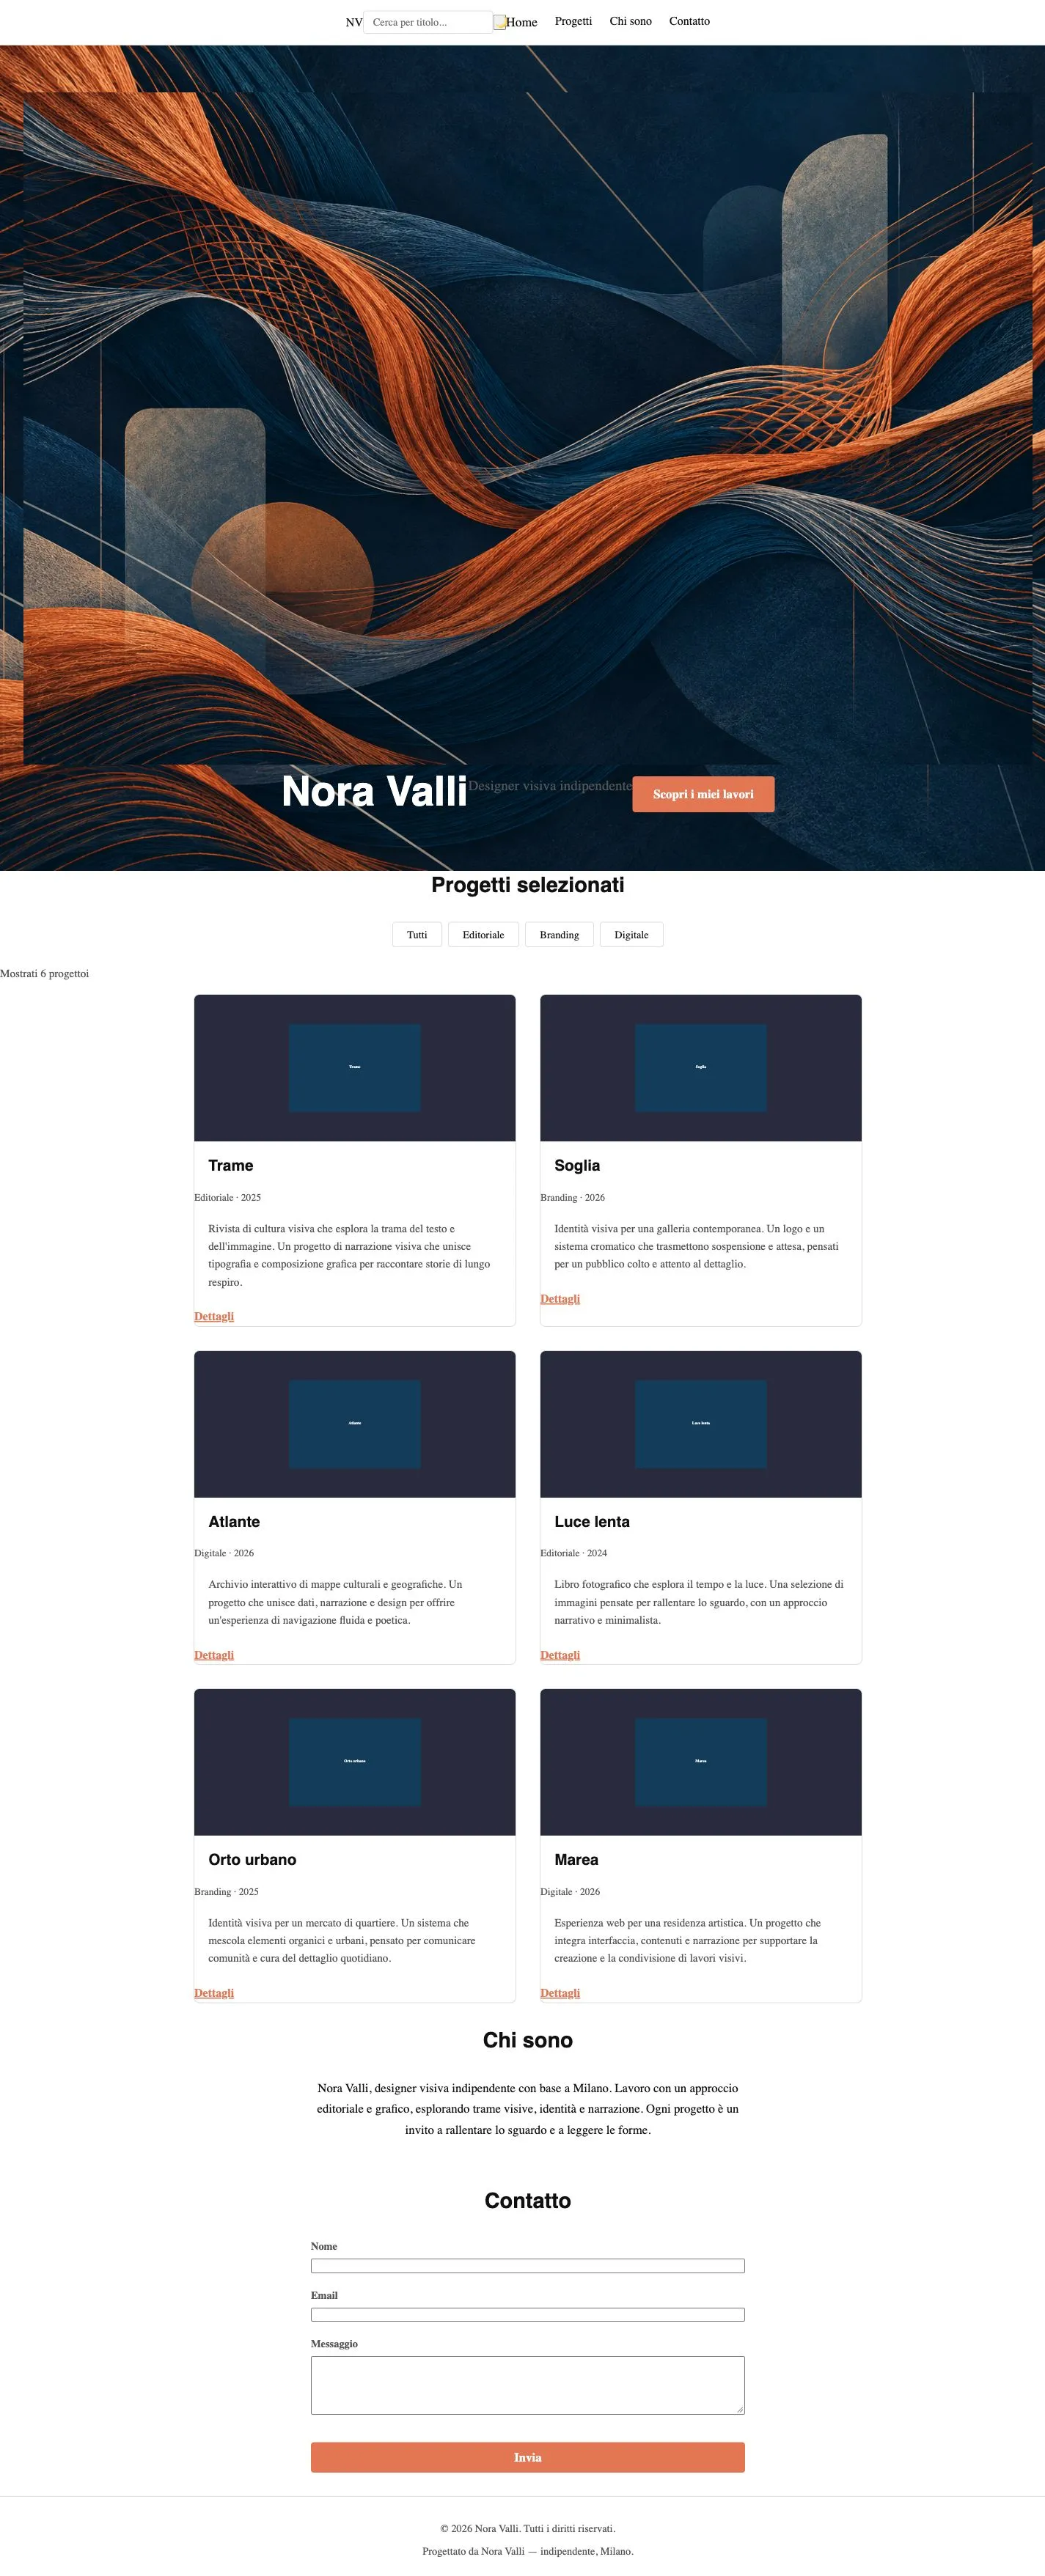
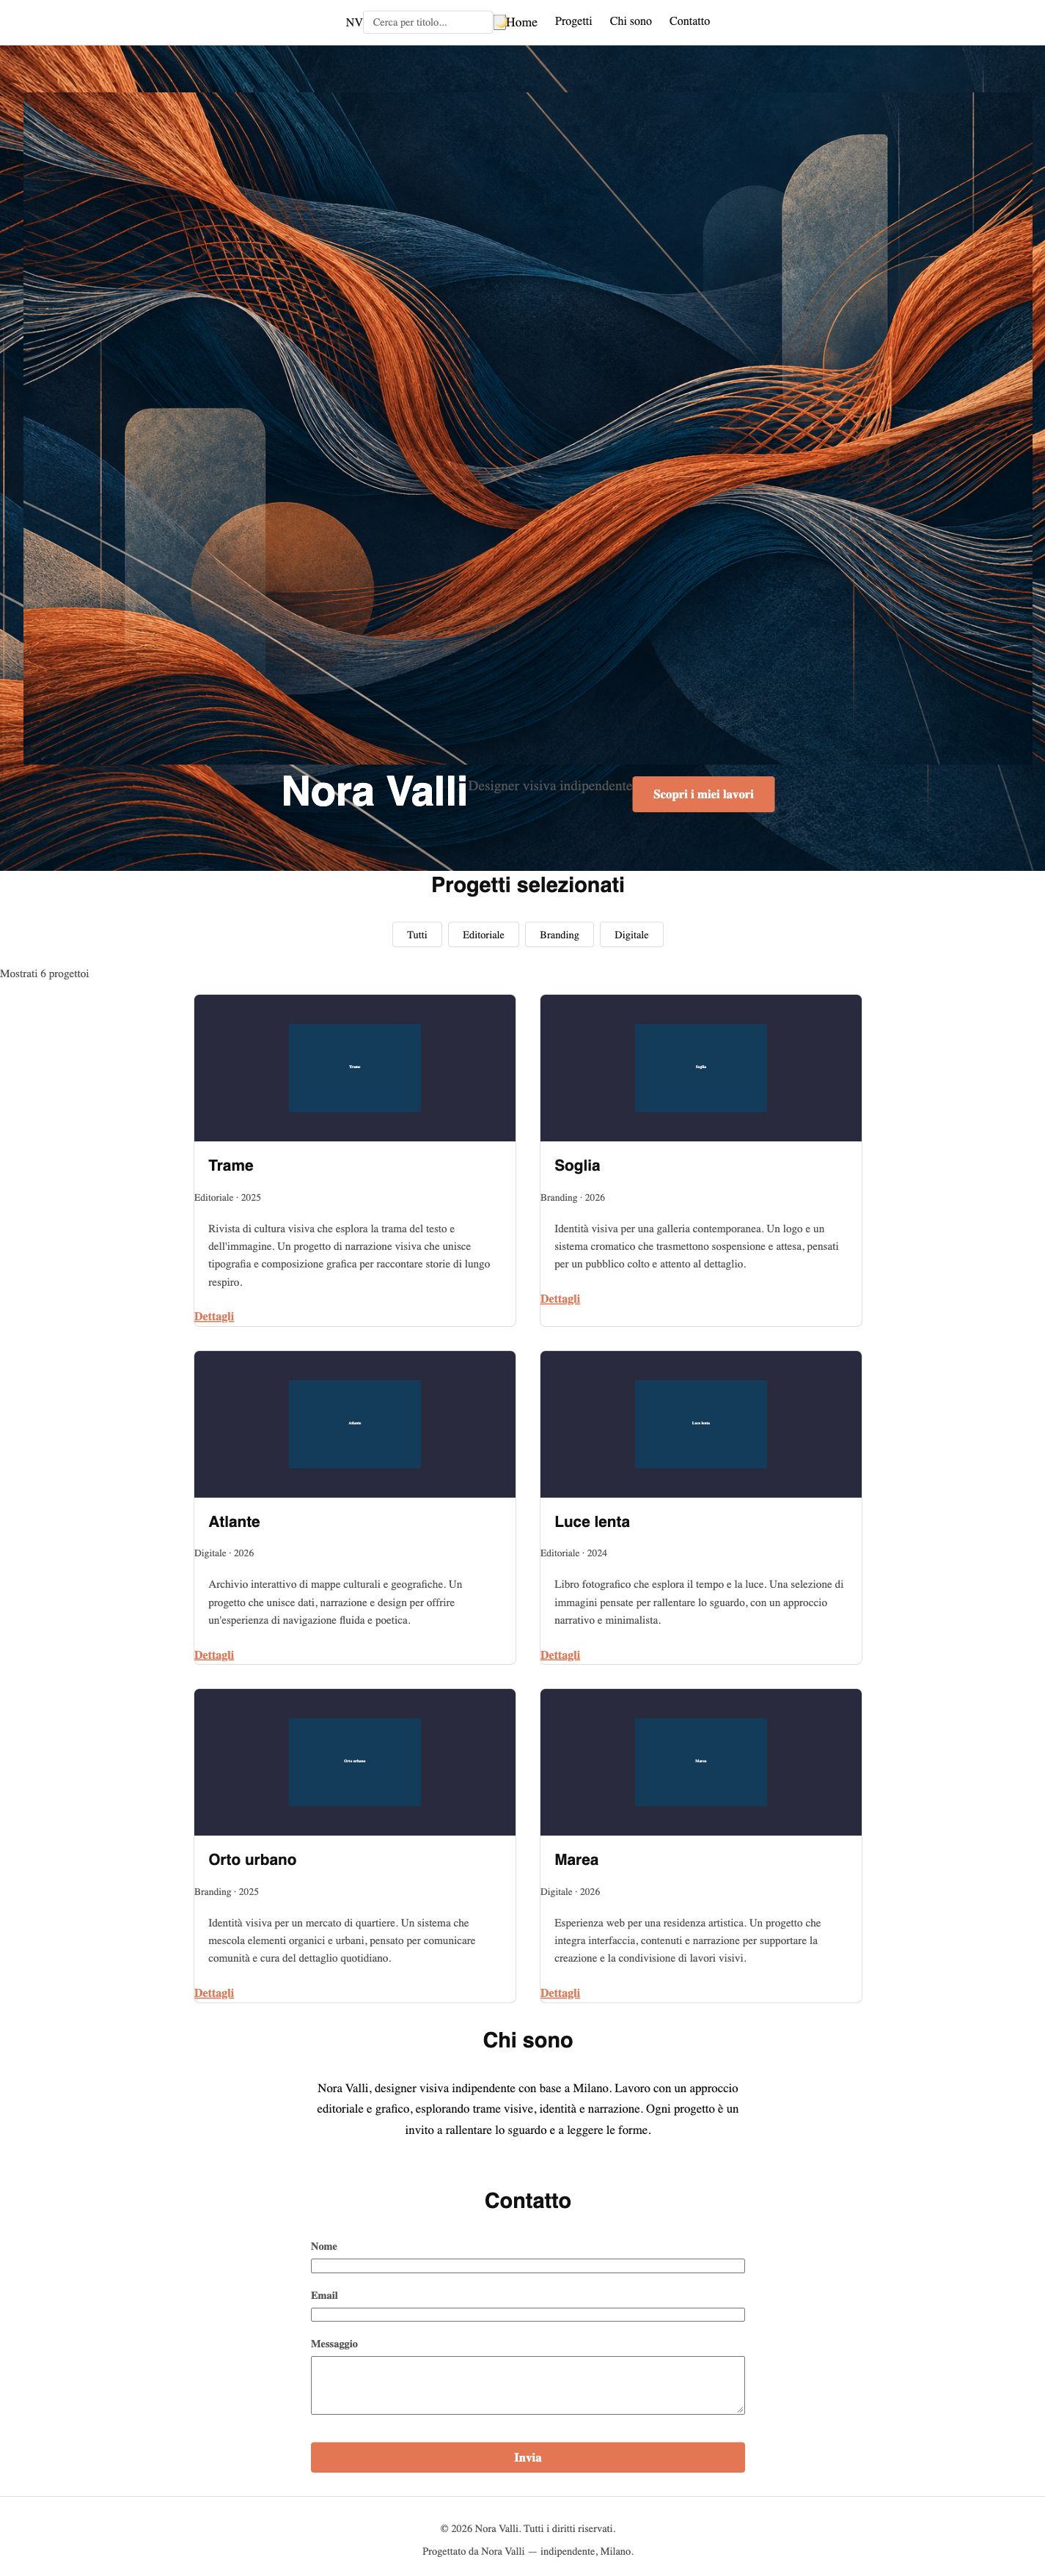
Dans mon jugement final, Qwen est le résultat esthétique que je préfère, Ornith est très bon, LFM ne me convainc pas. Son 10/10 ne change pas ce choix. Le nombre compte des contrôles fonctionnels définis avant les corrections et précisés pendant l’audit : ce n’est pas une note globale de web design.
Des défauts hors du périmètre de la suite subsistent. Le texte alternatif final de l’image LFM est générique. Les attributs HTML de Qwen doivent être revus. Les phrases des formulaires et compteurs demandent une révision éditoriale. Un site prêt pour d’autres utilisateurs nécessiterait d’autres contrôles.
Le temps enregistré et le travail absent du compte
| Configuration | Première version | Correction | Total | Sortie enregistrée pendant les corrections |
|---|---|---|---|---|
| Qwen | 1656,4 s | 2470,1 s | 4126,6 s | au moins 7581 tokens |
| Ornith | 505,3 s | 48,2 s | 553,4 s | 873 tokens |
| LFM | 161,3 s | 2070,6 s | 2232,0 s | 139 532 tokens |
Les durées sont mesurées par le programme qui lance et termine chaque exécution, appelé runner. Elles comprennent démarrage, attentes serveur, travail de l’agent et nettoyage final. Ce n’est pas le seul temps GPU, et tout le travail de coordination et d’évaluation n’est pas inclus. Les temps de requête comprennent traitement du contexte, génération et communication locale ; ils chevauchent ceux du runner : les additionner compterait deux fois.
Qwen présente des timeouts et une requête interrompue sans décompte final des tokens. Les tokens enregistrés sont donc une borne inférieure, pour la baseline comme les corrections. Pendant les corrections, nouveaux inputs et lectures du cache valent respectivement 849 146 et zéro pour Qwen, 18 149 et 76 388 pour Ornith, 863 073 et 1 108 820 pour LFM. Ce sont des comptes répétés par requête, pas des corpus de mots uniques. Tokeniseurs et backends diffèrent.
La mesure API des tokens de reasoning séparés est indisponible, notée NA. Le zéro normalisé dans les enregistrements Pi ne prouve pas une absence de raisonnement. Pour LFM, 84 blocs thinking émis sont conservés ; leur texte a été retokenisé en 87 101 tokens : une mesure dérivée d’une partie de la sortie, à ne pas additionner au total ni qualifier d’accès à la pensée interne. Il n’existe pas de mesure fiable des secondes consacrées au reasoning.
Les tokens du coordinateur et le coût du générateur d’images n’ont pas non plus été mesurés. Je n’en déduis aucun coût économique, énergétique ou total du système.
Après l’essai, j’ai désinstallé LFM : environ 13,59 Go de poids et fichiers de lancement supprimés. Les archives de l’expérience restent intactes.
Ce qui rend cet essai vérifiable
À la fin, la même suite figée a été réexécutée sur les 19 versions conservées : trois baselines et seize corrections. Les 190 verdicts individuels correspondent aux scores canoniques. Cette réévaluation contrôle la cohérence des artefacts après correction de l’évaluateur ; elle n’ajoute aucune réplication d’inférence.
Le protocole de correction a été écrit après observation des baselines. Les adaptations sont consignées dans les rectifications. L’ordre n’était pas randomisé ; les bugs initiaux différaient ; les aides sont devenues très différentes, surtout pour LFM. Cache, backends et activité système n’étaient ni identiques ni isolés. Le coordinateur opérationnel était une IA, pas un juge humain indépendant. Le jugement esthétique ultérieur est le mien.
Avec une trajectoire par checkpoint et un seul portfolio, les données décrivent un cas. Elles ne permettent ni classement universel, ni estimation statistique des chances de réussite, ni explication causale de l’effet du thinking. Les tests étaient connus et les retours les concernaient : atteindre dix sur dix mesure la correction de cette tâche.
J’en retiens un critère concret pour mon travail : vérifier les gestes promis, observer la page même après le score et compter l’aide nécessaire pour y arriver. La décision d’utiliser un résultat reste ouverte au jugement de celles et ceux qui l’utiliseront.
Données, sources et provenance
- Données par itération, CSV, résultats JSON et résumé JSON.
- Protocole de correction, à lire avec les rectifications, les rôles et le jugement esthétique.
- Index des preuves et actions, URL et viewports des captures éditoriales. Les vérifications historiques figurent dans le paquet de documents ; ce ne sont pas de nouvelles inférences. Certains signes périphériques appartiennent au navigateur ou aux extensions.
- Qwen, dépôt à la révision testée, Ornith, même identification fixée, LFM, fiche de quantification.
Le paquet public réunit données, documents de méthode, contrôles et images sélectionnés. Le manifest SHA256 permet de vérifier les fichiers téléchargés. Les chemins et URL locaux ont été retirés des copies ; les images raster originales restent sans retouche. Le jugement esthétique ultérieur reste distinct des scores fonctionnels.